Cómo monitorizar recursos del servidor y Docker: CPU, memoria y disco
Aprende a monitorizar los recursos del servidor (CPU, memoria, disco, red) y los contenedores Docker con Beszel, Netdata, Dozzle y Prometheus. Comparativa de herramientas autoalojadas gratuitas.

Actualizado Publicado 28 min de lectura
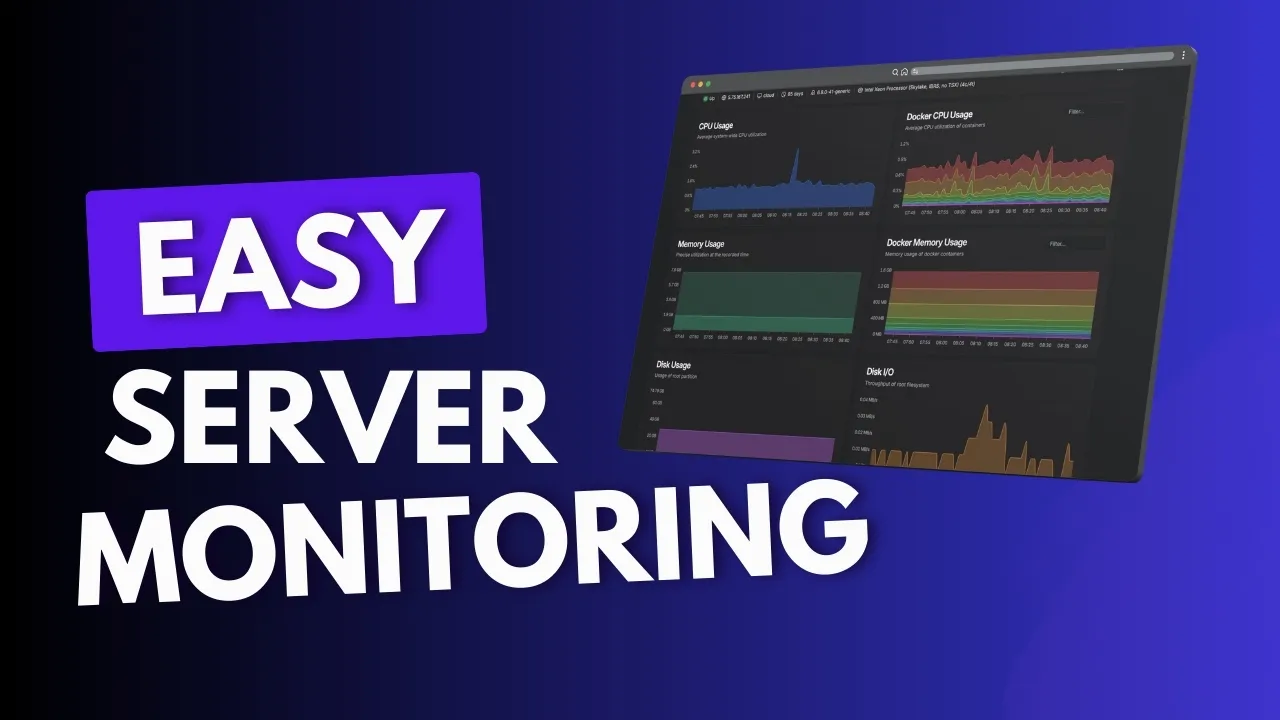
Si ejecutas Docker en un VPS, necesitas saber cuándo la CPU se dispara, el disco se llena o un contenedor muere, antes de que lo noten tus usuarios. La monitorización de servidores es el proceso sistemático de seguir la utilización de recursos, la salud de los contenedores y la disponibilidad de los servicios para detectar los problemas a tiempo. Esta guía compara cuatro herramientas de monitorización gratuitas y autoalojadas (Beszel, Netdata, Dozzle y Prometheus/Grafana), añade Uptime Kuma para las comprobaciones de disponibilidad y te da un stack predeterminado claro para 1–20 servidores. Tanto si ejecutas contenedores Docker para tu servidor doméstico como si gestionas cargas de producción en VPS baratos, el stack de monitorización que elijas importa.
Selección rápida: ¿qué herramienta de monitorización deberías usar?
TL;DR
Para el 90 % de los autoalojadores con 1–20 servidores, despliega Beszel (métricas) + Dozzle (logs) + Uptime Kuma (disponibilidad). Sobrecarga total de RAM: ~50–80 MB. Puedes tener todo el stack funcionando esta misma noche.
Si necesitas resolución por segundo y detección de anomalías con IA, elige Netdata, pero reserva 200-500 MB de RAM.
Si gestionas una organización con más de 50 objetivos y dashboards PromQL personalizados, usa Prometheus + Grafana, pero reserva más de 1 GB de RAM y un fin de semana para la configuración.
Necesitas Beszel si quieres:
- Un panel de monitorización que funciona en 5 minutos con ~10–25 MB de RAM
- Estadísticas de contenedores Docker integradas, monitorización de GPU y salud de disco S.M.A.R.T.
- Inicio de sesión OAuth/OIDC y copias de seguridad automáticas en S3
Necesitas Netdata si quieres:
- Recolección de métricas por segundo con más de 800 integraciones
- Detección de anomalías con IA y análisis del radio de impacto
- Depuración profunda de producción a las 3 de la madrugada
Necesitas Prometheus + Grafana si quieres:
- Dashboards PromQL personalizados y almacenamiento de métricas a largo plazo
- Alertas de nivel empresarial con Alertmanager
- Observabilidad multiequipo con acceso basado en roles
Esto es lo que cada herramienta te cuesta realmente en RAM en un VPS:
| Herramienta | RAM (en reposo) | Ideal para |
|---|---|---|
| Agente de Beszel | ~10–15 MB | Cada servidor |
| Hub de Beszel | ~12 MB | Panel central |
| Dozzle | ~10–18 MB | Visualización de logs + alertas |
| Uptime Kuma | ~30–50 MB | Disponibilidad HTTP/TCP |
| Netdata | 200–500 MB | Métricas profundas, IA |
| Prometheus + Grafana | 500 MB–1 GB+ | Observabilidad empresarial |
Compara estas cifras con los paneles de gestión de servidores autoalojados para planificar tu presupuesto total de recursos.
Áreas clave en la monitorización de servidores
Una monitorización de servidores eficaz sigue cuatro dominios de recursos. Las herramientas de este artículo los cubren todos.
| Tipo de métrica | Servidor tradicional | Entorno de contenedores | Infraestructura cloud |
|---|---|---|---|
| CPU | Uso general | Uso por contenedor | Utilización de la instancia |
| Memoria | Física/Swap | Límites del contenedor | Límites de la instancia |
| Almacenamiento | Uso de particiones | Uso de volúmenes | Almacenamiento en bloque |
| Red | Estadísticas de la interfaz | Redes de contenedores | Métricas de VPC |
Antes de desplegar nada, conviene hacer un benchmark de tu servidor cloud para conocer tu línea base.
Monitorización de CPU
- Medias de carga (1, 5, 15 minutos)
- Utilización por núcleo
- Consumo de CPU por proceso
- División de tiempo sistema/usuario
Para profundizar en las alertas de CPU, consulta cómo monitorizar el uso de CPU con alertas.
Monitorización de memoria
- RAM disponible y uso de swap
- Utilización de búfer/caché
- Consumo de memoria por proceso
- Eventos de OOM kill (Dozzle puede alertar sobre ellos)
Monitorización de disco y sistema de archivos
- Uso de espacio en disco (porcentaje y absoluto)
- Utilización de inodos
- Operaciones de lectura/escritura y tiempos de espera de E/S
- Salud de disco S.M.A.R.T. con alertas de fallo (Beszel v0.17+)
El disco se llena rápido con imágenes Docker y logs. Si te estás quedando sin espacio, limpia el uso de disco de Docker para recuperar espacio.
Monitorización de red
- Utilización de ancho de banda por interfaz
- Pérdida de paquetes y latencia
- Estados de conexión y recuento de sockets
- Estadísticas de red a nivel de contenedor
La importancia de recibir notificaciones
Las alertas proactivas marcan la diferencia entre detectar un problema con el disco al 90 % y despertarte con un servidor muerto al 100 %. Todas las herramientas de este artículo admiten notificaciones:
- Beszel: ntfy, correo electrónico, webhook, Telegram, Gotify
- Netdata: más de 90 canales de notificación, incluidos Slack, Discord y PagerDuty
- Dozzle: entrega por webhook a Slack, Discord, ntfy o endpoints personalizados
- Prometheus: Alertmanager con enrutamiento multicanal
Los principios clave siguen aplicándose:
- Aviso temprano. Detecta los problemas antes de que se vuelvan críticos. Monitoriza los cambios de tendencia, no solo los umbrales.
- Respuesta rápida. Envía notificaciones con información de diagnóstico y acciones claras.
- Evita la fatiga de alertas. Usa umbrales inteligentes, correlación y prioridades adecuadas. Si todo es crítico, nada lo es.
Patrón de enrutamiento de alertas
En lugar de conectar cada herramienta de monitorización al correo por separado, enruta todas las alertas a través de un único servidor de notificaciones como ntfy o Gotify. Todas las herramientas de este artículo admiten entrega por webhook. Apunta todas al mismo endpoint y luego gestiona las suscripciones desde un solo lugar. Un único destino de webhook que mantener, un solo lugar donde silenciar a las 3 de la madrugada.
Monitorización de métricas: sigue CPU, memoria, disco y red
Esta sección cubre las herramientas que vigilan los recursos del sistema. Las métricas te dicen qué está pasando (CPU al 95 %, memoria agotada, disco llenándose). La sección de monitorización de logs de más abajo cubre por qué está pasando (mensajes de error, trazas de pila, bucles de reinicio).
Beszel: monitorización ligera de servidor y Docker
Beszel es el punto de partida recomendado para la mayoría de los lectores. Usa ~10-25 MB de RAM en total, se despliega en 5 minutos y ahora incluye monitorización de GPU, salud de disco S.M.A.R.T., monitorización de servicios systemd y OAuth/OIDC. Versión 0.18.7, más de 22.700 estrellas en GitHub, licencia MIT.
Beszel es un hub de monitorización ligero con agentes que reportan vía SSH o tokens universales. Está diseñado para flotas pequeñas y medianas, el tipo de configuración en la que tienes 1-20 VPS y quieres un panel limpio sin la sobrecarga de Netdata o Prometheus.
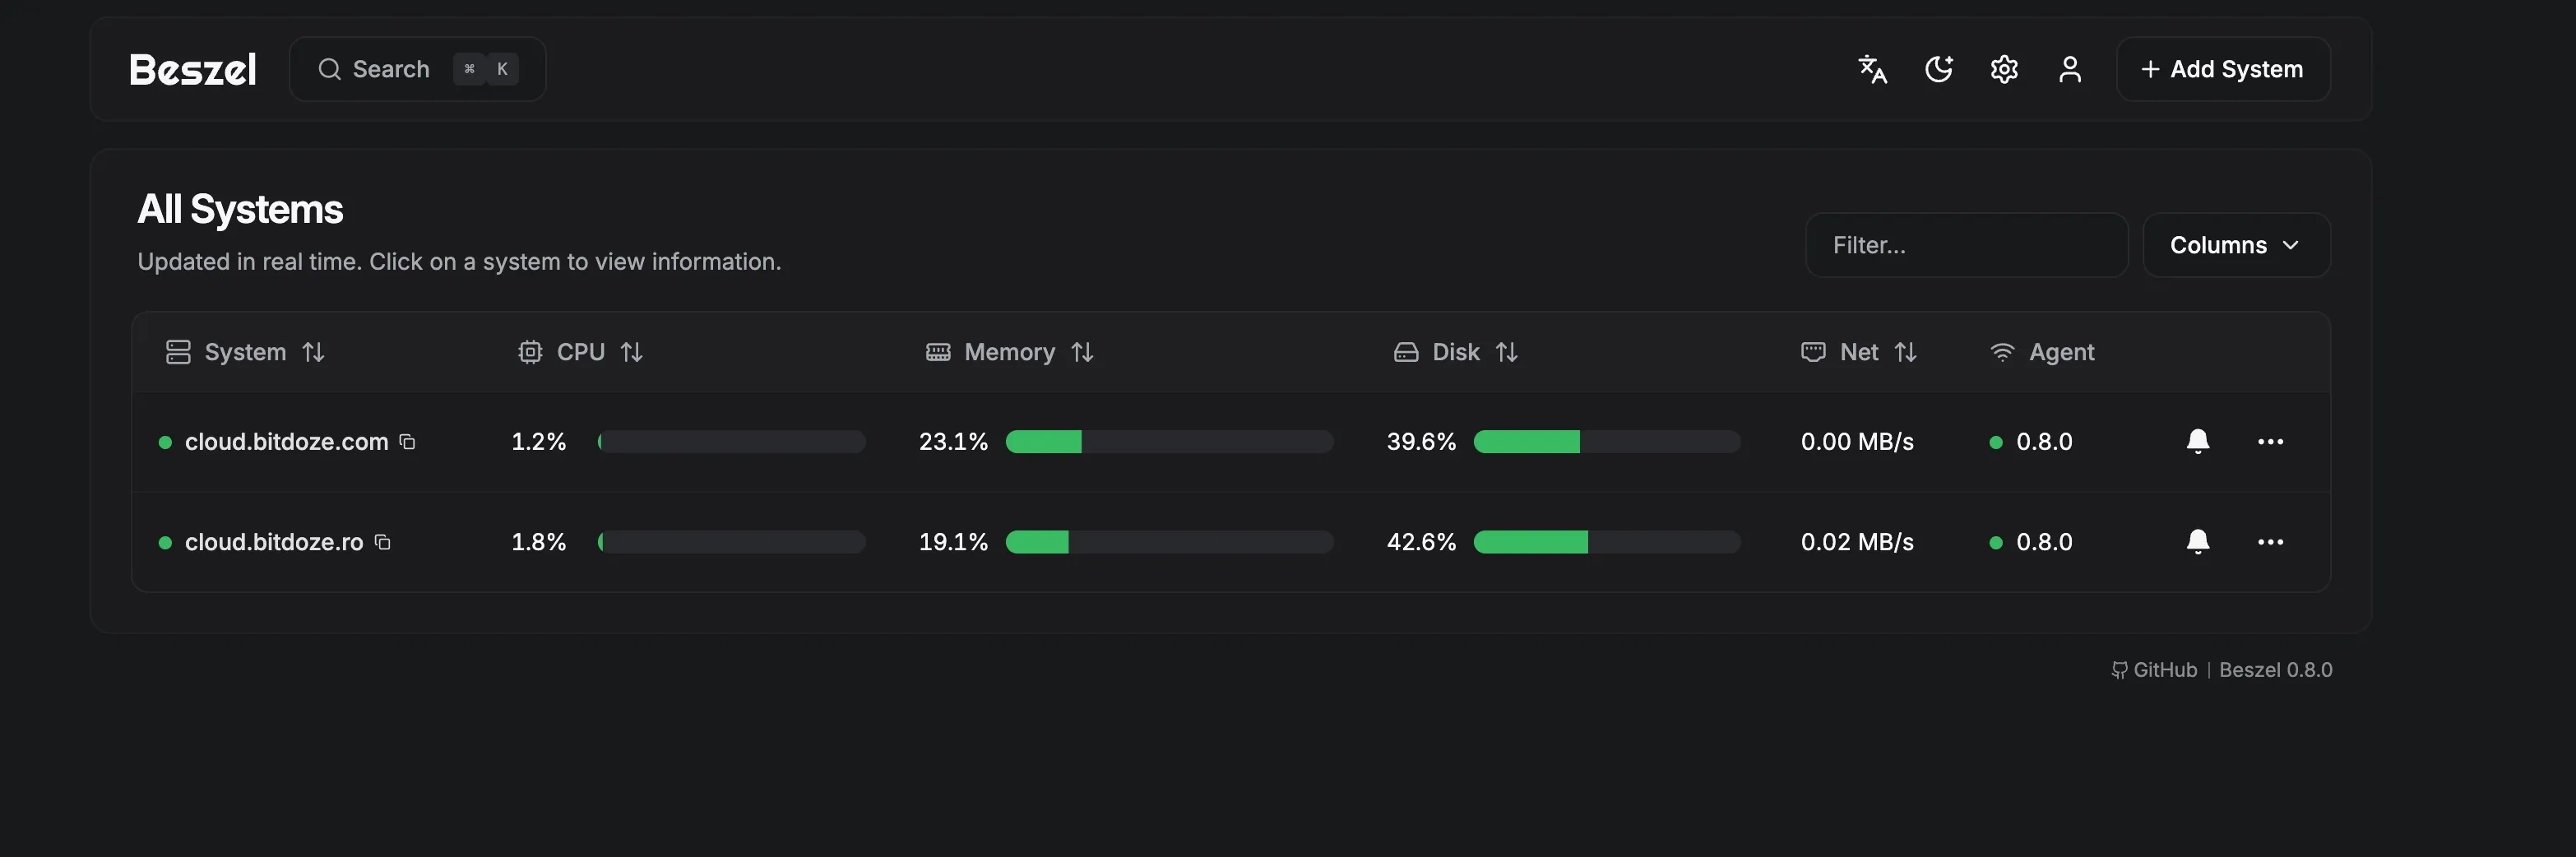
Interfaz principal de Beszel:
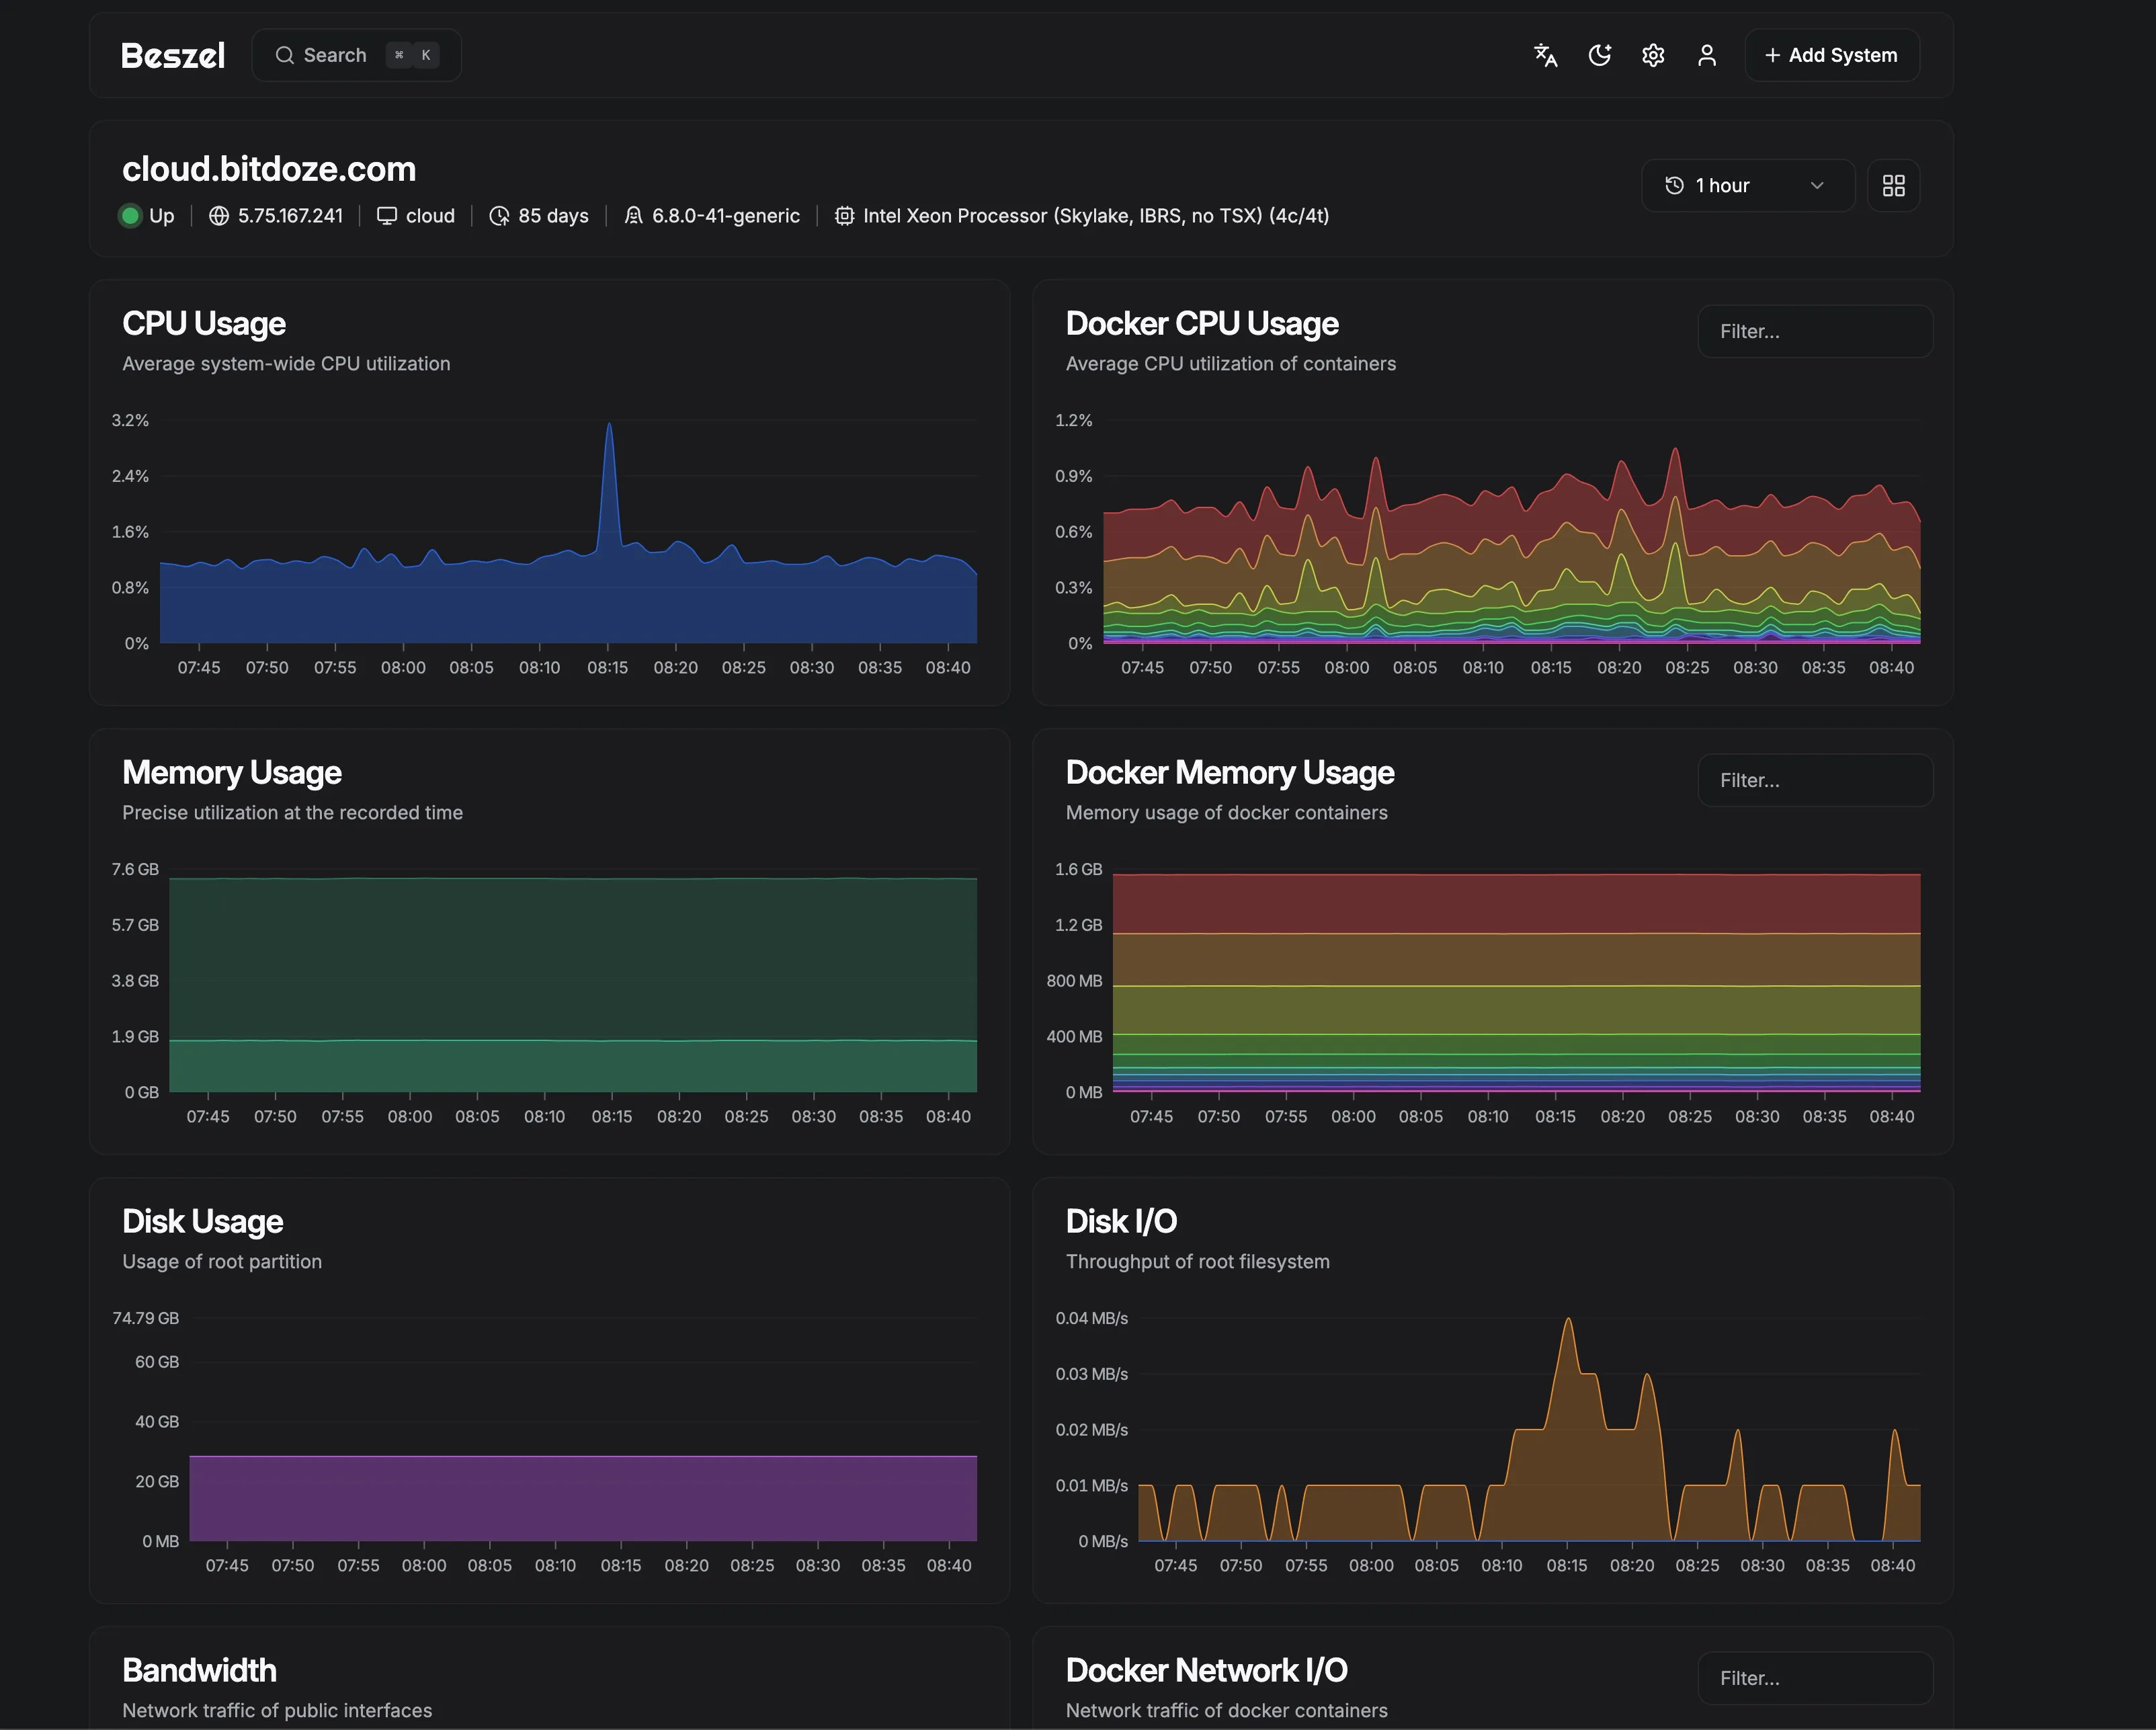
Gráficos de Beszel:
Funciones clave de Beszel (v0.18)
Novedades desde el artículo original:
- Tokens universales (v0.12+). Crea un token en
/settings/tokensy olvídate de configurar claves por sistema. Esto simplifica significativamente el despliegue multiservidor. - OAuth2/OIDC. Inicia sesión con Google, GitHub, Authentik o Authelia. La autenticación por contraseña se puede desactivar por completo.
- Monitorización de discos S.M.A.R.T. con alertas de fallo. Detecta un disco agonizante antes de que se lleve tus datos.
- Monitorización de GPU. NVIDIA (NVML/nvtop), AMD, Intel, Apple Silicon experimental.
- Monitorización de servicios systemd. Ve qué servicios están en ejecución y recibe alertas ante fallos.
- Copias de seguridad automáticas en disco o almacenamiento compatible con S3.
- Multiusuario con roles de administrador y de solo lectura.
TOKEN (recomendado)
Desde v0.12.0, los tokens universales son el método de autenticación recomendado. Creas un token en la UI del hub y lo pegas en la configuración del agente. Sin malabares con claves SSH.
services:
  beszel-agent:
    image: henrygd/beszel-agent:latest
    container_name: beszel-agent
    restart: unless-stopped
    network_mode: host
    volumes:
      - /var/run/docker.sock:/var/run/docker.sock:ro
    environment:
      PORT: 45876
      TOKEN: "your-universal-token-from-hub"
KEY (legado)
La autenticación original basada en claves SSH sigue funcionando. Genera un par de claves ed25519, pega la clave pública en el hub y la privada en la configuración del agente.
services:
  beszel-agent:
    image: henrygd/beszel-agent:latest
    container_name: beszel-agent
    restart: unless-stopped
    network_mode: host
    volumes:
      - /var/run/docker.sock:/var/run/docker.sock:ro
    environment:
      PORT: 45876
      KEY: "ssh-ed25519 AAAAC3..."
Despliega el hub de Beszel con Docker Compose
services:
  beszel:
    image: henrygd/beszel:latest
    container_name: beszel
    restart: unless-stopped
    environment:
      APP_URL: http://localhost:8090   # change to your domain in production
    ports:
      - 8090:8090
    volumes:
      - ./beszel_data:/beszel_data
Guárdalo como docker-compose.yml y luego:
mkdir -p beszel && cd beszel
# paste the compose file above
docker compose up -d
Verifica: Abre http://your-ip:8090. Debería aparecer el asistente de configuración. Crea tu cuenta de administrador. Si ves una página en blanco, comprueba que APP_URL coincide con tu URL de acceso.
Ejecuta el hub en otra máquina
Si tu único servidor cae, tu monitorización cae con él. El hub de Beszel usa ~12 MB de RAM — lo bastante barato como para ejecutarlo en un VPS de Hetzner aparte (CX22 por ~4 €/mes) o un VPS de Hostinger. Incluso una Raspberry Pi sirve. El agente se queda en tus servidores de producción; el hub vive en otro lugar.
Los precios de los VPS subieron en todos los proveedores en 2026 — si estás reconsiderando una máquina alquilada, mira qué cambió y cuándo gana un mini PC.
Despliega el agente de Beszel con Docker Compose
En cada servidor monitorizado:
services:
  beszel-agent:
    image: henrygd/beszel-agent:latest
    container_name: beszel-agent
    restart: unless-stopped
    network_mode: host
    volumes:
      - /var/run/docker.sock:/var/run/docker.sock:ro
      # monitor other disks/partitions by mounting into /extra-filesystems
      # - /mnt/disk/.beszel:/extra-filesystems/sda1:ro
    environment:
      PORT: 45876
      TOKEN: "your-universal-token-from-hub"
Para obtener tu token: en la UI del hub de Beszel, ve a Settings → Tokens, crea un nuevo token universal y pégalo en la variable de entorno TOKEN del agente.
Verifica: La fila del sistema debería ponerse en verde en la UI del hub en 30 segundos. Si está en rojo, revisa docker logs beszel-agent en busca de errores de conexión.
El agente de Beszel aparece en rojo — soluciones habituales
TOKEN o KEY incorrectos: Regenera el token en el hub y actualiza el compose del agente. Reinicia el agente. El firewall bloquea el puerto 45876: El hub se conecta al agente en el puerto 45876. Asegúrate de que tu firewall permite TCP entrante en ese puerto desde la IP del hub:
sudo ufw allow from HUB_IP to any port 45876El agente no está en ejecución: Comprueba docker ps | grep beszel-agent. Si no aparece, revisa docker logs beszel-agent en busca de errores de arranque.
Permisos del socket de Docker: Asegúrate de que /var/run/docker.sock es legible. El montaje :ro es suficiente — el agente solo lee estadísticas, no controla contenedores.
El hub muestra 'connection refused'
APP_URL no coincide: La variable de entorno APP_URL debe coincidir con la forma en que accedes al hub. Si usas http://localhost:8090 pero accedes mediante un dominio de proxy inverso, actualiza APP_URL al dominio.
Puerto no expuesto: Verifica con docker port beszel que el 8090 está mapeado.
Configuración incorrecta del proxy inverso: Si está detrás de Caddy/Nginx/Traefik, asegúrate de que el proxy pasa la cabecera Host y reenvía al puerto 8090.
Notas de operación:
- Copia de seguridad: El directorio
/beszel_datacontiene toda la configuración y el historial. Hazle una copia de seguridad o configura la copia en S3 en los ajustes del hub. - Actualizaciones:
docker compose pull && docker compose up -d— el hub y el agente de Beszel se actualizan de forma independiente. - Mira cómo combinar Beszel con Uptime Kuma para la configuración completa con Dokploy.
Netdata: monitorización profunda de servidores en tiempo real
Netdata te da más de 2.000 métricas con resolución de 1 segundo y detección de anomalías con IA. Esa profundidad cuesta 200–500 MB de RAM. Para «¿está bien mi CPU?», es excesivo. Para depurar un incidente de producción a las 3 de la madrugada con granularidad por segundo, vale cada mega.
Versión 2.10.4 (julio de 2026), más de 79.600 estrellas en GitHub, GPL-3.0+.
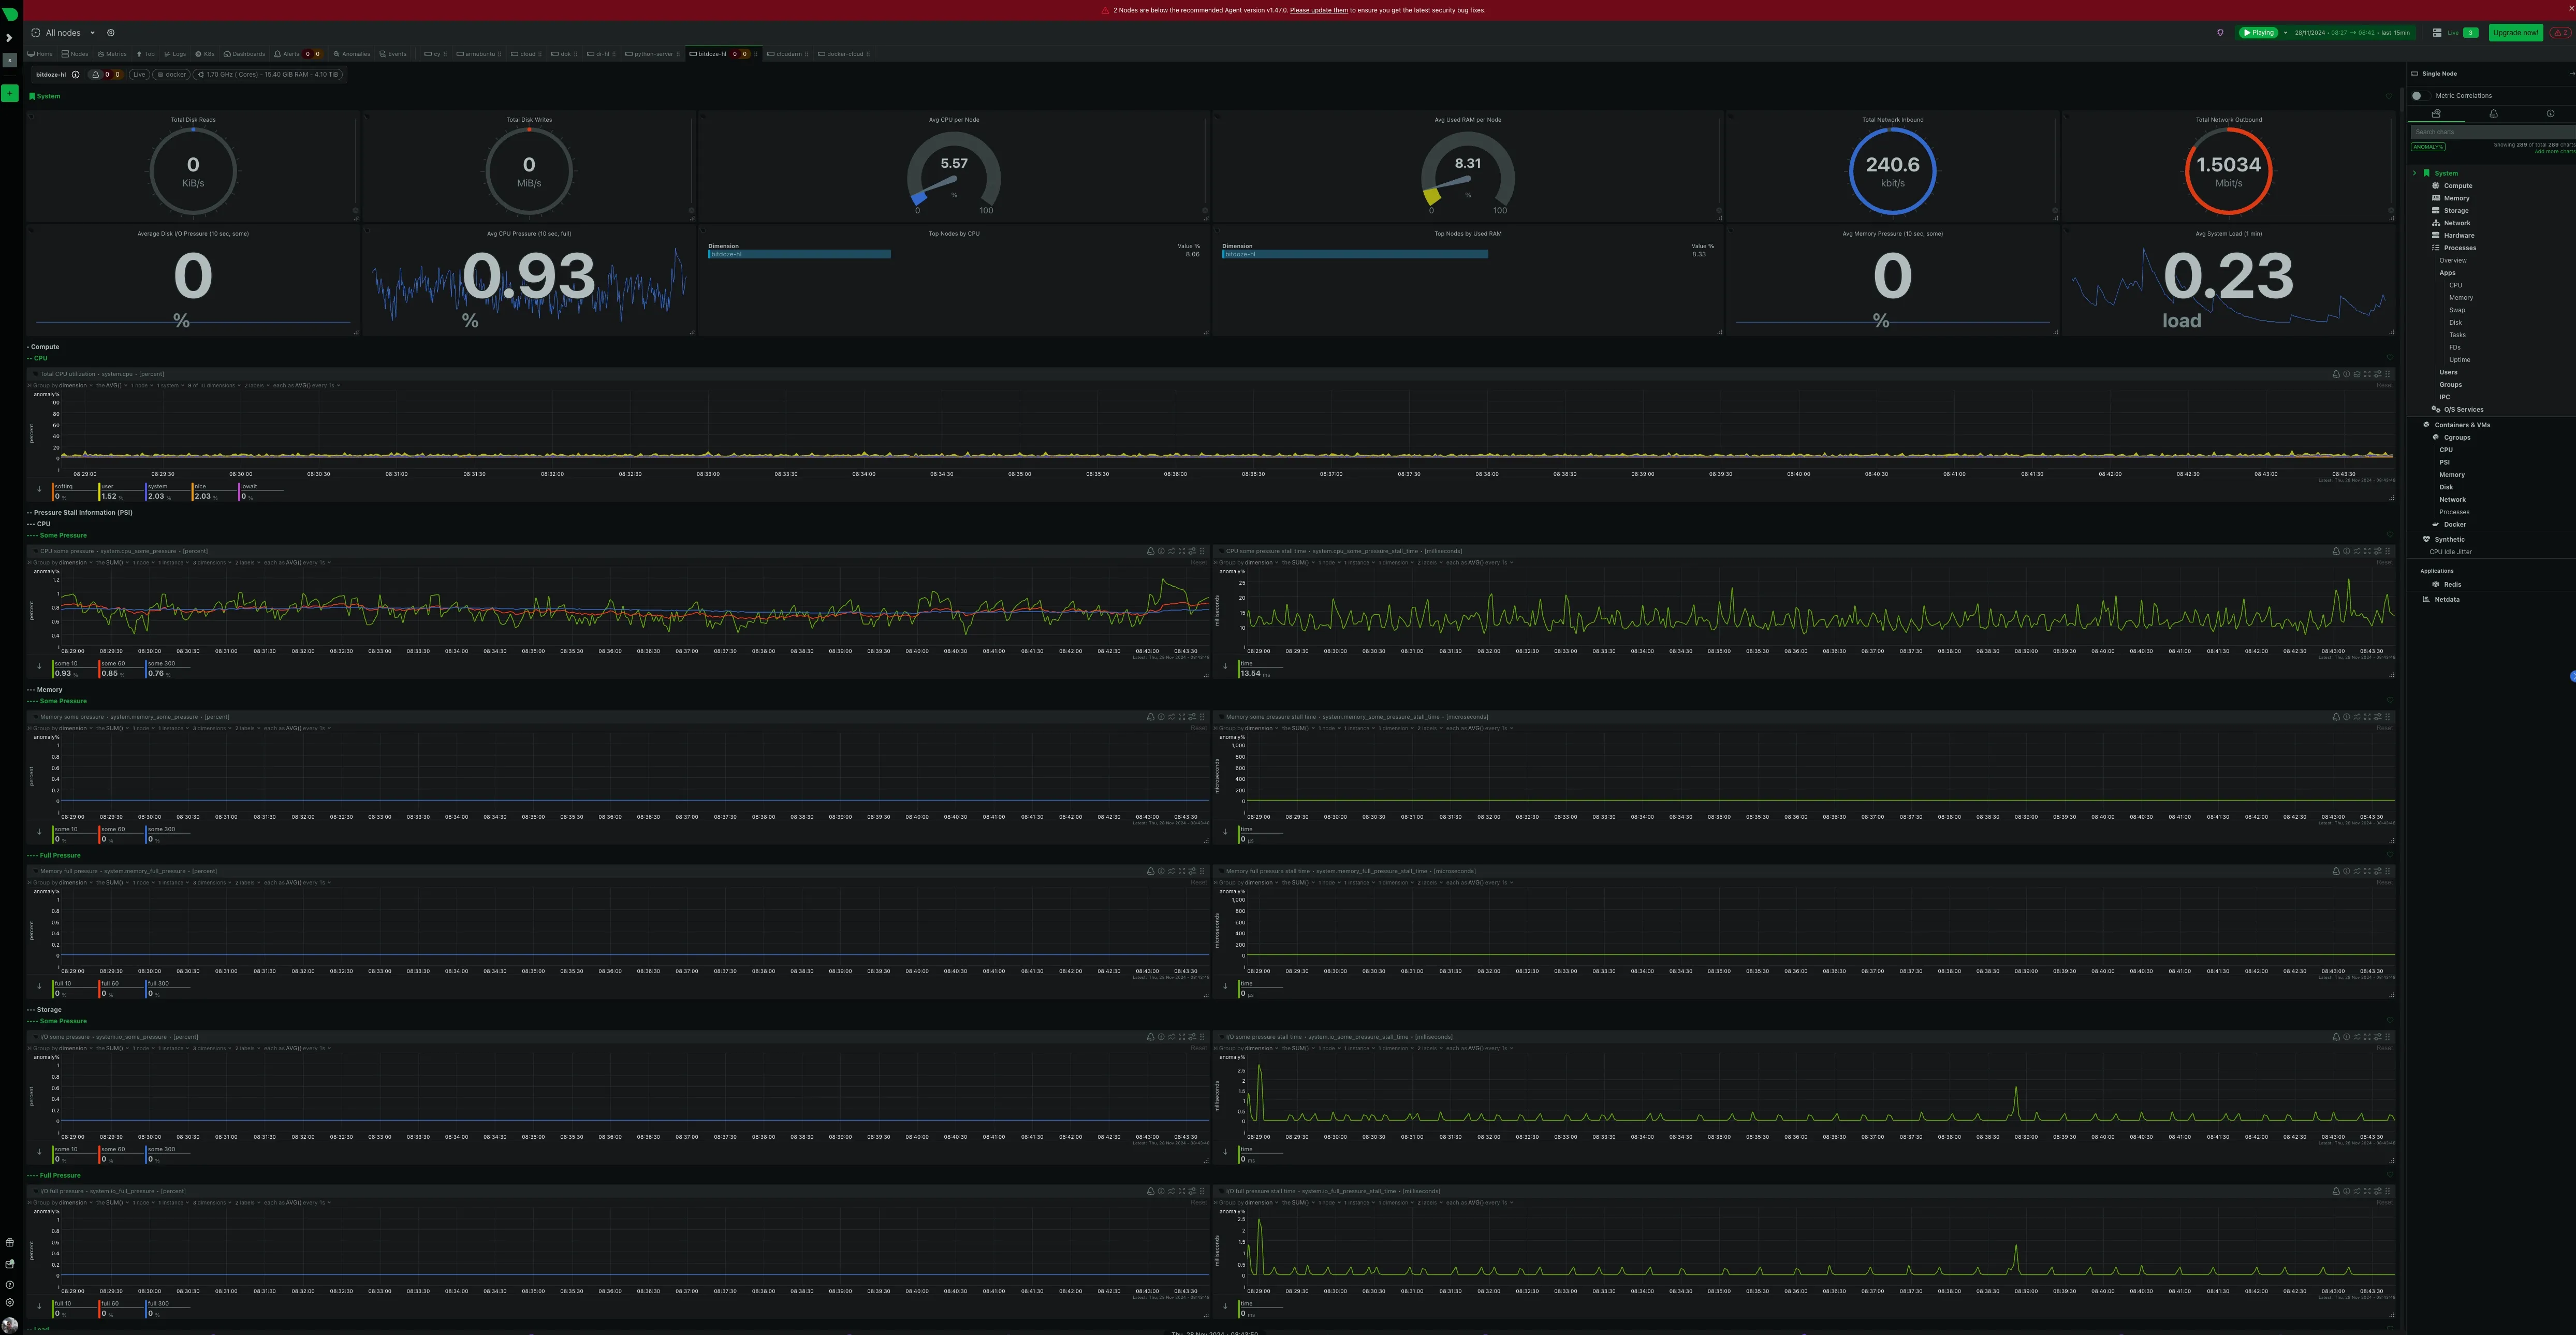
Funciones clave de Netdata (v2.10)
- Más de 800 integraciones con autodetección — Netdata descubre lo que se está ejecutando y empieza a recolectar métricas sin configuración.
- AI Co-Engineer — chat de IA integrado, informes con IA y detección del radio de impacto. El agente lleva incorporada detección de anomalías con autoaprendizaje.
- Recolección de métricas por segundo — ninguna otra herramienta gratuita iguala esta granularidad.
- Streaming entre padres + clúster HA — escala a miles de nodos con arquitectura padre-hijo.
- Configuración de alertas desde la UI — define alertas en el panel de Cloud, no solo en archivos de configuración. Incluye silenciado de alertas, reglas de recurrencia y acuse de recibo.
Precios de Netdata: Community vs Homelab vs Business
La antigua división «Community vs Cloud» ya no existe. Niveles actuales (agosto de 2026):
| Plan | Precio | Nodos | Dashboards personalizados | Retención |
|---|---|---|---|---|
| Community | Gratis | 5 | 1 | 3 GB de disco, >1 año |
| Homelab | 90 $/año | Ilimitados | Ilimitados | Uso razonable |
| Business | 4,50 $/nodo/mes | Ilimitados | Ilimitados | Completa |
| Enterprise On-Premise | Contactar con ventas | Ilimitados | Ilimitados | Completa |
Si tienes más de 5 servidores, el plan Homelab a 90 $/año es el punto dulce. Nodos ilimitados con uso razonable — este es el nivel pensado para los autoalojadores. El plan Community gratuito (5 nodos, 1 dashboard personalizado, 3 GB de disco / retención >1 año) basta para evaluarlo.
Comparativa: alternativas SaaS como Datadog cobran 15–18 $/host/mes. Autoalojar Netdata es gratis; el plan Cloud añade dashboards multinodo y funciones de IA.
Despliega Netdata con Docker
services:
  netdata:
    image: netdata/netdata:stable
    container_name: netdata
    restart: unless-stopped
    pid: host
    network_mode: host
    cap_add:
      - SYS_PTRACE
      - SYS_ADMIN
    security_opt:
      - apparmor:unconfined
    volumes:
      - netdataconfig:/etc/netdata
      - netdatalib:/var/lib/netdata
      - netdatacache:/var/cache/netdata
      - /etc/passwd:/host/etc/passwd:ro
      - /etc/group:/host/etc/group:ro
      - /etc/localtime:/etc/localtime:ro
      - /proc:/host/proc:ro
      - /sys:/host/sys:ro
      - /var/run/docker.sock:/var/run/docker.sock:ro
    environment:
      - NETDATA_CLAIM_TOKEN=your-cloud-token  # optional: connect to Netdata Cloud

volumes:
  netdataconfig:
  netdatalib:
  netdatacache:
Verifica: Accede a http://your-ip:19999 — el panel debería llenarse de métricas en directo en segundos. Si ves una página vacía, revisa el montaje del socket de Docker y el modo de red.
El agente de Netdata no se conecta a Cloud
Token incorrecto: Regenera el claim token desde Netdata Cloud y actualiza la variable de entorno NETDATA_CLAIM_TOKEN.
Salida de red bloqueada: Netdata Cloud requiere HTTPS saliente hacia app.netdata.cloud. Revisa las reglas de tu firewall.
Firewall: Si no usas Cloud, accede al agente directamente en el puerto 19999 — no hace falta conexión saliente.
Consumo alto de RAM en un VPS pequeño
En un VPS de 1 GB, Netdata por sí solo puede ocupar 200–500 MB — eso es el 20–50 % de tu RAM total. Verifícalo con docker stats antes de comprometerte.
Para reducir la memoria:
- Desactiva los colectores que no uses en
/etc/netdata/netdata.conf - Reduce los períodos de retención de métricas
- Si no necesitas resolución por segundo, considera cambiar a Beszel (~10–15 MB)
Notas de operación:
- En un VPS de 1 GB, Netdata por sí solo ocupa el 20–50 % de la RAM — verifícalo con
docker statsantes de ponerlo junto a otros servicios. - Copia de seguridad:
/etc/netdatapara la configuración,/var/cache/netdatapara los datos históricos. - Actualizaciones:
docker compose pull && docker compose up -d
Prometheus y Grafana: monitorización de servidores empresarial
Advertencia de recursos
El stack completo de Prometheus + Grafana necesita 500 MB–1 GB+ de RAM. No lo ejecutes en un VPS de 1 GB junto a tus aplicaciones. Esto es para nodos de monitorización dedicados u organizaciones con presupuestos de infraestructura reales.
Prometheus se encarga de la recolección y el almacenamiento de métricas. Grafana aporta la visualización y las alertas. Juntos son el estándar del sector para la monitorización empresarial — PromQL para las consultas, Alertmanager para el enrutamiento y dashboards personalizados para todo. Prometheus 3.x (noviembre de 2024) y Grafana 12.x (mayo de 2025) son las versiones actuales.
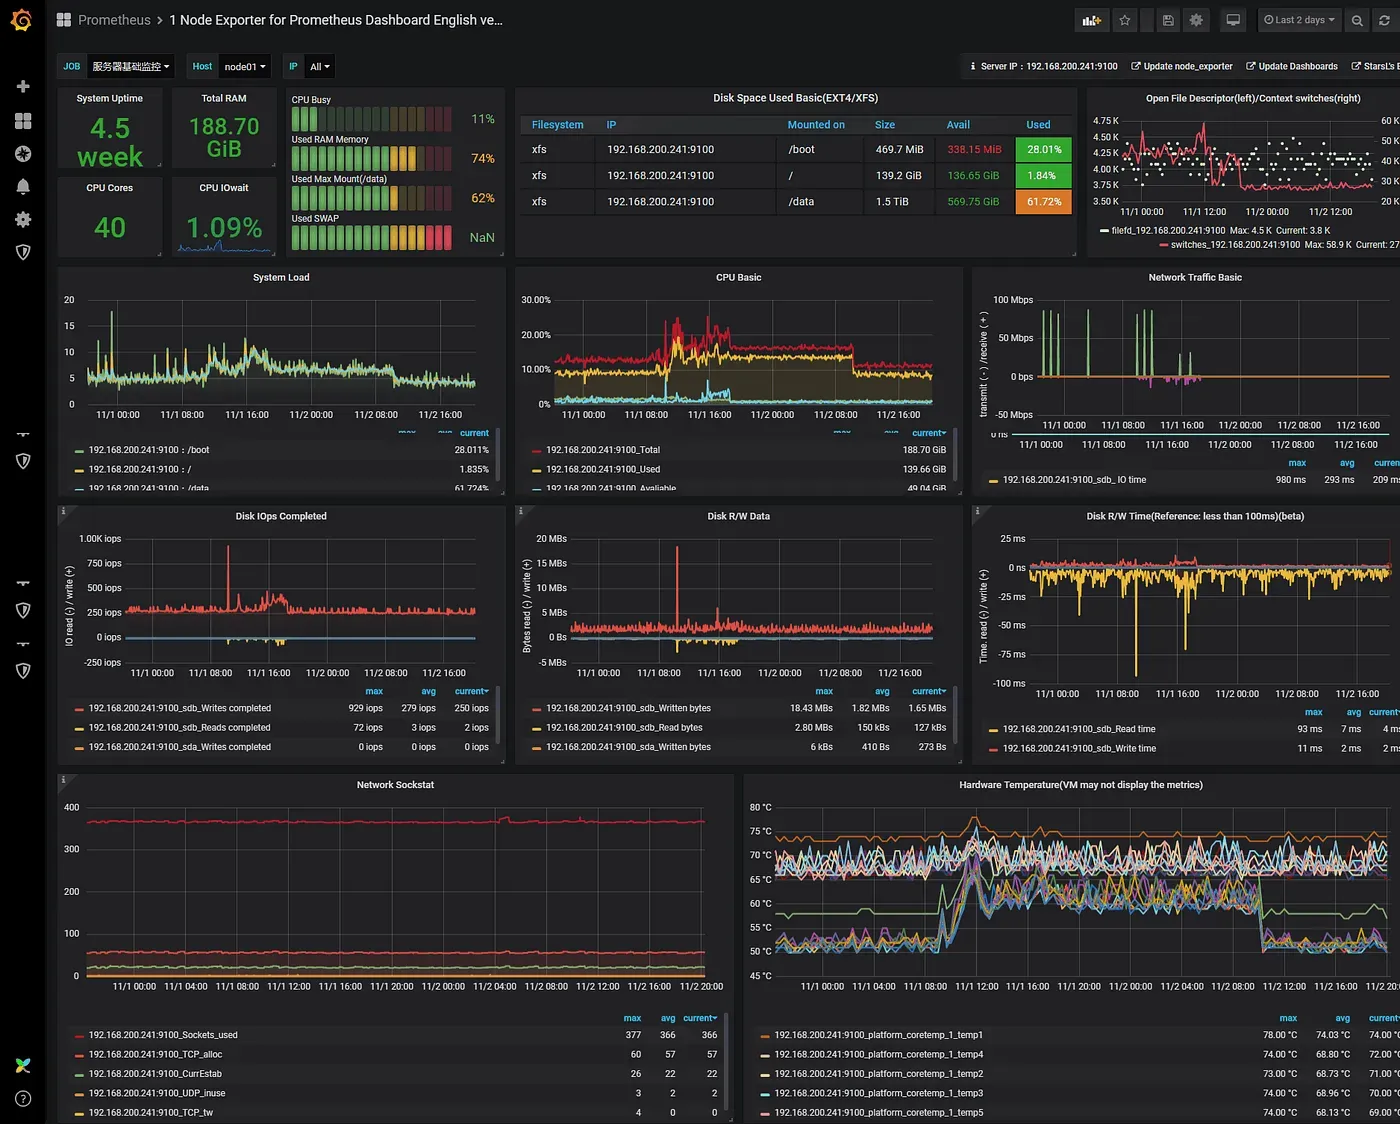
Funciones clave de Prometheus/Grafana (Prometheus 3.x, Grafana 12.x)
Cambios en Prometheus 3.0:
- Ingesta nativa de OTLP en
/api/v1/otlp/v1/metrics— recibe métricas de OpenTelemetry directamente sin colector. - Remote Write 2.0 con compresión mejorada.
- Compatibilidad con UTF-8 en los valores de las etiquetas.
- Nueva interfaz web.
Cambios en Grafana 12:
- Observabilidad como código — Git Sync para dashboards.
- Dashboards dinámicos con apps de drilldown.
- Grafana Alloy como colector único moderno (sustituye a node_exporter + cAdvisor + Promtail).
Capacidades de Prometheus:
- Recolección de métricas por pull con descubrimiento de servicios
- Lenguaje de consultas PromQL para agregaciones complejas
- Base de datos de series temporales con compresión eficiente
- Períodos de retención personalizables
Puntos fuertes de Grafana:
- Dashboards personalizables con variables de plantilla
- Soporte de múltiples fuentes de datos (Prometheus, Loki, InfluxDB, etc.)
- Alertas multicanal con agrupación y escalado
Resumen del despliegue
Los componentes esenciales: Prometheus para las métricas, Grafana para la visualización, Node Exporter para las métricas del sistema y cAdvisor para las estadísticas de contenedores. Para una instalación basada en Docker:
services:
  prometheus:
    image: prom/prometheus:v3.13.0
    container_name: prometheus
    restart: unless-stopped
    volumes:
      - ./prometheus.yml:/etc/prometheus/prometheus.yml
      - prometheus_data:/prometheus
    ports:
      - 9090:9090

  grafana:
    image: grafana/grafana:12.0.0
    container_name: grafana
    restart: unless-stopped
    ports:
      - 3000:3000
    volumes:
      - grafana_data:/var/lib/grafana

  node-exporter:
    image: prom/node-exporter:latest
    container_name: node-exporter
    restart: unless-stopped
    pid: host
    volumes:
      - /proc:/host/proc:ro
      - /sys:/host/sys:ro
      - /:/rootfs:ro

  cadvisor:
    image: gcr.io/cadvisor/cadvisor:latest
    container_name: cadvisor
    restart: unless-stopped
    volumes:
      - /:/rootfs:ro
      - /var/run/docker.sock:/var/run/docker.sock:ro
      - /sys:/sys:ro
      - /var/lib/docker:/var/lib/docker:ro

volumes:
  prometheus_data:
  grafana_data:
Para producción también existen charts de Helm para Kubernetes, automatización con Ansible y soluciones gestionadas como AWS Managed Grafana o Google Cloud Managed Prometheus. La documentación oficial los cubre en detalle: instalación de Prometheus e instalación de Grafana.
Notas de operación:
- Copia de seguridad: El directorio de datos TSDB de Prometheus,
prometheus.ymly los dashboards de Grafana (expórtalos como JSON). - Coste: El nivel gratuito de Grafana Cloud te da 10k series con retención de 14 días. Pro: 19 $/mes + 6,50 $/1k series tras las primeras 10k. Autoalojar es gratis pero te cuesta RAM.
- Revisa tu configuración del firewall de Docker — Prometheus hace pull de las métricas de los exporters, así que la ruta de red importa.
Monitorización de logs: sigue los logs de los contenedores Docker
Las métricas te dicen qué está pasando. Los logs te dicen por qué. Cuando la CPU se dispara, necesitas saber qué proceso es el responsable. Cuando un contenedor se cae, necesitas el mensaje de error. Aquí es donde entra Dozzle — se combina con Beszel o Netdata para las métricas y te da la imagen completa.
Dozzle: visor de logs de Docker con alertas
Dozzle empezó como un visor de logs ligero. Desde v10 (febrero de 2026), ha crecido hasta ser una herramienta completa de operaciones Docker con alertas, analítica SQL, acciones sobre contenedores y acceso shell. Versión 10.6.15, más de 14.000 estrellas en GitHub, licencia MIT. Tamaño de la imagen: ~7–10 MB.
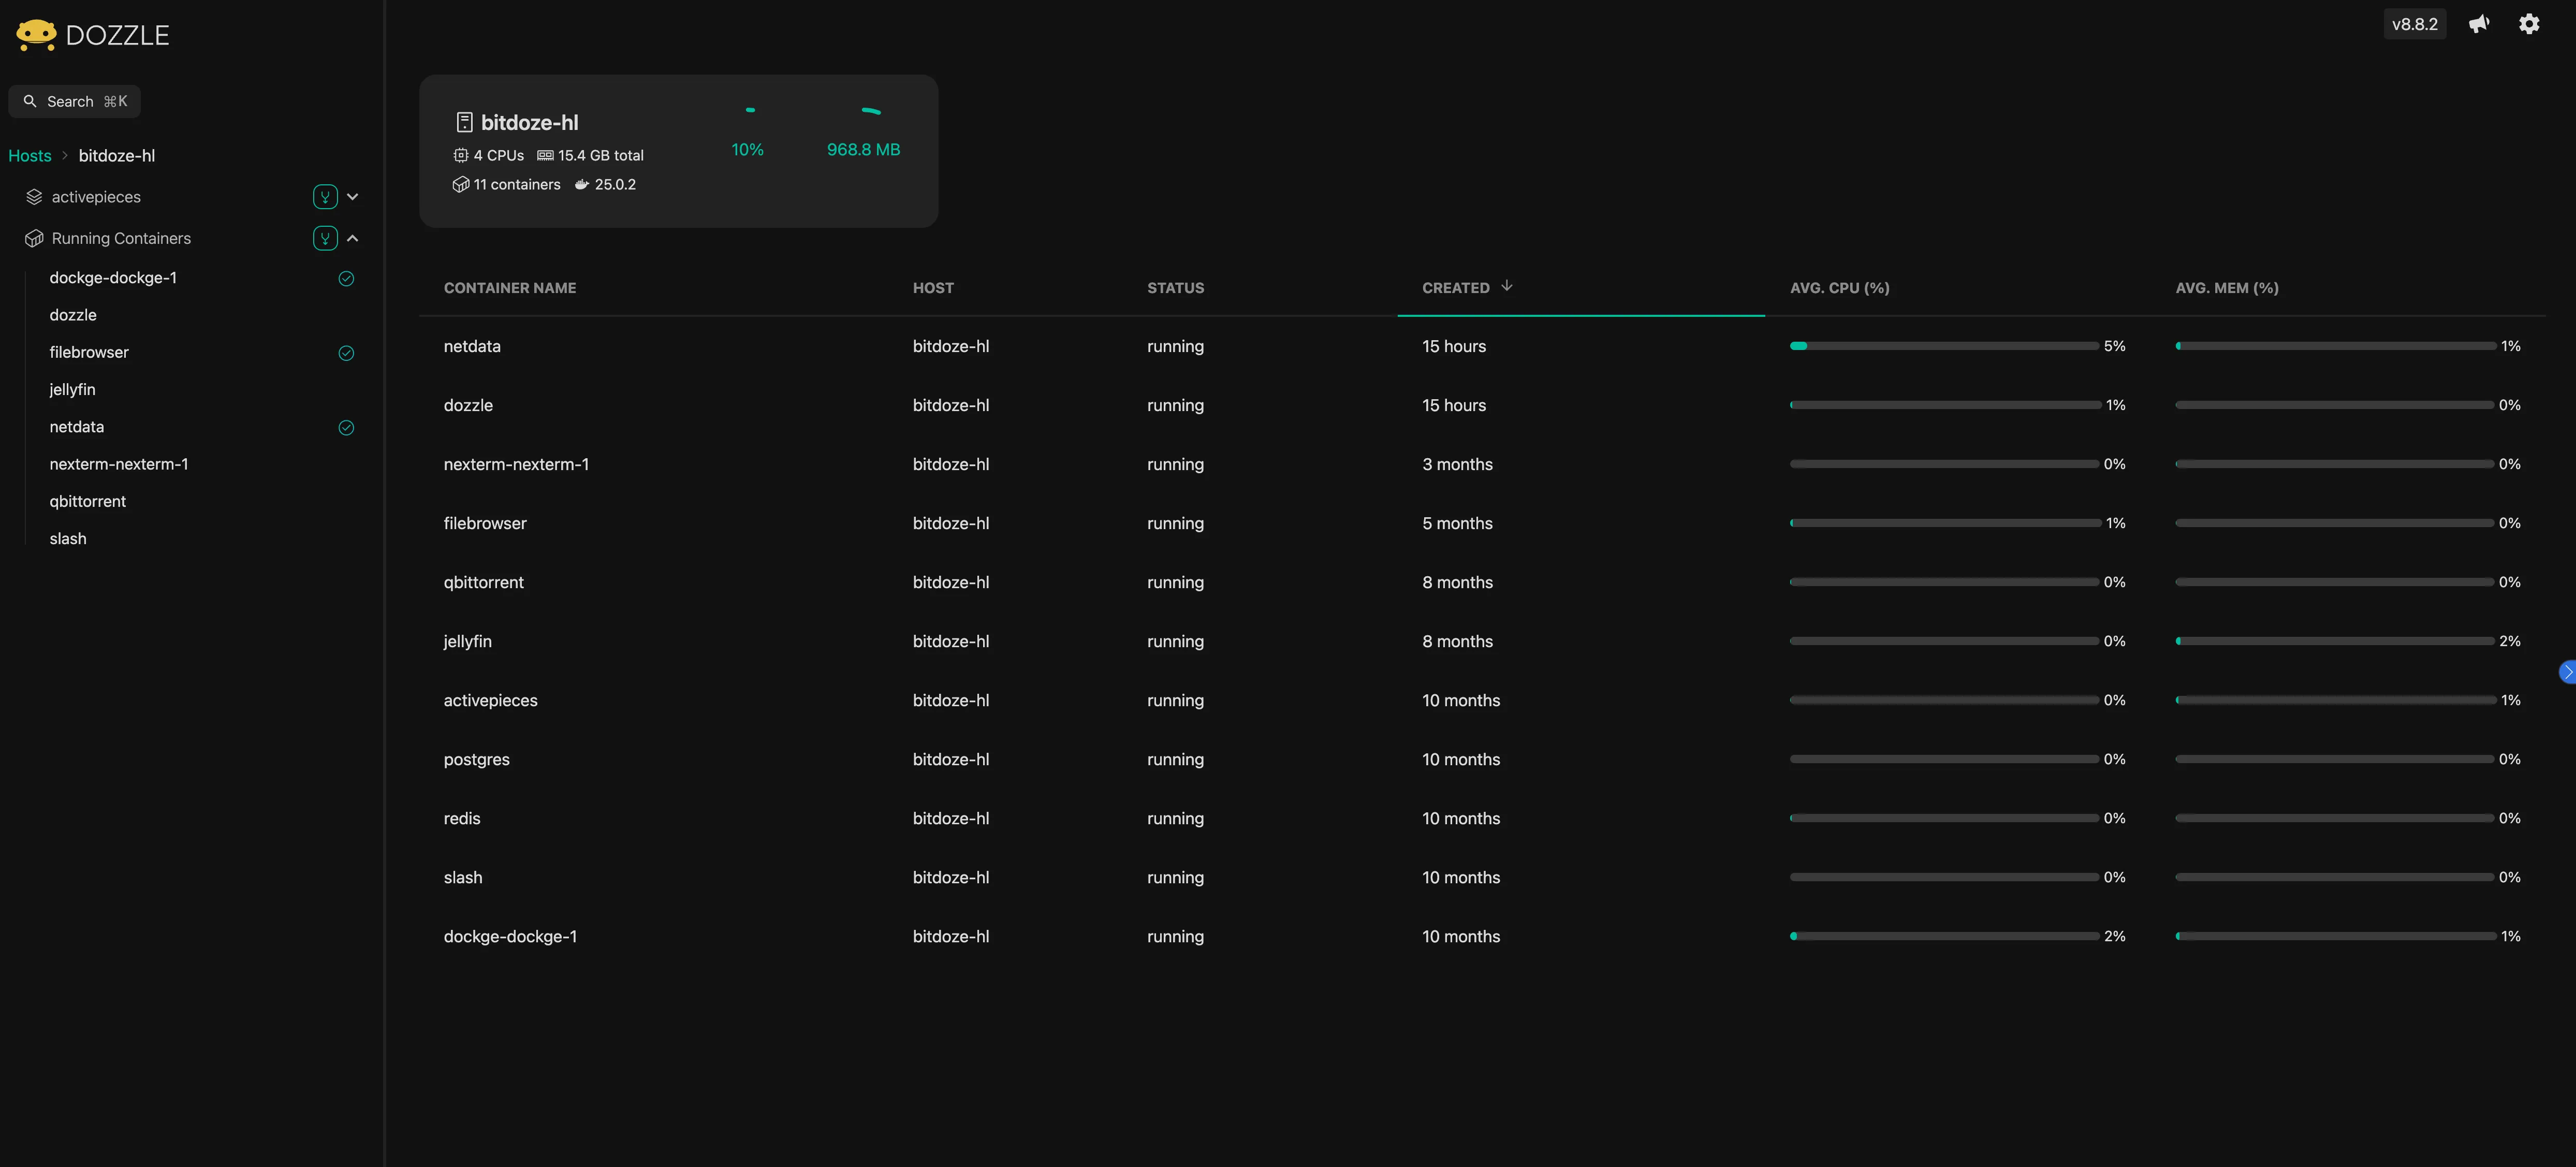
Funciones clave de Dozzle (v10)
Novedades desde el artículo original:
- Alertas y webhooks — coincidencia de patrones en logs («alerta cuando los logs de cualquier contenedor contengan “FATAL”»), umbrales de métricas de CPU/memoria («alerta cuando postgres supere el 85 % de memoria») y eventos de ciclo de vida de contenedores («alerta cuando cualquier contenedor reciba un OOM-kill»). Entrega a Slack, Discord, ntfy o endpoints personalizados.
- Analítica SQL con DuckDB — consulta tus streams de logs en vivo con SQL en el navegador. Ejemplo:
SELECT * FROM logs WHERE message LIKE '%Error%'. Útil para depurar patrones entre contenedores. - Acciones sobre contenedores — detén, inicia y reinicia contenedores desde el navegador. Desactivado por defecto.
- Acceso shell — ejecuta comandos dentro de los contenedores desde el navegador. Desactivado por defecto.
- Autenticación integrada — auth basada en archivos (
DOZZLE_AUTH_PROVIDER=simple) y auth de proxy directo (Authelia). - Compatibilidad con Kubernetes y agentes multihost con TLS.
- Paleta de comandos (Cmd+K), colores ANSI adaptados al tema.
Nota de privacidad
Dozzle envía analíticas de uso anónimas por defecto. Desactívalo con DOZZLE_NO_ANALYTICS=true en el entorno de tu compose. Es solo telemetría de uso — no afecta a la función de analítica de DuckDB.
Despliega Dozzle con Docker Compose
services:
  dozzle:
    image: amir20/dozzle:latest
    container_name: dozzle
    restart: unless-stopped
    volumes:
      - /var/run/docker.sock:/var/run/docker.sock
      - ./dozzle_data:/data              # required: persists alert/notification configs
    ports:
      - 8080:8080
    environment:
      DOZZLE_NO_ANALYTICS: "true"        # opt out of anonymous analytics
      # DOZZLE_AUTH_PROVIDER: simple     # enable built-in file-based auth
      # DOZZLE_ENABLE_ACTIONS: true      # stop/start/restart containers from UI
      # DOZZLE_ENABLE_SHELL: true        # exec into containers from UI
Verifica: Navega a http://your-ip:8080 — deberías ver tus contenedores en ejecución listados en la barra lateral. Haz clic en uno para ver el streaming de logs en vivo. Si la lista está vacía, verifica el montaje del socket de Docker.
Importante: El montaje del volumen /data es obligatorio desde v10. Sin él, tus configuraciones de alertas y ajustes de notificación se pierden en cada reinicio del contenedor.
Dozzle no muestra contenedores
Permisos del socket de Docker: Asegúrate de que /var/run/docker.sock es legible por el usuario del contenedor. Los permisos por defecto del socket de Docker (root:docker, modo 660) suelen funcionar, pero algunas distros los restringen.
SELinux/AppArmor: En sistemas con SELinux obligatorio, puede que necesites :z en el montaje del socket:
volumes:
  - /var/run/docker.sock:/var/run/docker.sock:z
Ruta del socket incorrecta: En algunos sistemas (Docker rootless, Podman), la ruta del socket es distinta. Compruébalo con ls /var/run/docker.sock o ls $XDG_RUNTIME_DIR/docker.sock.
Las alertas no se disparan
Falta el volumen /data: Las configuraciones de alertas se guardan en /data. Si no montaste ./dozzle_data:/data, las alertas solo existen en el sistema de archivos efímero del contenedor y se pierden al reiniciar.
URL del webhook mal configurada: Prueba el endpoint del webhook manualmente con curl desde el contenedor de Dozzle para verificar la accesibilidad de red.
Sintaxis de las reglas: Revisa tus reglas de alerta en la UI de Dozzle. Los patrones de logs usan coincidencia de subcadena, no regex (salvo que se especifique).
Notas de operación:
- Copia de seguridad: El directorio
./dozzle_datacontiene las configuraciones de alertas y notificaciones. - Actualizaciones:
docker compose pull && docker compose up -d - Retención de logs: Dozzle transmite los logs desde Docker — no los almacena. Configura la rotación de logs de Docker para evitar que el disco se llene. Consulta los comandos esenciales de Docker para la gestión de logs. Si el disco ya está lleno, limpia el uso de disco de Docker.
Monitorización de disponibilidad: Uptime Kuma
Beszel vigila los recursos desde dentro del servidor. Uptime Kuma comprueba la accesibilidad HTTP, TCP, DNS y ping desde fuera. Trabajos distintos, ambos necesarios. Este es el stack estándar de monitorización para flotas pequeñas en 2026.
Uptime Kuma es una herramienta autoalojada de monitorización de uptime con una UI limpia, más de 90 canales de notificación, páginas de estado integradas, monitorización de certificados SSL y soporte multilingüe. ~30–50 MB de RAM, licencia MIT.
El stack estándar
Para la mayoría de los autoalojadores en 2026: Beszel (métricas) + Dozzle (logs) + Uptime Kuma (disponibilidad) cubre todo lo que necesitas. Sobrecarga total: ~50–80 MB de RAM.
Despliegue rápido:
services:
  uptime-kuma:
    image: louislam/uptime-kuma:latest
    container_name: uptime-kuma
    restart: unless-stopped
    volumes:
      - ./uptime-kuma-data:/app/data
    ports:
      - 3001:3001
Verifica: Abre http://your-ip:3001, crea tu cuenta de administrador y añade un monitor HTTP para tu propio servidor. Debería mostrar «Up» en pocos segundos.
Para guías de instalación detalladas, consulta cómo instalar Uptime Kuma o desplegar Uptime Kuma con un clic. Para la integración completa de Beszel + Uptime Kuma, mira cómo combinar Beszel con Uptime Kuma.
Tabla comparativa de herramientas
Actualizado en agosto de 2026. Números de versión y cifras de RAM basados en las versiones actuales y en benchmarks independientes.
| Función | Beszel v0.18 | Netdata v2.10 | Prometheus 3.x / Grafana 12.x | Dozzle v10 | Uptime Kuma |
|---|---|---|---|---|---|
| Propósito principal | Métricas ligeras | Métricas profundas en tiempo real | Métricas empresariales | Visualización de logs + alertas | Disponibilidad |
| Uso de RAM | ~10–25 MB | 200–500 MB | 500 MB–1 GB+ | ~10–18 MB | ~30–50 MB |
| Complejidad de instalación | Muy baja | Baja | Alta | Muy baja | Baja |
| Curva de aprendizaje | Suave | Moderada | Pronunciada | Suave | Suave |
| Estadísticas de Docker | Integradas | Integradas | Vía cAdvisor | N/A (solo logs) | N/A |
| Monitorización de GPU | NVIDIA, AMD, Intel, Apple Silicon | Vía go.d/nvidia_smi | Vía exporters personalizados | N/A | N/A |
| Discos S.M.A.R.T. | Integrada con alertas de fallo | Vía colectores | Vía exporters personalizados | N/A | N/A |
| Alertas | Integradas (ntfy, correo, webhook) | Integradas, más de 90 canales | Alertmanager | Webhooks | Integradas, más de 90 canales |
| OAuth/Multiusuario | Integrado (OAuth2/OIDC) | Solo planes Cloud | Integrado en Grafana | Auth por archivos | Integrado |
| Código abierto | MIT | GPL-3.0+ | Apache-2.0 / AGPLv3 | MIT | MIT |
Seguridad y endurecimiento para producción
Todas las herramientas de monitorización de este artículo exponen una interfaz web y la mayoría necesitan acceso al socket de Docker. Trátalas como a cualquier otro servicio de producción.
Proxy inverso + HTTPS: Cada herramienta debería estar detrás de Caddy, Nginx o Traefik con TLS. Un ejemplo mínimo de Caddy para Beszel:
monitor.example.com {
    reverse_proxy http://localhost:8090
}
Autenticación: Beszel lleva OAuth/OIDC integrado. Dozzle admite DOZZLE_AUTH_PROVIDER=simple para auth por archivos o Authelia para auth de proxy directo. Grafana tiene auth integrada con RBAC. Netdata Cloud gestiona la auth en el lado del servidor.
Seguridad del socket de Docker: Todas estas herramientas montan /var/run/docker.sock. Esto es un acceso equivalente a root — cualquiera con el socket puede controlar tus contenedores. Usa siempre montajes de solo lectura (:ro) y considera un proxy de socket de Docker en producción para limitar la superficie de la API.
No monitorices en la misma máquina
Si tu único servidor muere, tu monitorización muere con él. Te quedarás sin métricas, sin logs y sin idea de qué pasó. Ejecuta el hub de Beszel en otra máquina — incluso un VPS de 3 $/mes vale. El hub ocupa ~12 MB de RAM. Opciones baratas: VPS de Hetzner (CX22), Vultr o DigitalOcean. Para una instalación doméstica, un mini PC con hardware dedicado para servidor casero también funciona.
Revisa tu configuración del firewall de Docker — Docker puede saltarse las reglas de UFW/iptables por defecto. Y securiza tu servidor con un endurecimiento de SSH adecuado antes de exponer cualquier panel de monitorización.
Lista de comprobación post-despliegue
Tras desplegar tu stack de monitorización, recorre esta lista:
- Todos los agentes reportando en verde en el panel
- Alertas configuradas con umbrales con sentido (no los valores por defecto)
- Alerta probada — dispara una intencionadamente y confirma la entrega en tu canal de notificación
- Directorios de datos con copia de seguridad (Beszel:
/beszel_data, Dozzle:/data, Netdata: volúmenes de configuración) - Proxy inverso + HTTPS configurado para todas las interfaces web
- Analíticas anónimas desactivadas si lo deseas (
DOZZLE_NO_ANALYTICS=true) - Reglas de firewall verificadas — solo los puertos necesarios expuestos a internet
- Los montajes del socket de Docker son de solo lectura (
:ro) cuando es posible
Conclusiones
El panorama de la monitorización en 2026 es generoso con los autoalojadores. No necesitas pagar a Datadog 15 $/host/mes. Aquí está el árbol de decisión:
Para el 90 % de los lectores (devs en solitario, 1–20 VPS, Docker): despliega Beszel + Dozzle + Uptime Kuma. RAM total: ~50–80 MB. Coste: gratis. Tiempo de instalación: menos de una hora. Este es el stack que recomendaría a cualquiera que empiece de cero.
Si necesitas observabilidad profunda (métricas por segundo, detección de anomalías con IA, más de 800 integraciones): Netdata con el plan Homelab (90 $/año por nodos ilimitados). Reserva 200–500 MB de RAM. Merece la pena cuando depuras problemas de producción que requieren resolución sub-segundo.
Si gestionas una organización con más de 50 objetivos, dashboards personalizados y consultas PromQL: Prometheus + Grafana. Reserva más de 1 GB de RAM y un fin de semana para la configuración inicial. La curva de aprendizaje es real, pero la flexibilidad es inigualable.
Empieza aquí
¿Nuevo en la monitorización de servidores? Despliega el hub + agente de Beszel en dos servidores. Tendrás métricas en 5 minutos y no te cuesta nada. Amplía a Dozzle para los logs y a Uptime Kuma para la disponibilidad a medida que crezcas.
Para más herramientas que ejecutar junto a tu stack de monitorización, echa un vistazo a los contenedores Docker para tu servidor doméstico y a los paneles de gestión de servidores autoalojados.