Despliega EmDash con Docker: Postgres, Medios S3 y Benchmarks Reales
Despliega EmDash en Docker con Postgres y medios Bunny S3: el Dockerfile exacto y el stack compose detrás de livingandglow.com, más benchmarks oha contra el deploy en Cloudflare Workers.

Actualizado Publicado 47 min de lectura
EmDash CMS
Part 6 of 6
La parte 4 cubrió EmDash en Cloudflare Workers. Esta es la otra ruta: un contenedor Docker plano en un VPS, corriendo el mismo CMS sobre Node en vez de Workers. No es un ejercicio teórico. livingandglow.com, mi sitio afiliado de lifestyle, corre exactamente sobre el stack de este artículo: un contenedor de app más Postgres, medios en Bunny S3 detrás de una pull zone, Caddy delante, Cloudflare en DNS. Todo lo de abajo está sacado de su config real, y luego bencheado contra mi emdashhq.com alojado en Workers para que veas cómo se ve el intercambio en realidad.
La versión corta: un docker compose up -d --build te da el CMS entero. Las decisiones que importan son la base de datos (Postgres, y por qué), el backend de medios (S3 o disco local), y cuánto hardware necesita realmente un EmDash contenedorizado. Esa última pregunta tiene una respuesta medida al final, no adivinada.
Cómo se ve el stack Docker
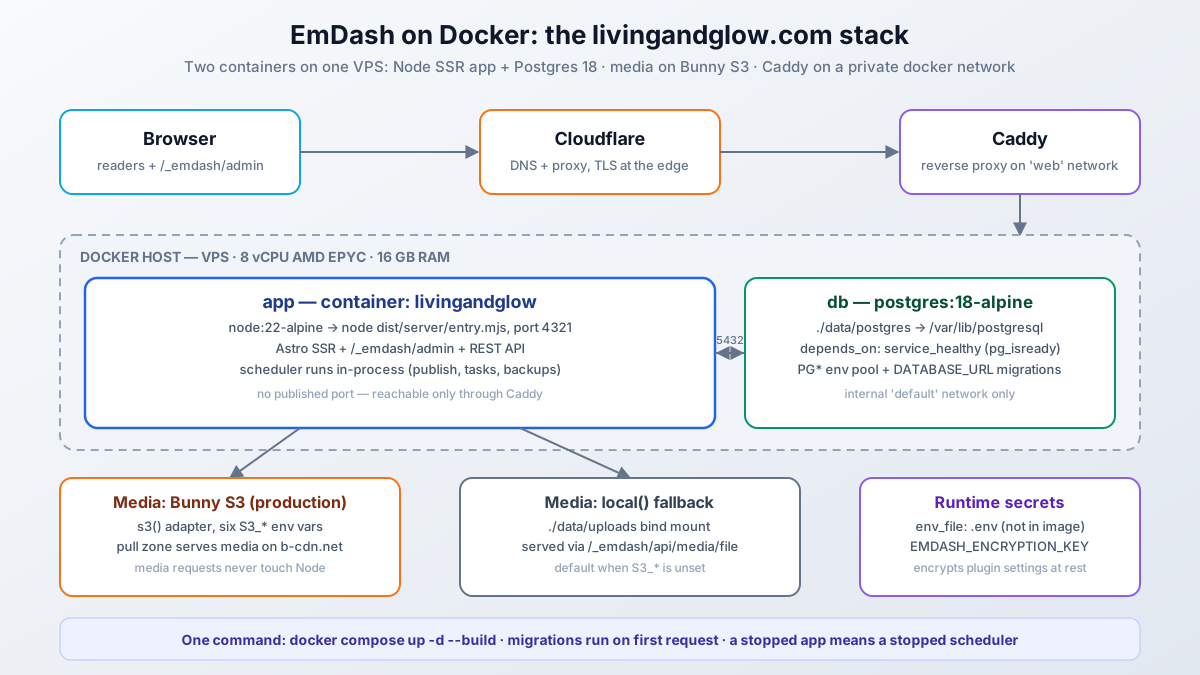
Dos contenedores y una red compartida. El contenedor de app corre el servidor standalone Astro Node en el puerto 4321 sin puerto de host publicado. Postgres corre a su lado en una red interna. Un reverse proxy en una red web compartida (Caddy, en mi caso) es lo único que puede alcanzar la app.
Las razones por las que esta forma funciona para un CMS:
- El proceso Node se queda arriba, lo que importa más de lo que parece: el scheduler de EmDash (publicación programada, tareas de plugins, mantenimiento) solo corre mientras un proceso Node esté corriendo.
restart: unless-stoppedno es decoración opcional. - Postgres vive en su propio contenedor con su propio volumen. Rebuildea o reemplaza la imagen de app y a la base de datos le da igual.
- Los medios pueden salir del contenedor por completo. Con S3 configurado, los uploads van a object storage y los sirve una pull zone de CDN; la app Node nunca toca un request de medios.
/_emdash/admin, la REST API y el sitio público viven todos en el único proceso Node. SSR en cada página, por eso los números de CPU importan después.
El Dockerfile
Tres stages: install, build, run. Lo interesante es que los adaptadores de base de datos y almacenamiento se eligen con build args, no con env vars de runtime, porque EmDash hornea descriptores de adaptador en el bundle en build time. Los secrets nunca entran en la imagen.
FROM node:22-alpine AS deps
WORKDIR /app
COPY package.json package-lock.json ./
COPY plugins ./plugins
RUN npm ci

FROM deps AS build
# Adapter selection is baked at build time — flags carry no secrets.
ARG EMDASH_DB=sqlite
ARG EMDASH_STORAGE=local
ENV EMDASH_DB=$EMDASH_DB EMDASH_STORAGE=$EMDASH_STORAGE
COPY . .
RUN npm run build

FROM node:22-alpine AS runner
WORKDIR /app
ENV NODE_ENV=production \
	HOST=0.0.0.0 \
	PORT=4321
COPY --from=build /app/node_modules ./node_modules
COPY --from=build /app/dist ./dist
COPY --from=build /app/seed ./seed
COPY scripts ./scripts
EXPOSE 4321
CMD ["node", "./dist/server/entry.mjs"]
Notas sobre lo que hay y por qué:
node:22-alpinecoincide con el suelo de Node 22.16+ de EmDash. En Node 22 el driver SQLite integrado imprime unExperimentalWarningal usarse; inofensivo, y desaparece en Node 24.COPY plugins ./pluginsantes denpm ciexiste porquelg-blockses una dependenciafile:; sin ella el install falla en la ruta faltante. Si no tienes plugins locales, quita la línea.COPY --from=build /app/seedenvía el archivo semilla para el asistente de setup del primer arranque. EmDash de todos modos inlina la semilla en el bundle en build time; mantenerla en la imagen es para tooling, no lo requiere el runtime.- El resultado es una imagen de 1,24 GB. La mayoría es
node_modulesde producción (sharp, pg, el AWS SDK, React admin). Adelgazar es posible; no me he molestado.
Y un .dockerignore para que el contexto de build se quede pequeño y los secrets fuera:
.git
node_modules
dist
.astro
.env
.env.*
!.env.example
uploads
data.db
data.db-*
data/
*.md
docker-compose.yml, anotado
Este es el archivo real, comentarios preservados:
services:
  app:
    build:
      context: .
      args:
        # Adapter types are baked at build time; secrets stay runtime-only.
        EMDASH_DB: postgres
        EMDASH_STORAGE: ${S3_ENDPOINT:+s3}
    container_name: livingandglow
    env_file: .env
    # No host port mapping — Caddy reaches the container on the shared
    # "web" network as livingandglow:4321.
    environment:
      DATABASE_URL: postgres://${POSTGRES_USER}:${POSTGRES_PASSWORD}@db:5432/${POSTGRES_DB}
      EMDASH_SITE_URL: ${EMDASH_SITE_URL:-http://localhost:4321}
      # The build bakes postgres() without a literal connectionString, so the
      # runtime pool resolves these standard libpq vars.
      PGHOST: db
      PGPORT: "5432"
      PGDATABASE: ${POSTGRES_DB}
      PGUSER: ${POSTGRES_USER}
      PGPASSWORD: ${POSTGRES_PASSWORD}
    volumes:
      # Local-storage fallback for media when S3_* (Bunny) is not set.
      - ./data/uploads:/app/uploads
    depends_on:
      db:
        condition: service_healthy
    restart: unless-stopped
    networks:
      - default
      - web

  db:
    image: postgres:18-alpine
    container_name: livingandglow-db
    env_file: .env
    volumes:
      # PG18+ stores data at /var/lib/postgresql/18/docker and declares
      # /var/lib/postgresql as the volume root — mount there, not .../data.
      - ./data/postgres:/var/lib/postgresql
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U ${POSTGRES_USER} -d ${POSTGRES_DB}"]
      interval: 5s
      timeout: 3s
      retries: 10
    restart: unless-stopped
    networks:
      - default

networks:
  web:
    external: true
Las partes fáciles de hacer mal:
EMDASH_STORAGE: ${S3_ENDPOINT:+s3}es todo el interruptor de S3. SiS3_ENDPOINTestá en.env, la imagen se buildea cons3(); si no, se buildealocal(). Una env var decide, en build time.DATABASE_URLy las varsPG*están ambas puestas a propósito.postgres({ connectionString })sin una cadena literal en la config resuelve las variables libpq estándarPG*para el pool de runtime, mientrasDATABASE_URLes lo que lee el tooling de migraciones. Pon ambas, apúntalas al mismo sitio.depends_on: condition: service_healthymás el healthcheckpg_isreadyimpide a la app arrancar contra un Postgres a medio levantar.- El volumen de Postgres monta
/var/lib/postgresql, no/var/lib/postgresql/data. Postgres 18 movióPGDATAa/var/lib/postgresql/18/dockery declaró el padre como raíz del volumen. Monta la ruta vieja y tus datos aterrizan en volúmenes anónimos igualmente (o el init falla); esto mordió fuerte a la gente cuando salió la 18. webes una red externa que creo una vez (docker network create web) y comparto entre todos los contenedores de sitios y Caddy.
Base de datos: Postgres, y por qué es el default correcto
EmDash te da una elección real aquí: sqlite() o postgres() en Node. Ambas funcionan. Yo corro Postgres, y para un sitio de producción creo que es el default correcto en vez de una actualización prematura.
SQLite es genuinamente válido para un solo sitio pequeño en un contenedor. EmDash lo abre en modo WAL, los lectores no bloquean al escritor, y la carga de escritura de un blog es diminuta. Los problemas son operativos, no de throughput:
- Un escritor, siempre. WAL permite lectores concurrentes con un único escritor, y un CMS tiene más escritores de lo que parece: lecturas SSR públicas, guardados de admin, el scheduler ticando, escrituras de plugins. Se serializan. Funciona hasta el momento exacto en que un editor publica durante un pico de tráfico.
- Los backups son una trampa. Copiar
data.dbcon la app corriendo puede darte un archivo al que le faltan los últimos commits, porque las páginas comiteadas viven endata.db-wal. La forma correcta es la API de backup online de SQLite, que nadie scripta a la primera.pg_dumpno tiene trampa equivalente. - El mount tiene que ser exactamente correcto. WAL necesita memoria compartida, así que la base de datos debe vivir en un disco local o volumen de bloques, nunca NFS ni SMB, y hay que montar el directorio (los tres archivos), no solo el
.db. - La base de datos no puede sobrevivir limpiamente al contenedor. Con Postgres,
docker compose up -d --builden la app deja el servicio db intacto. Con SQLite, el archivo está en un bind mount que tu próximodocker system prunedescuidado o limpieza de volúmenes puede comerse. - Acota la arquitectura. La guía oficial es clara: Postgres cuando varios procesos Node.js necesitan una base de datos compartida. Aunque nunca escales horizontalmente, las migraciones, los scripts de seeding y las herramientas de inspección (psql,
docker exec, cualquier GUI) asumen un servidor, no un archivo.
El coste medido en este sitio: livingandglow-db está idle en 34 MiB y pico en 88 MiB bajo carga. Es un seguro barato.
La variante SQLite es un cambio de cinco líneas si la quieres igual:
// astro.config.mjs
database: sqlite({ url: "file:./data/emdash.db" }),# compose: drop the db service, add a volume for the app
volumes:
- ./data:/app/dataMonta un directorio, no el archivo, para que -wal y -shm tengan dónde vivir. EMDASH_DB=sqlite (o simplemente DATABASE_URL unset) elige el adaptador en build time. Y en Node 22, espera la inofensiva línea ExperimentalWarning en los logs.
Medios: Bunny S3 o disco local
El mismo patrón que la base de datos: dos opciones funcionales, una claramente mejor pasado cierto tamaño.
Echa un vistazo a Bunny.netAlmacenamiento S3 (lo que corre en prod)
s3() lee seis variables S3_* del entorno del proceso; el sitio las envía por .env:
# Bunny dashboard -> Storage -> your zone -> FTP & API Access
S3_ENDPOINT=https://de-s3.storage.bunnycdn.com   # note the "-s3" infix, per region
S3_BUCKET=livingandglow                          # bucket = storage zone name
S3_ACCESS_KEY_ID=livingandglow                   # key id = zone name
S3_SECRET_ACCESS_KEY=                            # secret = zone password/access key
S3_REGION=de                                     # signing region: de, ny, sg, uk...
S3_PUBLIC_URL=https://livingandglow.b-cdn.net    # pull zone in front of the zone
Tres detalles de Bunny que vale conocer:
- El host del endpoint lleva
-s3(de-s3.storage.bunnycdn.com), no el hostname de CDN que podrías adivinar. La página FTP & API Access de la zona muestra el exacto. S3_PUBLIC_URLdebe apuntar a una pull zone delante de la zona de almacenamiento, no al hostname de storage crudo. Eso es lo que convierte cada URL de media en un request servido por CDN. Bunny.net storage más una pull zone son un par de dólares al mes a esta escala.- El transform
<Image>de Astro necesita el host de medios autorizado, o las imágenes llegan sin optimizar:
// astro.config.mjs
image: {
	remotePatterns: [{ protocol: "https", hostname: "**.b-cdn.net" }],
},
Cualquier servicio compatible con S3 vale aquí (R2, MinIO, lo que sea); los nombres de env son los mismos. La victoria sobre el disco local es arquitectónica: los requests de medios nunca tocan el proceso Node, los uploads sobreviven rebuilds de contenedor sin danza de volúmenes, y el backup se divide limpiamente en “dumpea la base de datos” más “sincroniza el bucket”.
Almacenamiento local (default)
Sin S3_*, el build hornea local():
// astro.config.mjs
storage: local({
	directory: "./uploads",
	baseUrl: "/_emdash/api/media/file",
}),
Los uploads aterrizan en ./data/uploads en el host por el bind mount, y cada archivo se sirve de vuelta por la app Node en /_emdash/api/media/file. Funciona bien a volumen de sitio-folleto y no pide nada extra. Las dos cosas a saber: cada request de medios es trabajo para el mismo proceso que renderiza páginas, y los archivos comparten el destino del disco del host, así que pertenecen a tu plan de backups.
EMDASH_SITE_URL importa en build time, no solo en runtime
Detrás de un proxy, EMDASH_SITE_URL hace correctas las URLs absolutas (sitemap, RSS, redirects de auth) en runtime, eso lo entiende todo el mundo. La parte menos obvia de los docs de deploy: el build también la lee para activar la optimización de imágenes para medios almacenados localmente. Buildea sin ella en almacenamiento local() y las imágenes se sirven como originales sin optimizar. Con S3 es una preocupación solo de runtime.
El archivo .env
Todo lo que compose y la app leen, valores redactados:
EMDASH_SITE_URL=https://livingandglow.com
EMDASH_ENCRYPTION_KEY=          # npx emdash secrets generate

POSTGRES_DB=livingandglow
POSTGRES_USER=livingandglow
POSTGRES_PASSWORD=

S3_ENDPOINT=
S3_BUCKET=
S3_ACCESS_KEY_ID=
S3_SECRET_ACCESS_KEY=
S3_REGION=
S3_PUBLIC_URL=
.env está en .gitignore y .dockerignore. EMDASH_ENCRYPTION_KEY cifra los ajustes de plugins en reposo; ponla antes de guardar cualquier secret de plugin en el admin y guarda una copia fuera del servidor, porque perderla hace ilegibles los secrets de plugins almacenados (la sección de secrets de la guía de deploy cubre la rotación).
Saliendo en vivo: Caddy, primer arranque, deploys
El Caddyfile es un bloque en la red web compartida:
livingandglow.com {
	reverse_proxy livingandglow:4321
}
Primer arranque: docker compose up -d --build buildea la imagen, espera a pg_isready, arranca la app. Con el modo de migración auto por defecto el primer request aplica las migraciones de núcleo pendientes, y una base de datos fresca recibe el esquema semilla embebido; el asistente de setup en /_emdash/admin ofrece luego el contenido inicial. La semilla nunca sobrescribe datos existentes.
Los deploys posteriores son git pull && docker compose up -d --build. Las migraciones corren en el primer request tras levantarse el contenedor nuevo, así que hay una ventana de unos segundos donde el primer hit hace el trabajo de migración; en un sitio mayor correrías npx emdash migrate explícitamente antes de reiniciar, el mismo runbook que la ruta Workers.
Las env vars restantes que podrías encontrar: HOST/PORT si 4321 choca, EMDASH_PREVIEW_SECRET/EMDASH_IP_SALT solo si necesitas valores fijados entre procesos, y nada más. Y si quieres plugins de marketplace/registro en Node, necesitan el runner @emdash-cms/sandbox-workerd en vez del binding LOADER de Cloudflare.
Benchmarks: Docker vs Workers, medidos
Método: oha (la misma herramienta de mi guía de load testing de webs), tres escenarios, todos tras calentamiento, solo GET de homepage.
- Directo al contenedor:
oha -H "Host: livingandglow.com" http://172.20.0.23:4321/golpea la app sin CDN y sin proxy. El headerHostes requerido porquesecurity.allowedDomainsen la config restringe qué hostnames sirve el sitio. - livingandglow.com público: a través de Caddy y Cloudflare, exactamente lo que un visitante recibe.
- emdashhq.com público: el deploy Workers Paid de la parte 4, D1 + R2 + KV + Workers Cache.
Mientras corría la carga muestreé docker stats cada segundo para ambos contenedores.
Tiempos de respuesta
| Objetivo | Concurrencia | Requests | Req/s | p50 | p95 | p99 | Errores |
|---|---|---|---|---|---|---|---|
| Contenedor, directo | 20 | 3.855 | 193.7 | 100 ms | 134 ms | 160 ms | 0 |
| Contenedor, directo | 50 | 5.008 | 200.3 | 238 ms | 315 ms | 414 ms | 0 |
| livingandglow.com (público) | 15 | 2.934 | 146.7 | 95 ms | 138 ms | 186 ms | 0 |
| emdashhq.com (público) | 15 | 6.961 | 348.7 | 42 ms | 51 ms | 60 ms | 0 |
Carga del contenedor bajo fuego
El VPS es una máquina AMD EPYC de 8 vCPU con 16 GB de RAM que también aloja una docena de otros contenedores. CPU% es la convención de docker stats: 100% = un núcleo.
| idle | ~194 req/s (c=20) | ~200 req/s (c=50) | |
|---|---|---|---|
| CPU app | 0% | 117-170% (pico 170%, ~1,7 núcleos) | pico 223% (~2,2 núcleos) |
| memoria app | 105 MiB | escala a 362 MiB | pico 408 MiB |
| CPU db | 0% | 113-150% (pico ~1,5 núcleos) | pico 140% (~1,4 núcleos) |
| memoria db | 34 MiB | 78-82 MiB | pico 88 MiB |
Lo que los números dicen realmente
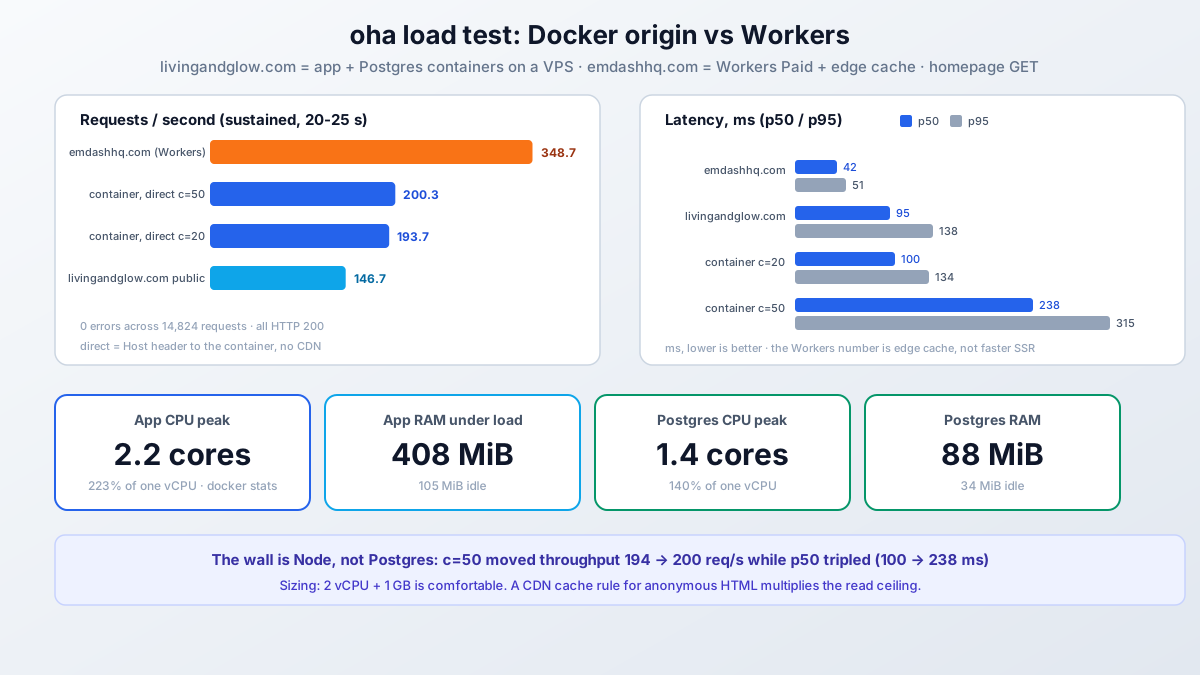
- ~200 req/s es el techo de un solo proceso para esta homepage, y el muro es Node, no Postgres. Pasar de 20 a 50 conexiones movió el throughput de 194 a 200 req/s mientras el p50 iba de 100 ms a 238 ms. La app pica a 2,2 núcleos (el event loop más GC) contra los 1,4 de Postgres; la base de datos aún tenía margen cuando Node estaba saturado.
- La memoria es aburrida, en el buen sentido. La app escala a ~400 MiB RSS bajo carga y se queda caliente por ahí; Postgres nunca pasó de 90 MiB. Un VPS de 1 GB corre este stack con espacio de sobra; la restricción es CPU, no RAM.
- Dimensionado: 2 vCPU es cómodo para un sitio CMS con esta forma. 1 vCPU clavaría el proceso bajo unas cien requests concurrentes y el scheduler competiría por el mismo núcleo. 4+ solo ayuda si corres más de un proceso de app.
- Público versus directo es casi idéntico en el VPS (95 ms p50 vs 100 ms directo): Cloudflare no está cacheando el HTML de este sitio, solo añade tránsito y TLS. Cada request público aterriza en el proceso Node, que es exactamente por qué el rendimiento del origen importa aquí.
- Workers es más rápido en el mismo test, y mayormente no por la razón halagadora. emdashhq.com a 42 ms p50 es Workers Cache sirviendo la mayoría de requests en el edge más una página mucho más ligera (12 KiB versus 35 KiB en esta homepage). Es una arquitectura diferente con una caché delante, no un runtime más rápido renderizando el mismo trabajo. Ambos números son lo que visitantes reales reciben, que es la forma justa de compararlos.
El resumen honesto: un contenedor en VPS sirve aproximadamente 200 páginas SSR sin cachear por segundo antes de que la latencia se degrade, y una regla de caché CDN delante lo multiplica por la fracción de tu tráfico que sean lecturas anónimas repetidas. Para un sitio de contenido, ese techo está muy por encima de lo que jamás necesitará.
Docker vs Workers: qué deploy elegir
No un veredicto de benchmark, una preferencia de ops:
- Elige Docker/VPS si quieres acceso shell cuando algo va mal, Postgres con backups
pg_dumpreales, medios S3 que posees por completo, plugins que esperan Node (SMTP genérico, transports locales, el runner sandbox-workerd), o ya corres un host Docker y esto es un servicio más en él. - Elige Workers si quieres cero servidores, lecturas servidas en el edge que hacen los load tests aburridos, y aceptas el modelo de bindings más sus aristas de tier de pago (la guía de deploy tiene la tabla completa de límites).
- El email funciona en ambos ahora, de forma distinta: binding
send_emailen Workers,emdash-smtpSMTP genérico en Node (la guía de email cubre ambos).
Mi propia división lo dice claramente: el sitio de contenido afiliado está en el VPS porque vive junto a otros servicios autoalojados y me gusta pg_dump; el hub de EmDash está en Workers porque debería costar nada correr y ser rápido en todas partes. Ambos son el mismo paquete emdash.
Troubleshooting del deploy Docker
| Síntoma | Causa probable | Arreglo |
|---|---|---|
npm ci falla en plugin file: |
plugins/ no copiado antes del install |
COPY plugins ./plugins antes de npm ci en el Dockerfile |
| La app crashea al arranque: conexión DB rechazada | Postgres aún no listo | depends_on: db: condition: service_healthy + el healthcheck pg_isready |
| Datos DB perdidos tras recrear el contenedor db | Volumen montado en /var/lib/postgresql/data (ruta PG17) |
Monta /var/lib/postgresql; PG18 guarda bajo …/18/docker |
| Medios 404 tras cambiar a S3 | S3_PUBLIC_URL mal o los archivos solo existen en el volumen viejo |
Apúntala a la pull zone; sube por el admin o migra los archivos |
| Imágenes sin optimizar con almacenamiento local | EMDASH_SITE_URL falta en build time |
Ponla para npm run build, no solo en runtime |
| Imágenes remotas renderizan crudas | Host no en image.remotePatterns |
Añade el hostname de medios (**.b-cdn.net) |
| Los posts programados nunca se publican | Ningún proceso Node corriendo | restart: unless-stopped; el scheduler solo corre dentro de un proceso vivo |
503 EMAIL_NOT_CONFIGURED |
Ningún proveedor de email activo | emdash-smtp en Node; mira la guía de email |
ExperimentalWarning: SQLite en logs |
Driver integrado de Node 22 | Inofensivo; desaparece en Node 24, o cambia a Postgres |
| Secrets de plugins ilegibles tras restaurar | EMDASH_ENCRYPTION_KEY perdida o rotada |
Restaura la clave; la rotación es en dos fases (guía de deploy) |
FAQ: EmDash en Docker
¿Necesito Postgres, o SQLite basta para un sitio real?
SQLite es genuinamente suficiente para un solo sitio pequeño: el modo WAL maneja lectores concurrentes, y el volumen de escritura de un blog es diminuto. Postgres se gana su lugar en el momento en que te importan backups correctos (pg_dump, no copiar archivos WAL a mitad de escritura), escritores concurrentes (admin + scheduler + público), una base de datos que sobreviva limpiamente al contenedor de app, o correr alguna vez una segunda instancia de app. Su coste aquí es menos de 90 MiB de RAM. Lo trato como el default, no la actualización.
¿Puedo correr todo en un contenedor sin compose?
Sí, para SQLite más almacenamiento local: el Dockerfile oficial más docker run -p 4321:4321 -v emdash-data:/app/data es un deploy completo. Renuncias a los beneficios de Postgres de arriba, y las tareas programadas siguen necesitando el proceso corriendo. Es un buen primer deploy; la versión compose es la que yo mantendría.
¿EmDash necesita env vars para SMTP en Docker?
No nuevas por proveedor. emdash-smtp toma las credenciales en el admin (Plugins > SMTP Providers) y las guarda cifradas en la base de datos, exactamente igual que en Workers. La única clave que debe existir ya es EMDASH_ENCRYPTION_KEY. La guía de email recorre ambas opciones de proveedor.
¿Por qué mi EmDash en Docker es más lento que los números de Workers que muestras?
Probablemente no es más lento en el origen; le falta una caché. El sitio Workers sirve la mayoría de requests desde Workers Cache en el edge, mientras un render de VPS pelado aterriza en Node cada vez. Añade una regla de caché CDN para HTML anónimo o la route cache de Astro y la brecha se cierra mayormente. El techo sin caché medido aquí, ~200 req/s, sigue estando muy por encima de lo que ve un sitio de contenido normal.
¿Cómo hago backup de un sitio EmDash en Docker?
Tres piezas: docker exec livingandglow-db pg_dump -U livingandglow livingandglow para la base de datos, el volumen ./data/uploads (o el bucket S3) para los medios, y EMDASH_ENCRYPTION_KEY de tu almacén de secrets. EmDash también escribe sus propios backups JSON en el scheduler; guárdalos, pero no confíes solo en ellos ya que los binarios de medios viven fuera de la base de datos.
¿Puedo poner plugins de marketplace en el deploy Docker?
Sí, con un runner distinto al de Workers. En Node.js el runner de sandbox es @emdash-cms/sandbox-workerd, que lanza un proceso hijo workerd para plugins en sandbox. Los plugins nativos (el array plugins:) corren en-proceso en cualquier plataforma y no necesitan nada extra.
Cierre
docker compose up -d --build con Postgres y un backend S3 es un deploy de EmDash de producción en un comando: los tipos de adaptador se hornean en el build, los secrets llegan por .env, Postgres guarda el contenido, Bunny sirve los medios, y Caddy lo frontera en una red privada. Medido, no adivinado: ~200 req/s por proceso Node, ~400 MiB RSS para la app, menos de 90 MiB para Postgres, y cero errores en 8.800 requests de load testing. Un VPS de 2 vCPU a cinco o seis euros al mes lo corre con margen, y los números de Workers en la tabla muestran por qué estás cambiando esa factura mensual.
Esa es la parte 6 de la serie EmDash CMS: la ruta Docker autoalojada, de extremo a extremo.
El deploy en Cloudflare Workers (parte 4)