Los mejores LLMs open source para reemplazar a Claude Opus 5.5 (2026)
Los mejores LLMs open source para reemplazar a Claude Opus 5.5 o GPT-6 en 2026: MiMo-V2.6-Pro, GLM-5.3, DeepSeek V4.1 y más, comparados por potencia de codificación y costo real.

50 min de lectura
Los mejores LLMs open source ya se miden de igual a igual con Claude Opus 5.5 en trabajo de codificación real, a una fracción del precio del buque insignia. Hace tres semanas publiqué esta tabla clasificatoria a fecha de 24 de septiembre. Desde entonces, el nivel propietario copió los precios del nivel abierto: Claude Sonnet 5.5, GPT-6.1 Sol y Gemini 4 Argon se sitúan en $2/$10 por millón de tokens, mientras Claude Haiku 5.5 y GPT-6 Luna corren a $0.10/$0.50. El campo abierto respondió con Step 5 Preview tomando el puesto #3 de pesos abiertos y Xiaomi lanzando checkpoints MOPD que corrigen un modo de fallo agéntico real.
Sigo ejecutando estos modelos contra la frontera de pago en trabajo de codificación real. La brecha es más estrecha de lo que sugieren los precios de los buques insignia, y el argumento para el open source ya no es “precio de etiqueta más barato”. Es el costo por ejecución de agente útil, pesos descargables, facturación en horario valle y ausencia de límites de tasa.
Resumen de comparación de costos
Claude Opus 5.5 cuesta $4/$20 por millón de tokens. Sonnet 5.5, GPT-6.1 Sol y Gemini 4 Argon cuestan $2/$10. Haiku 5.5 y Luna cuestan $0.10/$0.50. Los modelos abiertos de esta guía van desde menos de un céntimo (aciertos de caché de DeepSeek) hasta $3.00 por millón de tokens de entrada. Frente a Fable 5.1 y GPT-6 Astra ($10/$50) eso es un recorte del 70-97%. Frente a Opus 5.5 ($4/$20), MiMo, GLM-5.3 y DeepSeek siguen siendo 65-93% más baratos en entrada; Kimi K3 a $3/$15 es la excepción con un 25% aproximado. Frente a Haiku 5.5 y Luna, el argumento abierto son los pesos, el autoalojamiento y la capacidad, no el precio de etiqueta.
Actualizado el 16 de octubre de 2026: Sonnet 5.5, Haiku 5.5, GPT-6.1 Sol, Gemini 4 Argon, Step 5 Preview, checkpoints MiMo MOPD, renombrados de la API de DeepSeek.
Si todavía necesitas elegir el agente antes que el modelo, empieza con nuestra comparación de mejores herramientas y agentes de codificación con IA y vuelve aquí para la lista corta de modelos. Para asistentes siempre activos que necesitan un modelo barato detrás, consulta nuestras alternativas open source a Grok Bot.
Qué cambió desde nuestra actualización de septiembre de 2026
Tres semanas es mucho tiempo en este mercado. Seis cosas se movieron:
- Claude Sonnet 5.5 se lanzó el 28 de septiembre: AA Intelligence 56 a $2/$10. Esta es la nueva amenaza de valor, no Opus.
- Claude Haiku 5.5 se lanzó el 7 de octubre: $0.10/$0.50 (batch $0.05/$0.25) con AA 43. Queda por debajo de GLM-5.3-Flash en precio de entrada y puntúa más alto.
- GPT-6 Sol se convirtió en GPT-6.1 Sol el 29 de septiembre: de AA 48 a 52 al mismo precio de $2/$10. Una mejora gratuita de 4 puntos para cualquiera en ese nivel.
- Gemini 4 Argon aterrizó el 30 de septiembre: AA 53 a $2/$10, orientado a ingeniería de software compleja y agentes de múltiples pasos.
- Step 5 Preview (18 de septiembre) es el nuevo modelo de pesos abiertos #3: AA 44, 600B totales / 27B activos.
- Xiaomi publicó los checkpoints MiMo MOPD el 9 de octubre: corrigen la repetición de llamadas a herramientas, un modo de fallo donde el agente parece ocupado y no progresa.
Una corrección más: Fable 5.1 y GPT-6 Astra con 53 solían ser la puntuación publicada más alta del Artificial Analysis Intelligence Index. Ya no. Claude Opus 5.5 (max con fallback) se sitúa en 58.
¿Por qué considerar alternativas LLM open source?
La versión corta: el campo abierto alcanzó a los propietarios en codificación, y lo hizo manteniéndose barato de ejecutar.
- Costo por ejecución de agente útil: La mayoría de los modelos aquí corren a $0.15-$3 por millón de tokens de entrada, y los aciertos de caché más los precios en horario valle pueden recortarlo de nuevo
- Pesos abiertos: Cada modelo de esta lista tiene pesos descargables, así que puedes autoalojarlo, hacerle fine-tuning o fijar una versión para siempre
- Rendimiento: MiMo-V2.6-Pro (AA 46) y GLM-5.3 (AA 45) superan a modelos frontera más antiguos en varias suites de codificación agéntica
- Flexibilidad: APIs de proveedores, OpenRouter o tu propio cluster de GPUs
- Vía de escape: Fija pesos, cambia de proveedor cuando una API falla, y evita límites de tasa y deprecaciones sorpresa
- Ritmo: Step 5 Preview, Muse Spark Open y MiMo MOPD llegaron desde mediados de septiembre
Qué evaluar
- Codificación: Generar, depurar y refactorizar sobre un repo real
- Trabajo agéntico: Llamadas a herramientas, ejecuciones largas de múltiples pasos, no perder el hilo en el paso 200
- Longitud de contexto: Cuánto de un codebase cabe en una sola pasada
- Costo por resultado útil: No solo el precio de lista por millón de tokens
- Disponibilidad de pesos: “Abierto” ahora va desde MIT, hasta la cláusula MaaS de $10B de ingresos de GLM, hasta los términos de ingresos de StepFun Model License 1.0. Lee antes de desplegar.
El listón propietario: Claude Opus 5.5, Sonnet 5.5, GPT-6.1, Gemini 4
Esto es lo que persiguen los modelos abiertos, a 16 de octubre de 2026.
| Modelo | AA Intelligence | Precio entrada/salida por M | Por qué importa |
|---|---|---|---|
| Claude Opus 5.5 | 58 | $4/$20 | La puntuación AA publicada más alta, contexto de 1M, salida máxima de 128K |
| Claude Sonnet 5.5 | 56 | $2/$10 (batch $1/$5) | 3 puntos por encima de Astra a una quinta parte del precio de salida |
| Fable 5.1 / GPT-6 Astra / Gemini 4 Argon | 53 | $10/$50, $10/$50, $2/$10 | El antiguo techo; Argon lo empata a $2/$10 |
| Muse Wonder / GPT-6.1 Sol | 52 | TBD, $2/$10 | El nuevo buque insignia de Meta y el nivel medio mejorado de OpenAI |
| Haiku 5.5 / GPT-6 Luna | 43 / 38 | $0.10/$0.50 | El nuevo nivel económico |
Tres notas de operador sobre esa tabla.
El dolor de migración a Opus 5.5 es real. El pensamiento adaptativo está siempre activo (la profundidad se controla con el parámetro effort), el uso forzado de herramientas desapareció, y thinking: disabled ahora devuelve un error 400. Si tu stack de agentes se construyó sobre Opus 5, lee las notas de migración antes de cambiar.
Cambios que rompen en Opus 5.5
thinking: disabled devuelve un 400 ahora, y el uso forzado de herramientas ha sido eliminado. Cualquier cliente que haya hardcodeado cualquiera de los dos comportamientos se romperá en la primera petición. Prueba contra la nueva forma de la API antes de pasar el tráfico de producción.
Sonnet 5.5 es el modelo que compite con el campo abierto en valor. AA 56 a $2/$10 está 3 puntos por encima de GPT-6 Astra costando una quinta parte de su tarifa de salida. Si solo quieres “barato e inteligente” y no te importan los pesos, esta es la respuesta propietaria.
El nivel económico solo es media victoria para los propietarios. Haiku 5.5 a $0.10/$0.50 con AA 43 es más barato en entrada que GLM-5.3-Flash ($0.15) y puntúa más alto (43 vs 42). Pero GPT-6 Luna con AA 38 queda por debajo de GLM-5.3-Flash (42), DeepSeek V4.1-Flash (39) y Kimi K3 (44) al mismo precio de etiqueta. Así que “lo propietario ahora es lo más barato” es cierto para Haiku y mayormente falso para Luna.
Vale la pena recordar también: las peticiones de la familia GPT-6 por encima de 272K tokens de entrada se reprecian a $20/$75 en facturación clase Astra. El contexto largo no es gratis en ningún lado.
1. MiMo-V2.6-Pro: el nuevo líder de pesos abiertos
MiMo-V2.6-Pro es el buque insignia de Xiaomi del 22 de septiembre y el modelo de pesos abiertos mejor puntuado en el Artificial Analysis Intelligence Index con 46, por delante de GLM-5.3 (45) y del par Step 5 Preview / Kimi K3 en 44. Eso lo coloca por encima de Grok 4.6 y Gemini 3.8 Flash, empatado con Grok 4.7, y a unos doce puntos del 58 de Opus 5.5. Es un MoE disperso de 1.02T con 42B activos por token, licencia MIT, y nativamente omnimodal: texto, imagen, video y audio de entrada.
Dos detalles que no esperaba del laboratorio de IA de un fabricante de teléfonos: publicaron la factura del entrenamiento RL (unos $2.62M para Pro, 30 pasos en menos de seis días y alrededor de 750K trayectorias), y el precio de API se mantuvo igual que en V2.5 a $0.435/M de entrada y $0.87/M de salida.
Especificaciones técnicas
| Feature | MiMo-V2.6-Pro |
|---|---|
| Total Parameters | 1.02T (sparse MoE, 384 experts / 8 active) |
| Active Parameters | 42B |
| Context Length | 1M tokens |
| Architecture | Hybrid SWA/GA MoE + 5-layer MTP decoder |
| Multimodal | Text, image, video, audio input |
| AA Intelligence | 46 (#1 open weights) |
| DeepSWE v1.1 | 71.9 |
| Terminal-Bench 2.1 | 89.9% (vendor-run) |
| Input Cost | $0.435/M tokens |
| Output Cost | $0.87/M tokens |
| License | MIT |
Lo que destaca
- AA Intelligence 46: La puntuación más alta entre pesos abiertos, y es el propio harness de AA el que produce el número, no la página de marketing de Xiaomi
- DeepSWE 71.9: Por encima del 70.0 de Claude Fable 5 en la misma suite, cerca del 73.0 de GPT-5.6 Sol
- Terminal-Bench 2.1 con 89.9%: Ejecutado por el proveedor y cerca de la cima de las puntuaciones publicadas cuando aterrizó. Revisa el leaderboard en vivo antes de citarlo como “el más fuerte”
- AutomationBench 53.1 y Agents’ Last Exam 31.6: Supera o empata los números publicados de Claude Opus 5 en ambos
- Entrada omnimodal: El único modelo aquí que acepta audio de forma nativa, además de imagen y video
- ~134 tok/s de salida: Rápido para un modelo de un billón de parámetros, ayudado por el decodificador especulativo MTP
- Hermanos baratos: MiMo-V2.6-Flash (310B/15B activos) a $0.14/$0.28, y una variante Pro-UltraSpeed a $4.35/$8.70 cuando quieres unas 20x de velocidad de generación
Los checkpoints MOPD: descarga estos, no el lanzamiento original
El 9 de octubre Xiaomi publicó MiMo-V2.6-Pro-MOPD y MiMo-V2.6-Flash-MOPD bajo MIT, más los checkpoints crudos de la etapa RL (MiMo-V2.6-Pro-RL, MiMo-V2.6-Flash-RL) y un informe técnico de 52 páginas (la sección 5.6 cubre MOPD2). La mejora MOPD existe para corregir un modo de fallo específico: la repetición de llamadas a herramientas.
Xiaomi lo describe claramente en su diagnóstico de repetición de llamadas a herramientas: el modelo “sigue emitiendo las mismas llamadas a herramientas o muy similares, pareciendo ocupado mientras no progresa”, y el patrón “tiende a pasar desapercibido”. Esa segunda parte es el problema del operador. Un agente atascado que parece productivo quema tokens y horas.
Vigila la repetición de llamadas a herramientas
Si una ejecución de agente está produciendo un flujo de llamadas a herramientas casi idénticas sin cambios en archivos ni progreso en la salida, estás en este bucle. A corto plazo: mata la ejecución, añade detección de bucles o un límite de llamadas idénticas en tu harness. Solución estructural: sirve el checkpoint MOPD en lugar del lanzamiento original de septiembre. Los detalles del diagnóstico están en el post del blog de Xiaomi enlazado arriba.
Para quienes autoalojan, el checklist es simple: descarga MiMo-V2.6-Pro-MOPD (o Flash-MOPD), no el tag original. Si tu máquina es pequeña, MiMo-V2.6-Distill-Qwen-9B (22 de septiembre, MIT) es la opción realista, y puedes ejecutar modelos locales con Ollama en Docker para mantener el stack de serving contenido.
Cuándo usarlo
- Trabajo de agentes en general: La puntuación abierta más alta en el índice de AA centrado en agentes
- Sesiones de codificación largas: 1M de contexto con números fuertes en DeepSWE y Terminal-Bench
- Pipelines multimodales: Capturas de pantalla, frames de video y notas de audio en un solo modelo
- Sáltalo si: necesitas una huella de autoalojamiento pequeña. 1.02T exige un nodo multi-GPU incluso cuantizado; MiMo-V2.6-Flash (310B) o el distill de 9B es la opción más realista para homelab
Bono de MiMo
Regístrate a través de go.bitdoze.com/mimo y recibe $2 de bono en crédito. Xiaomi también lanzó un cliente de escritorio MiMo y planes de membresía junto a V2.6 si prefieres una suscripción fija en lugar de facturación por token. Los términos del bono cambian; la landing page muestra lo que está activo hoy.
2. GLM-5.3: el burro de carga de la codificación abierta
GLM-5.3 se lanzó el 14 de agosto a través del GLM Coding Plan, con los pesos abiertos llegando el 28 de agosto. Misma base 744B-A40B que GLM-5.2; toda la mejora viene del post-entrenamiento. Los números muestran hasta dónde llega eso: Terminal-Bench 3.0 saltó de 4.6 a 28.3, DeepSWE de 46.2 a 66.9, y Z.ai afirma una mejora del 50% en su bench interno de código. Z.ai lo llama el modelo de codificación de pesos abiertos más capaz, y mantiene AA Intelligence 45, segundo entre los modelos abiertos.
Una salvedad: la ronda de post-entrenamiento de GLM-5.3 también produjo un gran salto en capacidad ciberseguridad. Z.ai es transparente al respecto (CyberGym 84.5, estado del arte; los benchmarks de explotación se duplicaron con creces frente a 5.2). Útil para investigación de seguridad, y una razón para mantener los permisos de los agentes ajustados de todos modos.
Especificaciones técnicas
| Feature | GLM-5.3 |
|---|---|
| Parameters | 744B total / 40B active |
| Context Length | 1M tokens |
| Max Output | 128K tokens |
| Modality | Text only |
| Terminal-Bench 2.1 | 88.2% |
| Terminal-Bench 3.0 | 28.3 (open SOTA) |
| DeepSWE v1.1 | 66.9 |
| Input Cost | $1.40/M tokens ($0.26 cached) |
| Output Cost | $4.40/M tokens |
| License | GLM-5.3 License (MIT-style, with a $10B-revenue MaaS clause) |
La escalera de velocidad de Z.ai
Desde mediados de septiembre Z.ai envía cuatro niveles de throughput de la misma familia de modelos. Conviene saberlo antes de elegir un endpoint:
- GLM-5.3-Flash ($0.15/$0.50): el nivel económico, cubierto abajo
- GLM-5.3-FlashX (18 de septiembre, $0.37/$1.25, caché $0.09): hasta ~200 tok/s
- GLM-5.3 ($1.40/$4.40): el conductor diario respaldado por pesos
- GLM-5.3-Prime (23 de septiembre, $2.80/$8.80, caché $0.56): 1.5-2x de throughput, solo texto
FlashX y Prime son solo API. No encontré pesos de ninguno en Hugging Face a 16 de octubre. Si necesitas pesos descargables, es Flash o el GLM-5.3 completo.
Fortalezas
- Terminal-Bench 3.0 con 28.3: SOTA abierto, desde el 4.6 de GLM-5.2; Fable 5 consigue 33.7 y GPT-5.6 Sol 34.6, así que está cerca de la frontera en el bench más difícil
- FrontierSWE 78.1: La mejor puntuación abierta de esa suite en la tabla de lanzamiento
- 1M de contexto, 128K de salida: El mismo sobre que los buques insignia propietarios
- Tres protocolos de API: OpenAI Chat Completions, OpenAI Responses y Anthropic Messages, así que las herramientas estilo Claude Code funcionan directamente
- Mismo precio que 5.2: $1.40/$4.40 sin cambios pese al salto de capacidad
Anomalía de precios de GLM: verifica antes de presupuestar
OpenRouter lista actualmente z-ai/glm-5.3 a $0.079 de entrada / $4.80 de salida, y z-ai/glm-5.3-flash a $0.031/$0.61. Esas tarifas de entrada están muy por debajo de los precios de lista propios de Z.ai en las tablas de arriba. O Z.ai recortó los precios de lista, o hay una promoción, o el router factura un nivel de contexto más barato. Las tablas de este artículo usan los precios de lista directos de Z.ai. Revisa z.ai directamente antes de presupuestar con las tarifas de OpenRouter.
GLM Coding Plans
Los GLM Coding Plans funcionan con una cuota basada en puntos. Las llamadas en horario valle, incluido todo el día en fin de semana, consumen la mitad de los puntos estándar. GLM-5.3 está disponible en todos los niveles del plan.
Mejores casos de uso
- Agente de codificación de uso diario: El perfil de codificación abierto más completo
- Trabajo de terminal de largo horizonte: Las ganancias en TB 3.0 sugieren que aguanta donde otros modelos se desarman
- Stacks estilo Claude Code: Endpoint nativo de Anthropic Messages
- Autoalojamiento a escala: Pesos FP8 y BF16 en Hugging Face y ModelScope, pero 744B es territorio de cluster
3. DeepSeek-V4.1-Flash: el rey de la eficiencia
DeepSeek-V4.1-Flash se publicó el 10 de septiembre bajo MIT, y es la arquitectura más interesante de esta lista. Usa un diseño Causal Encoder-Decoder: 552B de parámetros totales, pero solo 8B activos al leer tu entrada y 16B al generar salida. Combinado con el cacheo KV en FP4, su caché KV de trabajo es de unos 890 bytes por token, aproximadamente una cuarta parte del de su predecesor. En términos llanos: está construido para que servir bucles de agentes de un millón de tokens salga barato.
Los números reportados por el proveedor son agresivos: Terminal-Bench 2.1 con 90.6% y DeepSWE 74.2, por encima del 70.0 de Fable 5 y el 73.0 de GPT-5.6 Sol. Trátalos como ejecuciones propias de DeepSeek hasta que llegue más verificación de terceros, y revisa el leaderboard en vivo antes de citarlos como récords. Lo curioso: Artificial Analysis le da 39 en el Intelligence Index, muy por debajo de sus resultados de codificación, porque ese índice premia la amplitud y V4.1-Flash es un especialista.
Especificaciones técnicas
| Feature | DeepSeek-V4.1-Flash |
|---|---|
| Parameters | 552B MoE |
| Active Parameters | 8B on input / 16B on output |
| Context Length | 1M tokens |
| Max Output | 384K tokens |
| Modality | Text + image input |
| Terminal-Bench 2.1 | 90.6% (vendor-run) |
| DeepSWE v1.1 | 74.2 (vendor-run) |
| Terminal-Bench 3.0 / 4.0 | 30.0 / 31.2 |
| Input Cost | $0.30/M peak, $0.15/M off-peak |
| Output Cost | $1.20/M peak, $0.60/M off-peak |
| Cache Hit | $0.006/M peak, $0.003/M off-peak |
| License | MIT |
Precios y condiciones verificados sin cambios contra los docs de la API de DeepSeek el 16 de octubre de 2026. Las ventanas pico son 01:00-04:00 y 06:00-10:00 UTC entre semana.
Lo que hace bien
- Prefill con 8B activos: Las cargas de agentes intensivas en entrada (volcados de repos, salidas de herramientas, prompts largos) cuestan una fracción de las lecturas densas
- 90.6% en Terminal-Bench 2.1 y 74.2 en DeepSWE reportados por el proveedor: Por delante de las puntuaciones publicadas de Fable 5 y GPT-5.6 Sol en las mismas suites, si las ejecuciones se sostienen
- Mitad de precio en horario valle, y los fines de semana cuentan: Todo lo que esté fuera de las dos ventanas pico entre semana se factura al 50%, incluido todo el fin de semana y los festivos públicos chinos. Programa tus evals y ejecuciones nocturnas en consecuencia
- Salida máxima de 384K: El mayor presupuesto de salida de la lista, útil para generar archivos largos
- Pesos MIT desde el día uno: Lanzamiento abierto de verdad, con un informe técnico de 51 páginas
Notas de plataforma que conviene saber
- Los nombres de modelo actuales de la API son
deepseek-flashydeepseek-v4-pro. Los nombres heredadosdeepseek-v4-flashydeepseek-v4-flash-vision-expestán retirados pero aún se aceptan, facturados a precio de Flash. Actualiza tus configuraciones de todos modos. - URL base en formato Anthropic:
https://api.deepseek.com/anthropic. Apunta los clientes compatibles con Claude Code a esta y el resto de las herramientas funciona. El mismo truco aplica en nuestra guía de la app Codex con cualquier modelo. - Límites de concurrencia: 2500 para Flash frente a 500 para Pro. Dimensiona las flotas de agentes en consecuencia.
- Las APIs de Search y Fetch cuestan $0.75 por cada 1,000 peticiones exitosas, y DeepSeek Harness está en developer preview para quienes construyen harnesses de agentes.
Cuándo usarlo
- Agentes siempre activos con presupuesto: $0.30/$1.20 en pico, la mitad en valle
- Codificación de terminal y a nivel de repo: Donde su perfil de benchmarks es más fuerte
- Experimentos de autoalojamiento: Pesos MIT más la historia de serving más eficiente en caché de la lista
- Sáltalo si: necesitas trabajo amplio de conocimiento general; su índice AA muestra las contrapartidas de la especialización. Un V4.1-Pro viene en camino para eso.
4. GLM-5.3-Flash: el monstruo del precio
GLM-5.3-Flash se lanzó el 26 de agosto bajo MIT, y reorganizó en silencio el nivel económico. 320B totales, 18B activos, con una pila de atención híbrida que intercala 34 capas de atención lineal KDA con 11 capas de atención dispersa en un patrón 3:1. Eso recorta el cómputo de atención unas 3x y la caché KV unas 4.4x frente a GLM-5.3. También es el primer GLM-5 nativamente multimodal, con entrada de imagen y video.
La clave es el precio: $0.15/M de entrada y $0.50/M de salida, con $0.03 en caché. Puntúa 84.3% en Terminal-Bench 2.1, 63.4 en DeepSWE, y mantiene AA Intelligence 42. Dato curioso: antes del lanzamiento circuló por OpenRouter y OpenCode como el modelo anónimo “Ox Alpha” que la gente intentaba identificar.
Especificaciones técnicas
| Feature | GLM-5.3-Flash |
|---|---|
| Parameters | 320B total / 18B active |
| Context Length | 1M tokens |
| Architecture | Hybrid KDA linear + sparse attention |
| Multimodal | Text, image, video input |
| AA Intelligence | 42 |
| Terminal-Bench 2.1 | 84.3% |
| DeepSWE v1.1 | 63.4 |
| Input Cost | $0.15/M tokens ($0.03 cached) |
| Output Cost | $0.50/M tokens |
| License | MIT |
Haiku 5.5 cambió la cuenta económica
Claude Haiku 5.5 se lanzó el 7 de octubre a $0.10/$0.50 con AA 43. Frente a GLM-5.3-Flash (AA 42, $0.15/$0.50) eso es entrada más barata y una puntuación de índice más alta sobre el papel. El argumento abierto honesto es ahora: pesos MIT, un modelo de 320B que cabe en un nodo multi-GPU, aciertos de caché a $0.03, entrada de imagen y video, y sin vendor lock-in. Si no necesitas nada de eso, Haiku es la compra más simple hoy.
Lo que hace bien
- Precio $0.15/$0.50: El modelo abierto más barato de la lista a precio de lista, y supera a GLM-5.2 (que costaba ~9x más) en cada bench reportado
- AA Intelligence 42: A cuatro puntos del buque insignia GLM-5.3
- Multimodalidad nativa: Entrada de imagen y video a precios económicos
- Perfil 320B/18B: El objetivo de autoalojamiento más práctico entre los grandes lanzamientos; los pesos FP8 caben en un solo nodo multi-GPU
- El único económico con pesos descargables a esta puntuación: Haiku 5.5 no los tiene
- GDPval-AA 1773 Elo: Puntuación sólida de trabajo real para tareas de oficina
Mejores casos de uso
- Modelo por defecto para todo lo barato: Sigue siendo mi elección económica de pesos abiertos; M3 tiene su lugar vía el MiniMax Token Plan si quieres una suscripción fija en lugar de facturación por token
- Stack de codificación autoalojado: Licencia MIT, soporte vLLM/SGLang, un nodo en lugar de un cluster
- Multimodal con presupuesto: De captura de pantalla a código y comprensión de video sin pagar precios de K3
- Bucles de agentes de alta frecuencia: Los aciertos de caché a $0.03/M hacen las sesiones calientes casi gratis
- ¿Necesitas más velocidad? GLM-5.3-FlashX corre hasta ~200 tok/s a $0.37/$1.25 (solo API)
5. Kimi K3: siguen siendo los pesos abiertos más grandes
Kimi K3 ya no está en el top tres del índice AA. AA Intelligence 44 ahora lo deja empatado con Step 5 Preview, efectivamente cuarto en el orden de AA: MiMo-V2.6-Pro 46, GLM-5.3 45, Step 5 Preview 44, K3 44. Lo que no ha cambiado: con 2.8T de parámetros sigue siendo el lanzamiento abierto más grande, y sus números de codificación se mantienen. Terminal-Bench 2.1 con 88.3%, DeepSWE 67.5, SWE-Marathon 42.0, FrontierSWE 81.2 y BrowseComp 91.2 para agentes de investigación web.
Desde el 18 de septiembre también está disponible de forma general en Amazon Bedrock, lo que importa si tu organización quiere la historia del modelo de pesos dentro de un perímetro de seguridad de AWS con caché de prompts. Esa es una afirmación de septiembre que no he podido reverificar en esta ronda; revisa los docs de Bedrock si es un factor decisivo para ti.
La salvedad de precios de la versión original de esta guía sigue vigente: $3/M de entrada y $15/M de salida es dinero casi de frontera. Los aciertos de caché a $0.30/M son lo que lo mantiene cuerdo en bucles de codificación calientes. Si tu tasa de aciertos de caché es mala, MiMo-V2.6-Pro hace trabajo comparable por una séptima parte del precio de salida. Y si enrutas por OpenRouter en lugar de ir directo, moonshotai/kimi-k3 factura unos $0.304 de entrada / $12.53 de salida / $0.21 de caché a 16 de octubre, aproximadamente un 17% menos en salida que la tarifa directa.
Especificaciones técnicas
| Feature | Specification |
|---|---|
| Total Parameters | 2.8T (MoE, 16 of 896 experts) |
| Active Parameters | ~104B |
| Context Length | 1M tokens |
| Architecture | MoE + Kimi Delta Attention |
| Multimodal | Text, image, video input |
| AA Intelligence | 44 (tied #3 open weights) |
| Terminal-Bench 2.1 | 88.3% |
| BrowseComp | 91.2 |
| Input Cost | $0.30/M cache-hit / $3.00/M fresh |
| Output Cost | $15.00/M |
| License | Kimi K3 License (open weights) |
Lo que destaca
- 2.8T de pesos abiertos: Nada más descargable llega a este tamaño; autoalojarlo significa un cluster de verdad, no un mini PC
- FrontierSWE 81.2: La mejor puntuación de esa suite en su tabla de lanzamiento
- BrowseComp 91.2: Sigue siendo la elección para agentes de investigación web
- Vía GA en Bedrock: Modelo de pesos abiertos con caché de prompts explícita dentro de un perímetro de seguridad AWS
- 1M de contexto + multimodal: Imagen y video en las mismas sesiones largas
Cuándo usarlo
- Codificación dura y maratones de agentes: Liderazgo en FrontierSWE y SWE-Marathon entre modelos abiertos
- Agentes de investigación intensivos en web: BrowseComp 91.2
- Tiendas AWS: Bedrock con cacheo desde el 18 de septiembre
- Sáltalo si te preocupa el precio: $15/M de salida es lo más alto de la lista por un amplio margen
6. Qwen3.8-Max y los pesos abiertos de 2.4T
Alibaba está manejando Qwen 3.8 como dos productos con un solo nombre. Qwen3.8-Max es la API alojada a $2/$6 por millón de tokens, activa desde el 3 de agosto y refrescada el 2 de septiembre como Qwen3.8-Max-0902. Ese snapshot debutó en el #1 del leaderboard Code Arena WebDev de Arena con 1,691 puntos, superando a Claude Opus 5 por 3 puntos y a Kimi K3 por 17. Sus puntuaciones en Terminal-Bench 3.0 y ProgramBench se duplicaron con creces frente a la build de lanzamiento. Si tu trabajo es frontend y “vibe coding”, esta es la opción más fuerte del ecosistema abierto ahora mismo.
La mitad descargable es Qwen3.8-2.4T-A95B, lanzado el 12 de agosto: 2.4T de parámetros, 95B activos, atención híbrida lineal más completa, 262K de contexto nativo extensible a 1M, bajo una licencia Qwen personalizada. Los quants comunitarios MXFP4/NVFP4 lo comprimen a unos 1.2TB, lo que cabe en un solo nodo B300 de 8 GPUs. Una pega: el post-entrenamiento 0902 de septiembre es solo API por ahora, así que los pesos van por detrás del modelo alojado. Confirmado el 16 de octubre: la org de Qwen no muestra nuevos pesos 3.8 desde agosto (solo los modelos de seguridad Qwen3Guard-Stream y Qwen-Image-2.1).
Especificaciones técnicas
| Feature | Qwen3.8-Max / Qwen3.8-2.4T-A95B |
|---|---|
| Parameters | 2.4T total / 95B active |
| Context Length | 1M API / 262K native on weights |
| Code Arena WebDev | 1691 (#1, 0902 snapshot) |
| AA Intelligence | 45 (0902 API) / ~40 (open weights) |
| Terminal-Bench 2.1 | 86.6% vendor / 88.8% independent (AA) |
| Input Cost | $2.00/M tokens ($0.25 cache read) |
| Output Cost | $6.00/M tokens |
| License | Custom Qwen license (open weights) |
Esa división de AA importa. El modelo de API que puedes llamar hoy puntúa 45, lo que supera a GLM-5.3 por poco. Los pesos que puedes descargar aún puntúan alrededor de 40. Si tu eval dice “Qwen3.8-Max”, asegúrate de saber cuál ejecutó.
Lo que ofrece
- #1 en Code Arena WebDev: Primer modelo chino en encabezar ese leaderboard; aviso justo, mide sobre todo generación de UI de una sola pasada
- Pesos abiertos a escala Max: Primer lanzamiento de clase Qwen-Max con pesos descargables
- Precio de API $2/$6: Aproximadamente una quinta parte de la tarifa de salida de Fable 5.1
- API con contexto de 1M: Con cacheo implícito de prefijos a $0.25/M
- Hermanos menores: Qwen3.8-27B y Qwen3.8-Flash-Next si 2.4T es demasiado hierro. También hay un SKU de throughput Qwen3.8-Max-Prime a $4/$12 (23 de septiembre)
Cuándo usarlo
- Frontend y diseño-a-código: El liderazgo en la arena WebDev es todo el argumento
- Comodidad de API más una salida a pesos: Empieza en QwenCloud, conserva la opción de autoalojar el 2.4T
- Autoalojamiento de clase frontera: Si tienes el nodo para ello, este es el segundo modelo abierto más grande después de K3
- Sáltalo si: necesitas las mejoras de septiembre on-prem hoy; el checkpoint 0902 es solo alojado por ahora
Para cobertura complementaria de los modelos Qwen más pequeños y cómo se comportan dentro de los agentes de codificación, consulta nuestra guía de modelos Qwen para agentes de codificación con IA.
7. Step 5 Preview: el nuevo modelo abierto #3
StepFun lanzó Step 5 Preview el 18 de septiembre y pasó en gran parte desapercibido hasta que el índice AA lo alcanzó. Es un MoE de 600B totales / 27B activos con contexto de 1M, y AA Intelligence 44 lo pone en el #3 entre modelos de pesos abiertos en el propio orden de AA, un pelo por delante de Kimi K3. En eficiencia por parámetros activos es el mejor trato del top cinco abierto: 27B activos es un tercio de los 42B de MiMo.
Los pesos están en Hugging Face como stepfun-ai/Step-5-Preview, con variantes oficiales BF16 y NVFP4 más quants comunitarios GGUF y MLX. Las descargas todavía son bajas (cientos a miles bajos), así que trátalo como algo temprano.
Especificaciones técnicas
| Feature | Step 5 Preview |
|---|---|
| Parameters | 600B total / 27B active (MoE) |
| Context Length | 1M tokens |
| Modality | Text (check the model card for multimodal support) |
| AA Intelligence | 44 (#3 open weights) |
| Weights | BF16, NVFP4, community GGUF/MLX |
| Input / Output Cost | TBD, check StepFun’s platform |
| License | StepFun Model License 1.0 (custom) |
Checkpoint preview y licencia personalizada
Dos razones para no hacerlo tu default de producción todavía. Primero, literalmente se llama Preview, el número de descargas es bajo, y el precio de API no está confirmado a 16 de octubre. Segundo, StepFun Model License 1.0 es personalizada con términos de ingresos. Lee la licencia antes de uso comercial, igual que harías con la cláusula MaaS de GLM. Vigila este: si StepFun lo precia por debajo de los $3/$15 de K3, se convierte en el modelo abierto por defecto para tareas difíciles.
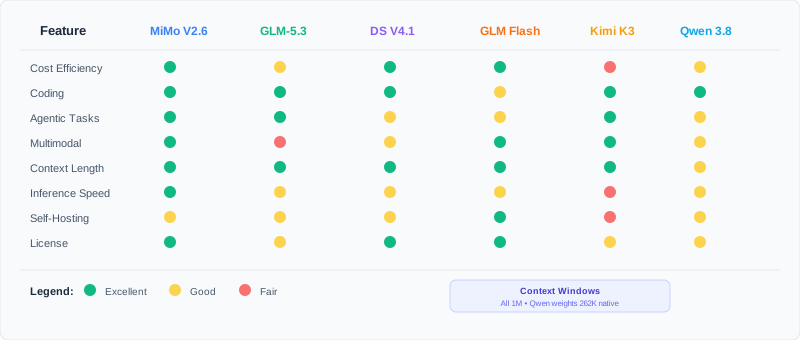
LLMs open source vs Claude Opus 5.5 y GPT-6.1: comparación lado a lado
Números a 16 de octubre de 2026. “n/a” significa no publicado o no comparable en esa suite exacta. Las columnas de DeepSWE y Terminal-Bench mezclan ejecuciones de proveedores y de terceros; los números de fuente única reciben menos confianza. Lee la tabla así: en el nivel de $2/$10 el argumento es capacidad por dólar, y en el nivel de $0.10/$0.50 son los pesos y el autoalojamiento.
| Model | AA | DeepSWE v1.1 | TB 2.1 | Context | Open weights | In $/M | Out $/M |
|---|---|---|---|---|---|---|---|
| Claude Opus 5.5 | 58 | 74.0* | n/a | 1M | No | $4.00 | $20.00 |
| Claude Sonnet 5.5 | 56 | n/a | n/a | 1M | No | $2.00 | $10.00 |
| Claude Fable 5.1 | 53 | 70.0 | n/a | 1M | No | $10.00 | $50.00 |
| GPT-6 Astra | 53 | n/a | n/a | 1.05M | No | $10.00 | $50.00 |
| Gemini 4 Argon | 53 | n/a | n/a | 1M | No | $2.00 | $10.00 |
| Muse Wonder | 52 | n/a | n/a | 1M | No | TBD | TBD |
| GPT-6.1 Sol | 52 | n/a | n/a | 1.05M | No | $2.00 | $10.00 |
| MiMo-V2.6-Pro | 46 | 71.9 | 89.9% | 1M | MIT | $0.435 | $0.87 |
| GLM-5.3 | 45 | 66.9 | 88.2% | 1M | GLM lic. | $1.40 | $4.40 |
| Qwen3.8-Max | 45 (API) / ~40 (wts)† | 56.6 | 86.6% | 1M API / 262K wts | Custom | $2.00 | $6.00 |
| Step 5 Preview | 44 | n/a | n/a | 1M | StepFun lic. | TBD | TBD |
| Kimi K3 | 44 | 67.5 | 88.3% | 1M | Kimi lic. | $3.00 | $15.00 |
| Claude Haiku 5.5 | 43 | n/a | n/a | 1M | No | $0.10 | $0.50 |
| GLM-5.3-Flash | 42 | 63.4 | 84.3% | 1M | MIT | $0.15 | $0.50 |
| DeepSeek V4.1 Flash | 39 | 74.2 | 90.6% | 1M | MIT | $0.15-0.30 | $0.60-1.20 |
| Muse Spark Open | 39 | n/a | n/a | 1M | Muse lic. | TBD | TBD |
| GPT-6 Luna | 38 | n/a | n/a | 1M | No | $0.10 | $0.50 |
| MiniMax M3 | 29 | n/a | n/a | n/a | n/a | $0.30 | $1.20 |
*Cifra de Opus 5 donde Opus 5.5 no tiene ejecución de DeepSWE publicada; Anthropic sitúa a 5.5 aproximadamente al nivel de Fable 5.1. †AA puntúa el snapshot 0902 de la API en 45 y los pesos abiertos 2.4T-A95B en alrededor de 40. Los precios de Kimi K3 mostrados son de lista directa; OpenRouter factura $0.304/$12.53. MiniMax M3 es el listado de OpenRouter, ver las notas al pie de precios abajo. La entrada de DeepSeek es $0.30 en pico / $0.15 en valle.
Cómo ejecutar estos LLMs open source (OpenRouter, API directa o autoalojados)
Paso 1: Elige tu vía de acceso
OpenRouter
Una clave API para cada modelo de este artículo, incluidas las filas propietarias contra las que quieres comparar. Lo mejor para evaluación y flotas mixtas. Paga por token, sin compromisos. Si estás comparando cinco modelos esta semana, hazlo aquí primero.
API directa
Mejores límites de tasa, precios de plan y ventanas de horario valle (Z.ai, DeepSeek, Xiaomi MiMo, Qwen y Kimi tienen sus propios endpoints). Elige esta cuando sepas qué uno o dos modelos cargan tu trabajo. DeepSeek también expone un endpoint en formato Anthropic para clientes estilo Claude Code.
Autoalojado
GLM-5.3-Flash (320B) es la opción realista de un solo nodo. Los checkpoints MiMo MOPD y el distill de 9B son los otros objetivos prácticos. K3, Qwen 2.4T y Step 5 Preview piden clusters de verdad. El autoalojamiento gana en localidad de datos y volumen sostenido, no en la factura de tu primer mes.
- OpenRouter: Una clave, todos los modelos de esta lista, la forma más rápida de comparar
- APIs directas de proveedor: Mejores límites de tasa y precios de plan (Z.ai, DeepSeek, Xiaomi MiMo, Qwen, Kimi)
- Acceso a agentes de tarifa plana: La review de OpenCode Go (31 modelos de IA por $10/mes) cubre una suscripción fija que incluye varios modelos de esta lista, vía un agente de codificación OpenCode Go
- Una clave para tus herramientas CLI: Agent Router (Claude Code, Codex, Gemini CLI detrás de una clave) si ejecutas varios CLIs de codificación y no quieres configuración por proveedor
- Autoalojamiento: GLM-5.3-Flash (320B) es la opción realista de un solo nodo; K3 y Qwen 2.4T piden un cluster. Ver las notas de autoalojamiento abajo
- Enrutado por gateway: Autoaloja un gateway de LLM con LiteLLM cuando quieres un endpoint compatible con OpenAI delante de cada proveedor
- Herramientas de agentes: OpenCode, endpoints compatibles con Claude Code, Hermes, configuraciones de Codex con cualquier modelo. Para la máquina de debajo, una configuración de VPS para agentes de codificación con IA es suficiente para ejecutar todo excepto los pesos autoalojados. Un VPS barato de Hetzner es mi opción por defecto cuando la carga es solo API
Paso 2: Entorno (ejemplo con OpenRouter)
# Install OpenAI SDK
pip install openai

# Set environment variables
export OPENROUTER_API_KEY="your_api_key_here"
export OPENROUTER_BASE_URL="https://openrouter.ai/api/v1"
Verifica la clave antes de escribir código:
curl -s https://openrouter.ai/api/v1/models \
  -H "Authorization: Bearer $OPENROUTER_API_KEY" | head
Quieres JSON de vuelta. Si obtienes una página de error HTML o un 401, arregla primero la clave o la ruta de red.
Paso 3: Primera llamada, dos modelos lado a lado
import openai

client = openai.OpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key="your_openrouter_api_key"
)

def ask(model: str, prompt: str) -> str:
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}]
    )
    usage = response.usage
    print(f"{model}: {usage.prompt_tokens} in / {usage.completion_tokens} out")
    return response.choices[0].message.content

prompt = "Create a Python web scraper for product prices"

# The open coding workhorse vs the new proprietary budget tier
print(ask("z-ai/glm-5.3", prompt))
print(ask("anthropic/claude-haiku-5.5", prompt))
La misma llamada en curl si solo quieres ver la forma de la respuesta:
curl https://openrouter.ai/api/v1/chat/completions \
  -H "Authorization: Bearer $OPENROUTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"z-ai/glm-5.3","messages":[{"role":"user","content":"Create a Python web scraper for product prices"}]}'
Nota sobre DeepSeek: el nombre de modelo actual de la API es deepseek-flash (sirviendo V4.1-Flash), y si quieres el formato Anthropic Messages la URL base es https://api.deepseek.com/anthropic. Los nombres heredados como deepseek-v4-flash aún resuelven, facturados a precio de Flash, pero no construyas nuevas configuraciones sobre ellos.
Paso 4: Ajusta el contexto al trabajo
Longitud de contexto
Todos los modelos aquí anuncian una ventana de 1M de tokens, pero el contexto largo no es gratis: los proveedores cobran más al superar umbrales (GPT-6 se reprecia por encima de 272K de entrada), y los pesos abiertos de Qwen solo hacen 262K de forma nativa antes de la extensión. Para opciones baratas de contexto largo, mira nuestra guía de mejores modelos baratos para Hermes Agent.
Paso 5: Verifica que funciona
Tres comprobaciones que toman cinco minutos y ahorran una tarde:
- La respuesta tiene contenido y
response.modelcoincide con lo que pediste. Los proveedores sustituyen modelos en silencio más a menudo de lo que admiten. - Registra el bloque de uso y ponle precio a una tarea real. Multiplica
prompt_tokensycompletion_tokenspor las tarifas de lista. Compara eso contra la misma tarea en Haiku 5.5 u Opus 5.5. Tu costo por resultado útil es el número que importa. - Ejecuta el mismo prompt por dos modelos y haz diff de la calidad de salida. Esto es “mide en tu dominio” hecho ejecutable. Hazlo en una tarea cuya respuesta conoces, no en un prompt de juguete.
Errores comunes
- 401 Unauthorized: clave mala, o la clave no tiene acceso a ese modelo. En OpenRouter, algunos modelos necesitan créditos extra o allowlisting.
- 402 Payment Required: sin crédito. Recarga, luego reenvía la petición exacta antes de depurar cualquier otra cosa.
- 404 Not Found: IDs de modelo renombrados. Esto es lo que golpeó a los usuarios de
deepseek-v4-flash; usadeepseek-flash. Busca en el endpoint de lista de modelos del proveedor el ID actual. - 429 Too Many Requests: concurrencia, no cuota. DeepSeek permite 2500 concurrentes en Flash y 500 en Pro. Retrocede y reintenta con jitter.
Notas de autoalojamiento
Si vas a servir pesos tú mismo, las opciones prácticas a octubre de 2026:
- MiMo-V2.6-Pro-MOPD / Flash-MOPD (MIT): Descarga el tag MOPD, no el lanzamiento original de septiembre. El checkpoint MOPD corrige el bucle de repetición de llamadas a herramientas descrito antes
- MiMo-V2.6-Distill-Qwen-9B (MIT): La opción para máquinas pequeñas. Puedes ejecutar modelos locales con Ollama en Docker para un stack de serving contenido
- GLM-5.3-Flash (MIT, 320B/18B): La elección de un solo nodo multi-GPU entre los modelos grandes. Pesos FP8
- Step 5 Preview y Muse Spark Open: Existen quants BF16/NVFP4/GGUF/MLX desde el día uno, pero ambos son tempranos (checkpoint Preview, y Spark se lanzó el 15 de octubre). Bien para experimentos, no para fijar producción
No copies flags de serving no verificados
No publico comandos de lanzamiento de vLLM o SGLang para estos modelos aquí a propósito. Las matrices de soporte se mueven semanalmente y un --tensor-parallel-size o flag de cuantización equivocado desperdicia una tarde. Revisa la ficha de Hugging Face de cada modelo para las instrucciones de serving actuales antes de arrancar el servidor. Para el lado del agente del sandbox, ejecuta herramientas CLI de IA de forma segura en Docker o Podman.
Dos notas de operaciones.
El rollback es aburrido, que es la idea. Un modelo autoalojado es pesos más un proceso de API. Fija un tag de checkpoint en tu config de despliegue, y revertir una mala actualización es redesplegar el tag anterior. No hay migración, no hay cambio de formato de datos.
Cuentas de costo antes de comprar hierro. Un modelo de clase 320B (GLM-5.3-Flash) necesita un nodo multi-GPU. Un modelo de clase 2.4T (Qwen3.8, K3) necesita un nodo de clase 8 GPUs. A los volúmenes de la siguiente sección (10M de entrada + 10M de salida al mes) el gasto de API es $6.50 para GLM-5.3-Flash y $80-$180 para Qwen3.8-Max y Kimi K3. El hardware solo gana cuando necesitas localidad de datos, volumen mucho mayor sostenido, o cargas intensivas en caché que preferirías no medir. Para el extremo de huella pequeña de la escala, consulta mejores mini PCs para LLMs locales.
Divulgación de afiliados
Los enlaces de hardware de abajo son enlaces de afiliado, incluidos los redirects /go/ que aterrizan en Amazon. Si compras a través de ellos, gano una pequeña comisión sin costo extra para ti.
Si compras hardware, nada de esto ejecuta los modelos de 320B+ de arriba. Lo que una máquina casera puede ejecutar es el extremo pequeño: MiMo-V2.6-Distill-Qwen-9B y la clase cuantizada de 30B-120B.
| Máquina | Precio (23 oct, 2026) | Para qué sirve |
|---|---|---|
| Mac mini M6 16GB | $779 | Ejecutar el agente contra modelos API, más un distill de 9B localmente. Ver el mejor Mac mini para OpenClaw |
| Desktop con una RTX 5060 Ti 16GB | $765.99 por la tarjeta | Modelos de 9B-14B rápidos, con CUDA para vLLM o SGLang. Ver la sección de máquina con GPU |
| GMKtec EVO-X2 128GB | $3,649.99 | Quants de 70B densos y MoE de clase 120B, lentamente. El mini PC de 128GB más barato de la guía de LLM local |
Desglose de costos: lo que realmente cuestan estos modelos de codificación con IA baratos
Costo mensual ilustrativo con 10M de tokens de entrada + 10M de salida, a tarifas de lista de API a 16 de octubre de 2026. Las facturas reales se mueven con aciertos de caché, planes, descuentos por lote y horarios valle. Opus 5.5 es la línea base.
Comparación de costo mensual (10M entrada + 10M salida)
| Model | Input | Output | Total | vs Opus 5.5 | AA |
|---|---|---|---|---|---|
| GPT-6 Astra | $100 | $500 | $600 | 150% más | 53 |
| Claude Fable 5.1 | $100 | $500 | $600 | 150% más | 53 |
| Claude Opus 5.5 | $40 | $200 | $240 | Base | 58 |
| Kimi K3 (entrada fresca) | $30 | $150 | $180 | ~25% menos | 44 |
| Kimi K3 (entrada cacheada) | $3 | $150 | $153 | ~36% menos | 44 |
| Claude Sonnet 5.5 | $20 | $100 | $120 | 50% menos | 56 |
| GPT-6.1 Sol | $20 | $100 | $120 | 50% menos | 52 |
| Gemini 4 Argon | $20 | $100 | $120 | 50% menos | 53 |
| Qwen3.8-Max | $20 | $60 | $80 | ~67% menos | 45 / ~40 |
| GLM-5.3 | $14 | $44 | $58 | ~76% menos | 45 |
| DeepSeek V4.1 Flash (pico) | $3 | $12 | $15 | ~94% menos | 39 |
| MiniMax M3 | $3 | $12 | $15 | ~94% menos | 29 |
| MiMo V2.6 Pro | $4.35 | $8.70 | $13.05 | ~95% menos | 46 |
| DeepSeek V4.1 Flash (valle) | $1.50 | $6 | $7.50 | ~97% menos | 39 |
| GLM-5.3-Flash | $1.50 | $5 | $6.50 | ~97% menos | 42 |
| Claude Haiku 5.5 | $1 | $5 | $6 | ~97% menos | 43 |
| GPT-6 Luna | $1 | $5 | $6 | ~97% menos | 38 |
Dos notas al pie de precios
MiniMax M3: la tarifa de $0.30/$1.20 por millón es el listado de OpenRouter a 16 de octubre. Un borrador anterior de esta tabla fue señalado como posiblemente duplicando la fila de DeepSeek (los totales son idénticos porque las tarifas son idénticas). Revisa los precios directos de MiniMax, o el MiniMax Token Plan si quieres una suscripción fija en su lugar.
Reprecio de la familia GPT-6: las peticiones de más de 272K tokens de entrada se reprecian a $20/$75 en facturación clase Astra. Los pesos abiertos de Qwen solo hacen 262K nativamente antes de la extensión. El contexto largo es donde las cuentas de “barato por millón” se rompen.
El remate cambió desde septiembre. En el gasto de clase $6/mes el nivel propietario ahora iguala el precio de etiqueta abierto: Haiku 5.5 y Luna aterrizan en $6 con esta cuenta. Eliges modelos abiertos de todos modos por los pesos, el autoalojamiento, los precios en valle y por lote, y la ausencia de límites de tasa. Y la cima del campo abierto (MiMo 46, GLM-5.3 45) sigue costando $13-$58 a este volumen mientras supera a Haiku por 2-3 puntos AA y a Luna por 7-8. El trato: $6 te compra 43 (Haiku) o 38 (Luna) sin pesos, o $6.50 te compra 42 con pesos MIT y aciertos de caché a $0.03.
Dos notas al pie más sobre esa tabla. GPT-6 Astra y Fable 5.1 a $600 compran la cima del índice solo si tu carga de trabajo necesita AA 53-58. La mayoría del trabajo de agentes de codificación no lo necesita. Y los $15/M de salida de Kimi K3 significan que su fama de “barato” solo se sostiene cuando tu tasa de aciertos de caché de entrada se mantiene alta.
Si prefieres pagar una tarifa plana mensual y dejar que otro haga el enrutado, el desglose de OpenCode Go vs ClinePass para acceso barato a DeepSeek, Qwen y Kimi cubre el lado de suscripción de los mismos modelos.
Consejos y errores comunes
Lo que funciona
- Empareja modelo con tarea: GLM-5.3-Flash o DeepSeek para volumen, MiMo-V2.6-Pro (MOPD) o GLM-5.3 para ejecuciones de agentes difíciles, K3 para agentes de investigación, Qwen3.8-Max para frontend. Añade Step 5 Preview a la lista de tareas difíciles cuando tenga precios reales
- Usa las ventanas valle: DeepSeek reduce a la mitad los precios fuera de sus dos ventanas pico entre semana (01:00-04:00 y 06:00-10:00 UTC), y los fines de semana más los festivos públicos chinos cuentan como valle completo. El GLM Coding Plan reduce a la mitad los puntos en valle y los fines de semana
- Prompt por modelo: Cada familia sigue teniendo sus propias manías de instrucciones
- Mide en tu dominio: Los benches de proveedores son marketing con sección de metodología; ejecuta tus propias evaluaciones
- Mantén un respaldo: Los proveedores fallan; OpenRouter convierte el cambio en una línea de configuración
Qué evitar
- Enrutar cada tarea al modelo más caro por defecto. A $20/M de salida, Opus 5.5 en refactors masivos prende fuego al dinero
- Confiar en benchmarks reportados por el proveedor sin ejecuciones independientes (los números de Terminal-Bench de DeepSeek V4.1-Flash son autorreportados por ahora)
- Dejar correr agentes sin delimitar permisos, sobre todo con la velocidad a la que crece la capacidad ciberseguridad en estos lanzamientos. Ejecuta herramientas CLI de IA de forma segura en Docker o Podman en lugar de en tu directorio home
- Ignorar la letra pequeña de las licencias: MIT es limpia, GLM-5.3 tiene una cláusula MaaS de $10B, StepFun Model License 1.0 tiene términos de ingresos, Qwen, Kimi y Muse usan licencias personalizadas
- Perderte los bucles de repetición de llamadas a herramientas. Si un agente parece ocupado pero el árbol de archivos nunca cambia, estás quemando tokens en llamadas repetidas. Cambia a un checkpoint MOPD o añade detección de bucles en el harness. El post de diagnóstico de Xiaomi describe bien el patrón
Lo que viene
- DeepSeek-V4.1-Pro: El buque insignia de la familia. Aún ausente de Hugging Face y de la API a 16 de octubre;
deepseek-v4-prosigue sirviendo DeepSeek-V4-Pro-0813 a $0.66-$1.32 de entrada / $1.98-$3.96 de salida - Pesos Qwen3.8 refrescados: El post-entrenamiento 0902 es solo API hoy. Verificado el 16 de octubre: no hay nuevos pesos 3.8 en la org de Qwen desde agosto. Un checkpoint actualizado importaría a quienes autoalojan
- Tencent Hy4: Preview de 770B en Apache-2.0, aún
tencent/hy4-previewen OpenRouter a $0.751/$2.251 y en Hugging Face con quants FP8 y GGUF comunitarios. Sin GA - GA y precios de Step 5: Si StepFun precia el modelo final por debajo de los $3/$15 de K3, se convierte en el modelo abierto por defecto para tareas difíciles
- La línea Muse de Meta: Muse Wonder (AA 52, 12 de octubre) es el buque insignia propietario; Muse Spark Open (15 de octubre, 816B/42B, AA 39, Muse Model License) es el lanzamiento abierto con quants NVFP4 y MLX desde el día uno. Lee los términos de ingresos de la licencia Muse antes de recomendar cualquiera comercialmente
- Apuestas más largas: Pesos de GLM-5.3-Prime y FlashX (ambos solo API hoy), Inkling de Thinking Machines (975B/41B, Apache-2.0, AA 25), y Beam 1.0 de Reflection (501B/23B, Apache-2.0, AA 30). Licencias interesantes, aún no contendientes de codificación
¿Qué LLM open source deberías elegir?
MiMo-V2.6-Pro si quieres:
- La puntuación de pesos abiertos más alta (AA 46) con pesos MIT
- Números agénticos fuertes (AutomationBench 53.1, DeepSWE 71.9)
- Texto + imagen + video + audio en un solo modelo
- Precio $0.44/$0.87, ~134 tok/s
- Descarga el checkpoint MOPD para trabajo de agentes
GLM-5.3 si necesitas:
- El perfil de codificación abierto más fuerte (TB 3.0 28.3, FrontierSWE 78.1)
- Un conductor diario probado con opciones de suscripción Coding Plan
- Endpoint compatible con Anthropic para herramientas estilo Claude Code
- Precios predecibles de $1.40/$4.40
DeepSeek V4.1 Flash si quieres:
- 90.6% en Terminal-Bench 2.1 y 74.2 en DeepSWE reportados por el proveedor (verifica contra el leaderboard en vivo)
- Pesos MIT y el serving de agentes serio más barato
- Precios valle que reducen a la mitad una factura ya baja, fines de semana incluidos
- Presupuesto de salida de 384K para generaciones largas
GLM-5.3-Flash si quieres:
- Precio de lista $0.15/$0.50 con pesos MIT
- Entrada nativa de imagen + video
- Un modelo de 320B que cabe en un nodo
- 84.3% en TB 2.1, cuatro puntos AA por detrás de su hermano buque insignia
Kimi K3 si quieres:
- Los pesos abiertos más grandes (2.8T)
- Agentes de investigación con BrowseComp 91.2
- Despliegue en AWS Bedrock con caché de prompts
- Puedes vivir con $15/M de salida apoyándote en los aciertos de caché
Qwen3.8-Max si te importa:
- #1 en Code Arena WebDev para trabajo de frontend
- Precio de API $2/$6 con contexto de 1M
- Una vía de pesos abiertos de 2.4T cuando estés listo para autoalojar
Step 5 Preview si quieres:
- La nueva puntuación abierta #3 (AA 44) con solo 27B parámetros activos
- Pesos de 600B con BF16/NVFP4 y quants GGUF comunitarios ya publicados
- Puedes vivir con un checkpoint preview y una licencia personalizada mientras el precio está por confirmar
Mi ranking para trabajo de agentes de codificación ahora mismo: GLM-5.3 como opción por defecto, MiMo-V2.6-Pro (MOPD) cuando la tarea es larga o multimodal, GLM-5.3-Flash para volumen cuando necesitas pesos y Haiku 5.5 cuando no, DeepSeek V4.1-Flash para bucles intensivos de terminal, y Kimi K3 o Qwen3.8-Max cuando sus fortalezas específicas (investigación, frontend) encajan con el trabajo. Step 5 Preview se une a la lista de tareas difíciles el día que tenga precios reales.
Para harnesses agénticos específicamente, la lista corta de mejores modelos open source para OpenClaw filtra este mismo conjunto por fiabilidad de llamadas a herramientas.
Una frase sobre cuándo saltarse lo abierto por completo: Claude Sonnet 5.5 con AA 56 y $2/$10 es la amenaza de valor, y si no necesitas pesos, facturación en valle o una salida de autoalojamiento, es un default defendible. Yo sigo eligiendo abierto para cualquier cosa de larga duración, porque fijar un checkpoint y servirlo tú mismo es la única versión de “este modelo seguirá existiendo el próximo trimestre” que controlas.
Preguntas frecuentes
¿Cuál es el mejor LLM open source ahora mismo?
A octubre de 2026: MiMo-V2.6-Pro mantiene la puntuación de pesos abiertos más alta en el Artificial Analysis Intelligence Index con 46, GLM-5.3 es el especialista de codificación abierto más fuerte con 45, y Step 5 Preview es el #3 en ascenso con 44. Para la mayoría del trabajo de agentes de codificación uso GLM-5.3 por defecto y cambio a MiMo-V2.6-Pro (checkpoint MOPD) para ejecuciones largas o multimodales. Revisa los números antes de comprometerte; esta tabla se mueve mensualmente.
¿Pueden los modelos open source reemplazar de verdad a Claude Opus 5.5?
Para la mayoría del trabajo de agentes de codificación, sí, al 5-10% del costo del buque insignia. El top cinco abierto maneja bien refactors, llamadas a herramientas y sesiones largas de repo. En la cima absoluta de capacidad, no: el AA 58 de Opus 5.5 sigue siendo el techo, y Fable 5.1 / Astra en 53 mantienen una ventaja en las evals agénticas más difíciles. La prueba práctica no es el benchmark, es si tus reintentos de tareas desaparecen. Ejecuta ambos durante una semana real de trabajo y compara costo por PR mergeado, no costo por millón de tokens.
¿Cuál es la forma más barata de ejecutar estos modelos?
Cuatro palancas, en orden de impacto: programa el trabajo pesado en horario valle (DeepSeek reduce a la mitad los precios fuera de sus dos ventanas pico entre semana, fines de semana incluidos), mantén altas las tasas de aciertos de caché (los aciertos de caché de DeepSeek cuestan $0.006/M, GLM-5.3-Flash cuesta $0.03/M), agrupa evals en lote en lugar de ejecutarlas interactivamente, y baja a Haiku 5.5 ($0.10/$0.50, AA 43) si puedes vivir sin pesos. Las suscripciones de tarifa plana como OpenCode Go cambian la cuenta de nuevo si tu uso es irregular.
¿Necesito una GPU para empezar?
No. OpenRouter y las APIs directas de los proveedores te dan cada modelo de este artículo sin hardware alguno. Una GPU solo es para autoalojar: GLM-5.3-Flash (320B) necesita un nodo multi-GPU, Qwen3.8 y K3 necesitan un nodo de clase 8 GPUs, y solo MiMo-V2.6-Distill-Qwen-9B es realista en hierro pequeño. Si solo quieres ejecutar un modelo de 9B localmente, Ollama en Docker es suficiente para empezar.
¿Son estas licencias seguras para uso comercial?
MIT es limpia (familia MiMo-V2.6, GLM-5.3-Flash, DeepSeek V4.1-Flash). El resto necesita una lectura: GLM-5.3 usa una licencia estilo MIT con una cláusula MaaS de $10B de ingresos, StepFun Model License 1.0 tiene términos de ingresos, y Qwen, Kimi y Muse usan todas licencias personalizadas. Ninguna de estas es “cerrada”, pero dos de ellas importarán si tu producto cruza un umbral de ingresos u ofrece el modelo como servicio. Lee el texto de la licencia, no el post del blog.
¿Listo para empezar?
La versión corta: GLM-5.3 o MiMo-V2.6-Pro (MOPD) para trabajo duro, GLM-5.3-Flash o Haiku 5.5 para volumen, DeepSeek para bucles de terminal. Todos los modelos abiertos son accesibles a través de sus proveedores y la mayoría están en OpenRouter. Si usas la app de Codex, nuestra guía de la app Codex con cualquier modelo muestra cómo conectar GLM, MiniMax y MiMo con una configuración corta. Para agentes de codificación en un VPS barato, mira la guía de configuración de OpenCode y la guía de configuración del agente de codificación Pi, y nuestra configuración de VPS para agentes de codificación con IA cubre la máquina de debajo. Precios completos y benches centrados en Hermes están en mejores modelos baratos para Hermes Agent, el mapa de herramientas está en mejores repos de IA en GitHub, y la vista orientada a agentes está en mejores herramientas y agentes de codificación con IA.