Tugtainer: Autoactualización de Contenedores Docker (Self-Hosted)
Actualiza contenedores Docker automáticamente con Tugtainer, una herramienta autoalojada con interfaz web, agentes multi-host, rollback y alertas. Mira cómo se compara con Watchtower.

Actualizado Publicado 35 min de lectura
Actualiza contenedores Docker automáticamente sin estar pendiente de docker compose pull en cada servidor. Tugtainer es una herramienta autoalojada que comprueba los registros en busca de imágenes nuevas, recrea los contenedores en orden de dependencias, revierte las actualizaciones fallidas y te cuenta qué pasó. Te da una interfaz web, agentes multi-host y control por contenedor, así que decides exactamente qué se actualiza y cuándo. Esta guía cubre el despliegue con Dokploy o Docker Compose, la configuración del agente para hosts remotos y todo lo añadido hasta la v1.41.0 (septiembre de 2026). Si eres nuevo en Docker, empieza con nuestra guía de comandos esenciales de Docker.
¿Qué es Tugtainer?
Tugtainer es una aplicación autoalojada que mantiene tus contenedores Docker al día. Compara el digest de la imagen que ejecuta cada contenedor con el del registro, marca los contenedores que tienen imágenes más recientes y los recrea según un calendario que tú controlas. Las actualizaciones ocurren en orden de dependencias y, si una imagen nueva falla su healthcheck, Tugtainer revierte el contenedor a la imagen anterior automáticamente.
Todo se ejecuta en tu infraestructura. Sin cuenta SaaS, sin tarifa por host, y las actualizaciones automáticas están desactivadas por defecto, así que activas los contenedores uno a uno. Una interfaz web con autenticación se sitúa por encima de todo, y cada servidor adicional ejecuta un agente ligero para que una sola instancia pueda gestionarlos a todos.
Así encajan las piezas:
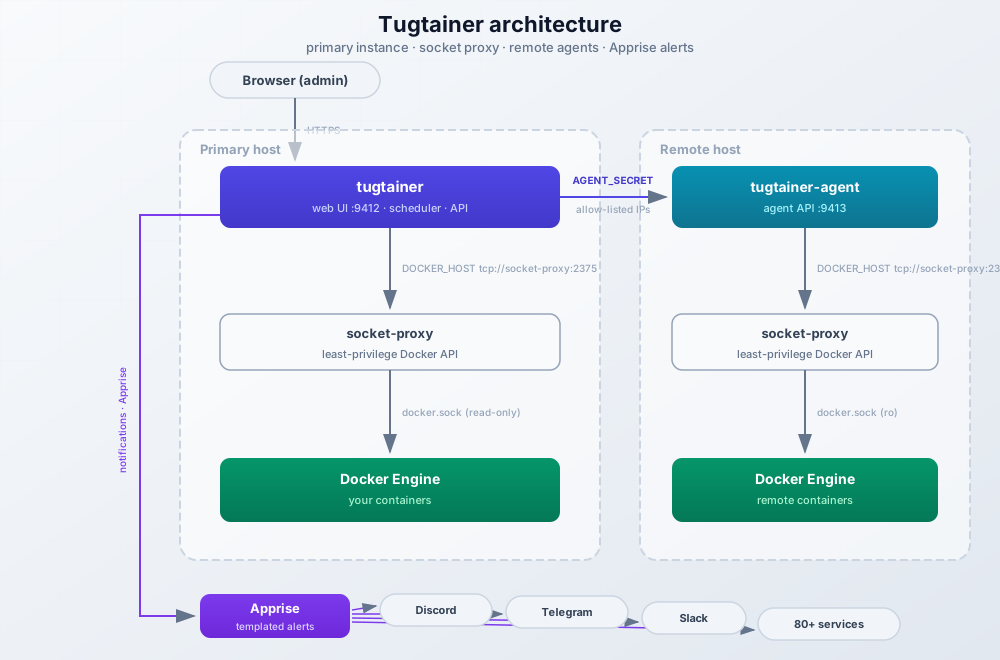
La instancia principal habla con Docker a través de un socket-proxy en lugar de montar el socket de Docker directamente, lo que limita lo que un Tugtainer comprometido podría hacer. En los hosts remotos, el agente hace el mismo trabajo localmente y expone una pequeña API para la instancia principal. Las notificaciones se distribuyen mediante Apprise a Discord, Telegram, Slack, correo electrónico y docenas de servicios más.
Prueba Hetzner Cloud Ahora Prueba un VPS de HostingerLos precios de los VPS subieron en todos los proveedores en 2026 — si estás reconsiderando un servidor alquilado, mira qué cambió y cuándo gana un mini PC.
Uso en producción
La aplicación se distribuye “tal cual” y los desarrolladores no la recomiendan para entornos de producción críticos sin pruebas previas. Las autoactualizaciones mueven tus contenedores entre versiones de imagen sin una persona supervisando, así que las copias de seguridad de los datos importantes son innegociables antes de activarlas.
Qué necesitas antes de empezar
- Un host Linux o VPS con Docker y el plugin de Compose instalados
- Puerto 9412 libre para la interfaz web de Tugtainer, más el 9413 para cada host con agente (sáltate ambos si expones la interfaz a través de Dokploy)
- Un registro DNS apuntando a tu servidor si quieres la interfaz detrás de HTTPS
- Un
AGENT_SECRETfuerte y único si planeas gestionar hosts remotos - Copias de seguridad de cualquier contenedor con estado (bases de datos, archivos subidos) hechas antes de activar las autoactualizaciones
- Credenciales de tu servicio de notificaciones: una URL de webhook de Discord, un token de bot de Telegram, datos SMTP, lo que uses
Tugtainer es gratuito y de código abierto. Funciona cómodamente en un VPS de gama de entrada de 4-5 €/mes (2 vCPU y 4 GB de RAM son de sobra) o junto a tu stack de Dokploy existente. El estado vive en el volumen tugtainer_data, así que no hay una base de datos separada que cuidar. Si prefieres ejecutarlo en casa en hardware propio, un mini PC compacto como servidor doméstico, por ejemplo el GMKtec M5 Ultra tiene margen de sobra.
Tugtainer vs Watchtower y Ouroboros
Varias herramientas pueden actualizar tus contenedores Docker automáticamente. Así se compara Tugtainer con Watchtower y Ouroboros:
| Característica | Tugtainer | Watchtower | Ouroboros |
|---|---|---|---|
| Interfaz web | Sí (con autenticación) | No | No |
| Soporte multi-host | Sí (vía agentes) | No | No |
| Notificaciones | Sí (Apprise - más de 80 servicios) | Sí | Sí |
| Actualizaciones según dependencias | Sí (automáticas) | No | No |
| Configuración | GUI | Variables de entorno | Variables de entorno |
| Registros privados | Sí | Sí | Sí |
| Control granular | Sí (por contenedor) | Sí (por contenedor) | Sí (por contenedor) |
| Monitorización de healthchecks | Sí (reinicio automático, v1.41+) | No | No |
| Soporte de socket-proxy | Sí (configuración por defecto) | No | No |
| Autoactualización | Solo manual | Sí | Sí |
| Limpieza de imágenes | Sí (automática/manual) | Sí | Sí |
Conviene saberlo: el desarrollo de Watchtower está prácticamente estancado, con pocas versiones desde 2023. Todavía funciona, pero revisa el repositorio antes de comprometerte con él.
Términos clave
- Dependency-aware (consciente de dependencias): Tugtainer construye un grafo de dependencias por host y actualiza en el orden correcto. Los servicios dependientes (como la app delante de una base de datos) se detienen primero, y luego todo se reinicia con las dependencias arrancando antes que lo que las necesita.
- Socket-proxy: un contenedor de seguridad que expone solo las llamadas a la API de Docker incluidas en la lista blanca. Tugtainer lo usa por defecto en lugar de montar el socket directamente. Tugtainer no puede actualizarse a sí mismo, ni al agente, ni al socket-proxy desde dentro.
Mi recomendación: elige Tugtainer si quieres una interfaz web en lugar de configurar variables de entorno, si gestionas contenedores repartidos en varios servidores, o si necesitas gestión de dependencias, retrasos de actualización y rollback. Watchtower sigue teniendo sentido para un montaje simple de un solo host donde quieres lo mínimo imprescindible. Ouroboros encaja si prefieres una configuración mínima mediante variables de entorno.
Si tu problema real es una gestión de contenedores más amplia (desplegar stacks, no solo actualizarlos), echa un vistazo a Arcane, un gestor de contenedores Docker autoalojado. Tugtainer es más estrecho a propósito: hace bien las actualizaciones y no estorba.
Características principales
Todo actualizado a v1.41.0:
- Interfaz web con autenticación: gestiona cada contenedor desde un solo panel
- Soporte multi-host: el Agente de Tugtainer conecta servidores remotos a una instancia principal
- Socket-proxy por defecto: acceso de mínimos privilegios a la API de Docker en lugar de montar el socket directamente
- Control granular: configura cada contenedor en modo “check only” (solo comprobar) o “auto-update” (autoactualizar)
- Actualizaciones según dependencias: construye un grafo a partir de archivos Compose y etiquetas, y actualiza en el orden correcto
- Rollback automático: los healthchecks fallidos tras una actualización provocan la vuelta a la imagen anterior
- Margen de retraso de actualización: espera N segundos tras la aparición de un nuevo digest antes de aplicar las actualizaciones programadas
- Monitorización de healthchecks con reinicio automático: detecta contenedores unhealthy, los reinicia con backoff y guarda el historial (nuevo en v1.41.0)
- Progreso de trabajos en tiempo real: observa las comprobaciones y actualizaciones en directo por WebSockets (v1.39.0)
- Notificaciones: Discord, Telegram, Slack, correo electrónico y más vía Apprise, con plantillas Jinja2
- Hooks de ciclo de vida: comandos opcionales antes/después de la actualización dentro de los contenedores (opt-in)
- Registros privados, programación por crontab y limpieza de imágenes lo completan
Cómo desplegar Tugtainer
Dos caminos: Dokploy si ya lo usas, Docker Compose plano si no. En ambos casos obtienes los mismos contenedores.
Opción 1: Despliegue con Dokploy
Dokploy gestiona el certificado SSL y el reverse proxy por ti, que es lo que recomiendo para la interfaz web. Si aún no tienes Dokploy, sigue nuestra guía de instalación de Dokploy y lee cómo desplegar una app de Docker Compose en Dokploy para los detalles específicos de compose.
- Crea un servicio: en tu proyecto de Dokploy, haz clic en “Add Service” y selecciona “Compose”
- Dale un nombre: ponle un nombre como
tugtainer - Añade la configuración: pega esto en el editor de Compose (adaptado del archivo compose oficial, con el mapeo de puertos eliminado ya que Dokploy enruta el dominio):
networks:
  tugtainer:
    driver: bridge
volumes:
  tugtainer_data:
services:
  socket-proxy:
    image: lscr.io/linuxserver/socket-proxy:latest
    container_name: socket-proxy
    environment:
      CONTAINERS: 1
      EVENTS: 1
      IMAGES: 1
      INFO: 1
      LOG_LEVEL: warning
      PING: 1
      NETWORKS: 1
      POST: 1
      VERSION: 1
      ALLOW_LOGS: 1
      ALLOW_START: 1
      ALLOW_STOP: 1
      ALLOW_RESTARTS: 1
      ALLOW_PAUSE: 1
      ALLOW_UNPAUSE: 1
    volumes:
      - /var/run/docker.sock:/var/run/docker.sock:ro
    restart: unless-stopped
    read_only: true
    tmpfs:
      - /run
    networks:
      - tugtainer
    labels:
      dev.quenary.tugtainer.protected: True
  tugtainer:
    depends_on:
      - socket-proxy
    container_name: tugtainer
    image: ghcr.io/quenary/tugtainer:1
    volumes:
      - tugtainer_data:/tugtainer
    restart: unless-stopped
    environment:
      DOCKER_HOST: tcp://socket-proxy:2375
      # Required once you add remote agents:
      # AGENT_SECRET: set-a-long-random-string
    networks:
      - tugtainer
    labels:
dev.quenary.tugtainer.protected: True- Configura el dominio: en la pestaña “Domains”, añade tu dominio (como
updates.yourdomain.com) y mapea el puerto 80 - Despliega: haz clic en “Deploy”. Dokploy inicia ambos contenedores y emite el certificado
Verifica que funcionó:
docker psen el servidor muestratugtainerysocket-proxyen ejecución- Abre
https://updates.yourdomain.com/api/public/healthy espera una respuesta ok (HTTP 200) https://updates.yourdomain.com/api/public/versionmuestra la versión en ejecución- La primera visita a la interfaz muestra el asistente de configuración de la contraseña de administrador
Si el endpoint de salud nunca responde, revisa los logs de despliegue de Dokploy. Las causas habituales son que la pestaña de dominio apunte al puerto equivocado del contenedor (debería ser el 80), o que el contenedor socket-proxy esté reiniciándose en bucle porque la ruta del socket de Docker es incorrecta.
Opción 2: Despliegue con Docker Compose
El archivo compose oficial incluye dos servicios: el socket-proxy y la app. Elige la variante que se ajuste a tu tolerancia al riesgo:
Socket proxy (recomendado)
networks:
  tugtainer:
    driver: bridge
volumes:
  tugtainer_data:
services:
  socket-proxy:
    image: lscr.io/linuxserver/socket-proxy:latest
    container_name: socket-proxy
    environment:
      CONTAINERS: 1
      EVENTS: 1
      IMAGES: 1
      INFO: 1
      LOG_LEVEL: warning
      PING: 1
      NETWORKS: 1
      POST: 1
      VERSION: 1
      ALLOW_LOGS: 1
      ALLOW_START: 1
      ALLOW_STOP: 1
      ALLOW_RESTARTS: 1
      ALLOW_PAUSE: 1
      ALLOW_UNPAUSE: 1
    volumes:
      - /var/run/docker.sock:/var/run/docker.sock:ro
    restart: unless-stopped
    read_only: true
    tmpfs:
      - /run
    networks:
      - tugtainer
    labels:
      dev.quenary.tugtainer.protected: True
  tugtainer:
    depends_on:
      - socket-proxy
    container_name: tugtainer
    image: ghcr.io/quenary/tugtainer:1
    volumes:
      - tugtainer_data:/tugtainer
    restart: unless-stopped
    environment:
      DOCKER_HOST: tcp://socket-proxy:2375
      # Required once you add remote agents:
      # AGENT_SECRET: set-a-long-random-string
      # Allow LAN/Docker-network agents (default only allows 127.0.0.1:8001):
      # AGENT_ALLOW_NETWORKS: 192.168.0.0/24
      # AGENT_ALLOW_ENDPOINTS: 10.0.0.5:9413
    networks:
      - tugtainer
    ports:
      - '9412:80'
    labels:
      dev.quenary.tugtainer.protected: True
La lista ALLOW_* es el conjunto de mínimos privilegios que Tugtainer necesita. Los permisos start/stop/restarts/pause/unpause pasaron a ser obligatorios para los controles de contenedores, y NETWORKS para las actualizaciones en v1.37.0. Si usas una configuración de socket-proxy copiada de una guía antigua, las actualizaciones fallarán con errores de permisos crípticos hasta que los añadas.
Montaje directo del socket (más simple, menos seguro)
services:
  tugtainer:
    image: ghcr.io/quenary/tugtainer:1
    container_name: tugtainer
    restart: unless-stopped
    ports:
      - '9412:80'
    volumes:
      - tugtainer_data:/tugtainer
      - /var/run/docker.sock:/var/run/docker.sock:ro

volumes:
  tugtainer_data:
Un contenedor, un volumen, un montaje. Funciona, pero cualquier cosa que comprometa el proceso de Tugtainer obtiene la API completa de Docker. Yo solo lo usaría en una máquina de homelab de propósito único.
Levanta el stack y verifica:
docker compose up -d
curl http://localhost:9412/api/public/health
Espera un 200 del endpoint de salud, luego inicia sesión en http://ip-del-servidor:9412 y establece la contraseña de administrador. Síntomas cuando algo va mal:
- Puerto 9412 ya en uso: cambia el lado del host del mapeo, p. ej.
'8412:80', o libera el puerto conss -tlnp | grep 9412 - Permission denied en docker.sock (variante de montaje directo): tu usuario no está en el grupo docker o la ruta del socket difiere.
ls -l /var/run/docker.sockpara comprobarlo - Los trabajos de actualización fallan con errores de permisos: a tu socket-proxy le faltan las variables
ALLOW_*más recientes
Limitación de autoactualización
Tugtainer no puede actualizarse a sí mismo, ni al agente, ni al socket-proxy desde dentro de la app. Los tres llevan la etiqueta dev.quenary.tugtainer.protected exactamente por esta razón. Actualízalos manualmente con docker compose pull && docker compose up -d, mediante el redeploy de Dokploy (mira cómo actualizar stacks de Docker Compose en Dokploy), o con otra herramienta como Portainer.
Gestiona hosts remotos con el Agente de Tugtainer
No necesitas una instancia completa de Tugtainer en cada servidor. Despliega el agente, que ejecuta el mismo patrón de socket-proxy localmente y expone una API para la instancia principal:
networks:
  tugtainer_agent:
    driver: bridge
services:
  socket-proxy:
    image: lscr.io/linuxserver/socket-proxy:latest
    container_name: socket-proxy
    environment:
      CONTAINERS: 1
      EVENTS: 1
      IMAGES: 1
      INFO: 1
      LOG_LEVEL: warning
      PING: 1
      NETWORKS: 1
      POST: 1
      VERSION: 1
      ALLOW_LOGS: 1
      ALLOW_START: 1
      ALLOW_STOP: 1
      ALLOW_RESTARTS: 1
      ALLOW_PAUSE: 1
      ALLOW_UNPAUSE: 1
    volumes:
      - /var/run/docker.sock:/var/run/docker.sock:ro
    restart: unless-stopped
    read_only: true
    tmpfs:
      - /run
    networks:
      - tugtainer_agent
    labels:
      dev.quenary.tugtainer.protected: True
  agent:
    depends_on:
      - socket-proxy
    container_name: tugtainer-agent
    image: ghcr.io/quenary/tugtainer-agent:1
    restart: unless-stopped
    read_only: true
    tmpfs:
      - /run
    environment:
      AGENT_SECRET: set-a-long-random-string
      DOCKER_HOST: tcp://socket-proxy:2375
    networks:
      - tugtainer_agent
    ports:
      - '9413:8001'
    labels:
      dev.quenary.tugtainer.protected: True
Establece el mismo valor de AGENT_SECRET en la instancia principal y en el agente. Genera uno con openssl rand -hex 32 y trátalo como cualquier otra credencial. Compose también admite secrets de verdad; consulta Docker Compose secrets y alternativas seguras para ver las opciones.
Secretos de agente y redes privadas
Usa un AGENT_SECRET largo y único por flota, no el valor de ejemplo. Ten en cuenta además que la instancia principal bloquea por defecto las URLs de agentes que resuelven a redes privadas o reservadas. Solo el endpoint integrado 127.0.0.1:8001 está permitido de fábrica, así que un agente en la LAN no conectará hasta que lo incluyas en la lista blanca.
La lista blanca se configura en la instancia principal, no en el agente. Añade una o ambas al entorno del contenedor de Tugtainer:
environment:
  # Allow a whole subnet (LAN or Docker network)
  - AGENT_ALLOW_NETWORKS=192.168.0.0/24
  # Or pin exact agent endpoints (IP:port)
  - AGENT_ALLOW_ENDPOINTS=10.0.0.5:9413
Opciones TLS para la conexión del agente
El backend y el agente hablan HTTP plano por defecto:
- CA pública (Let’s Encrypt, etc.): pon un reverse proxy delante del agente y configura la URL del host como
https://...en la interfaz. Traefik funciona bien; mira nuestra configuración de reverse proxy Traefik para Docker - CA privada o autofirmada: pega el PEM de la CA en el campo “Custom CA” de la configuración del host (soportado desde v1.36.0). El nombre de host del certificado debe coincidir con la URL
- TLS nativo sin proxy: monta el cert y la clave en el agente y extiende el comando con
--ssl-certfile/--ssl-keyfile. Advertencia: el healthcheck propio del agente llama ahttp://localhost:8001y puede marcar unhealthy cuando uvicorn sirve solo HTTPS
Tras desplegar el agente, ve a Menu → Hosts en la interfaz web, añade el host con su IP (o dominio) y el AGENT_SECRET. Verifica: el host aparece como online en la lista de hosts; luego ejecuta un “Check all” manual contra él y observa el journal del trabajo en directo transmitir los resultados.
Interfaz web de Tugtainer
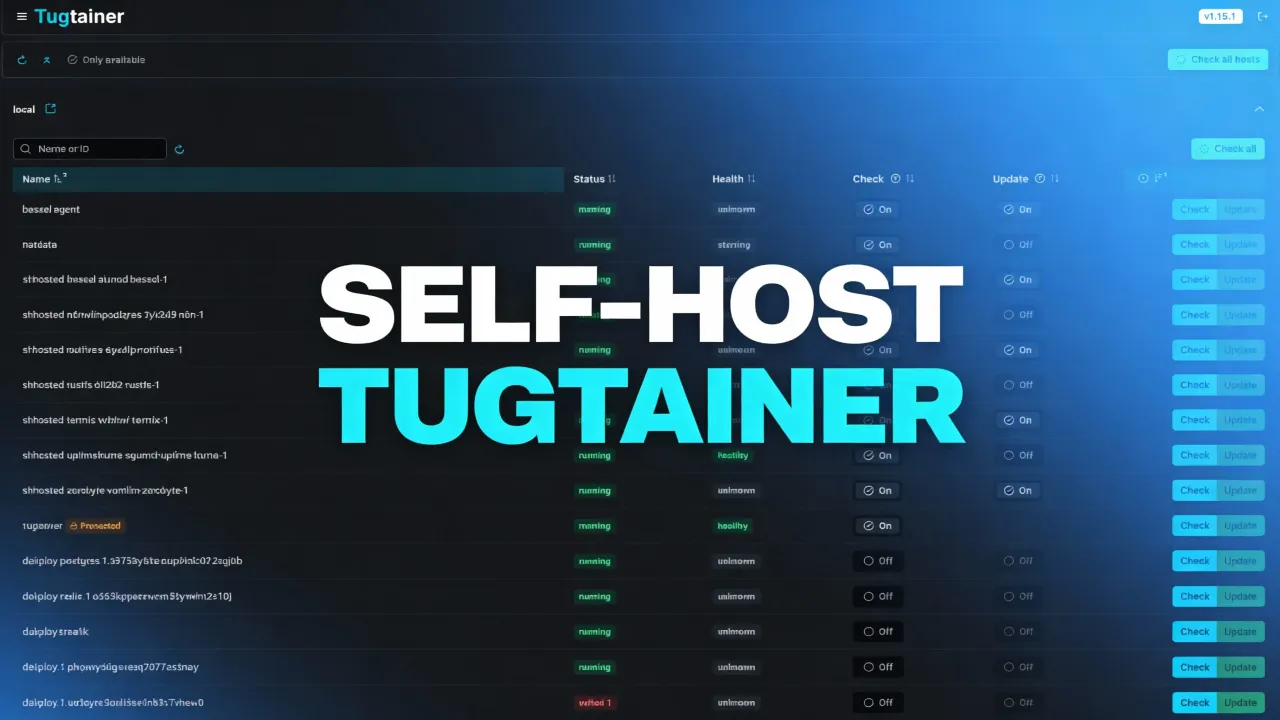
Una vez desplegado, el panel muestra todos los contenedores y su estado de actualización.
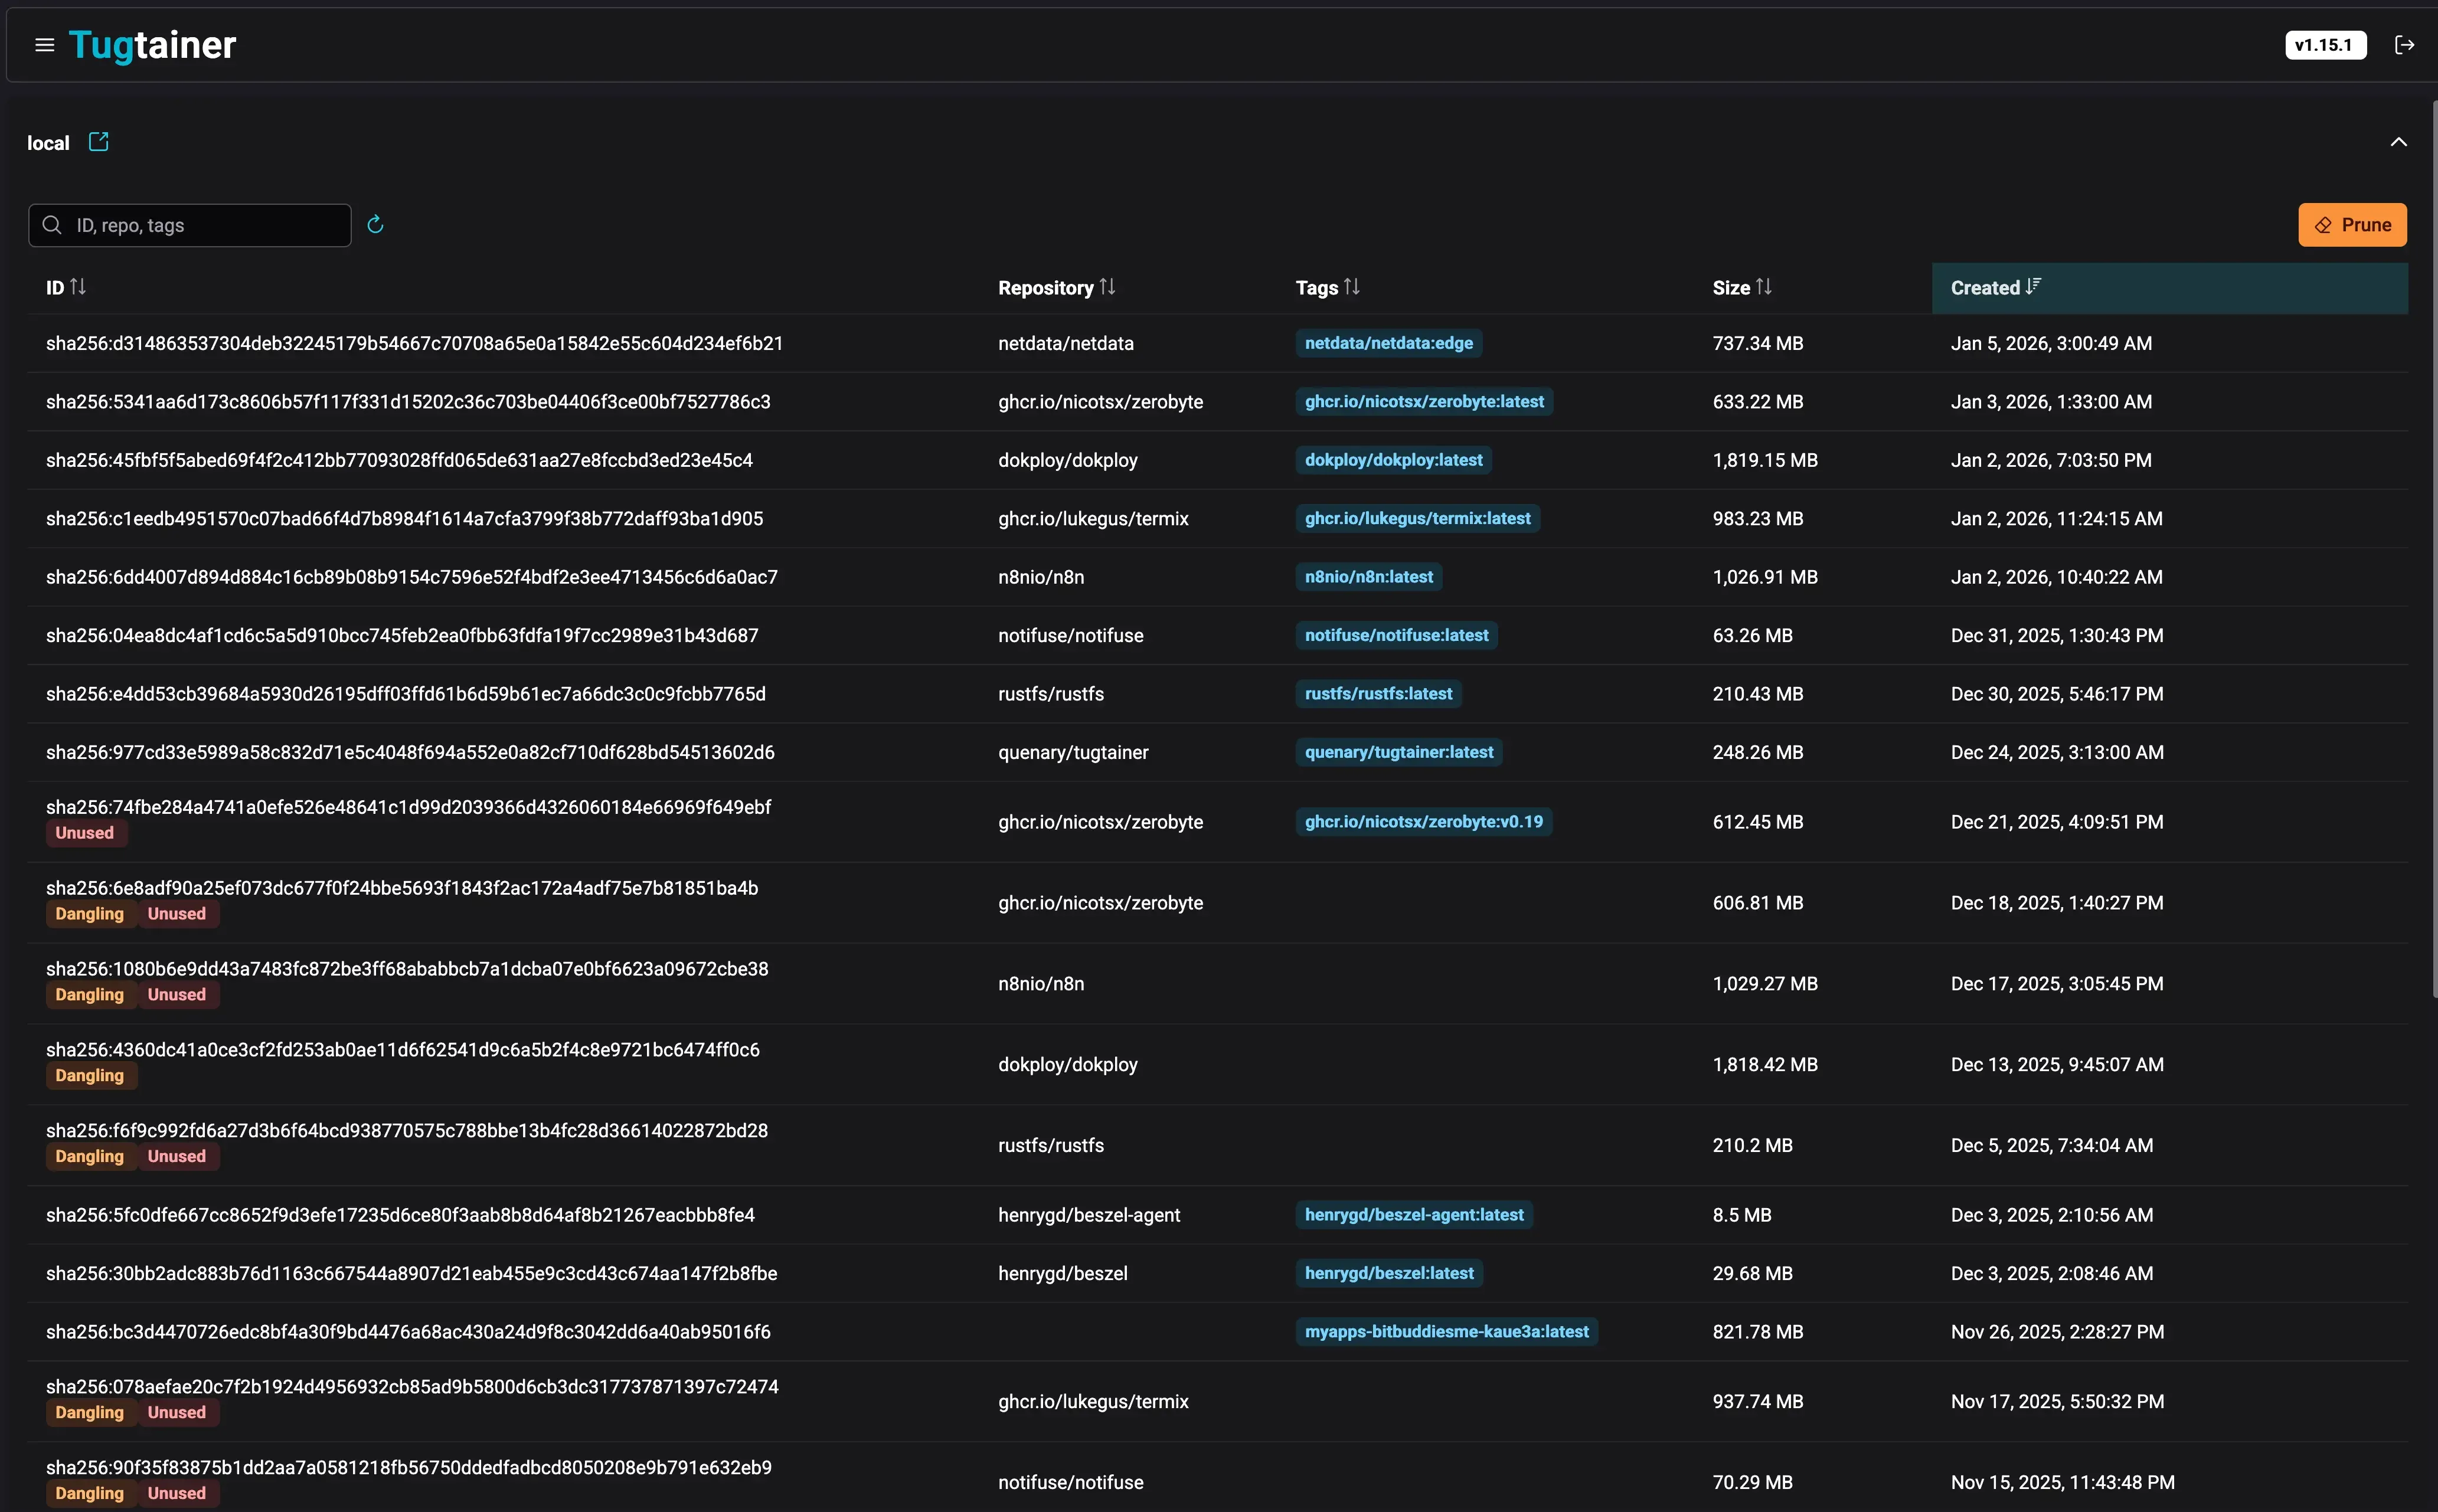
El panel muestra todos tus contenedores, sus versiones actuales y si hay actualizaciones disponibles. Puedes ver rápidamente qué contenedores están configurados para autoactualizarse y cuáles están protegidos. (Las capturas son de principios de 2026; las versiones posteriores se ven ligeramente distintas.)
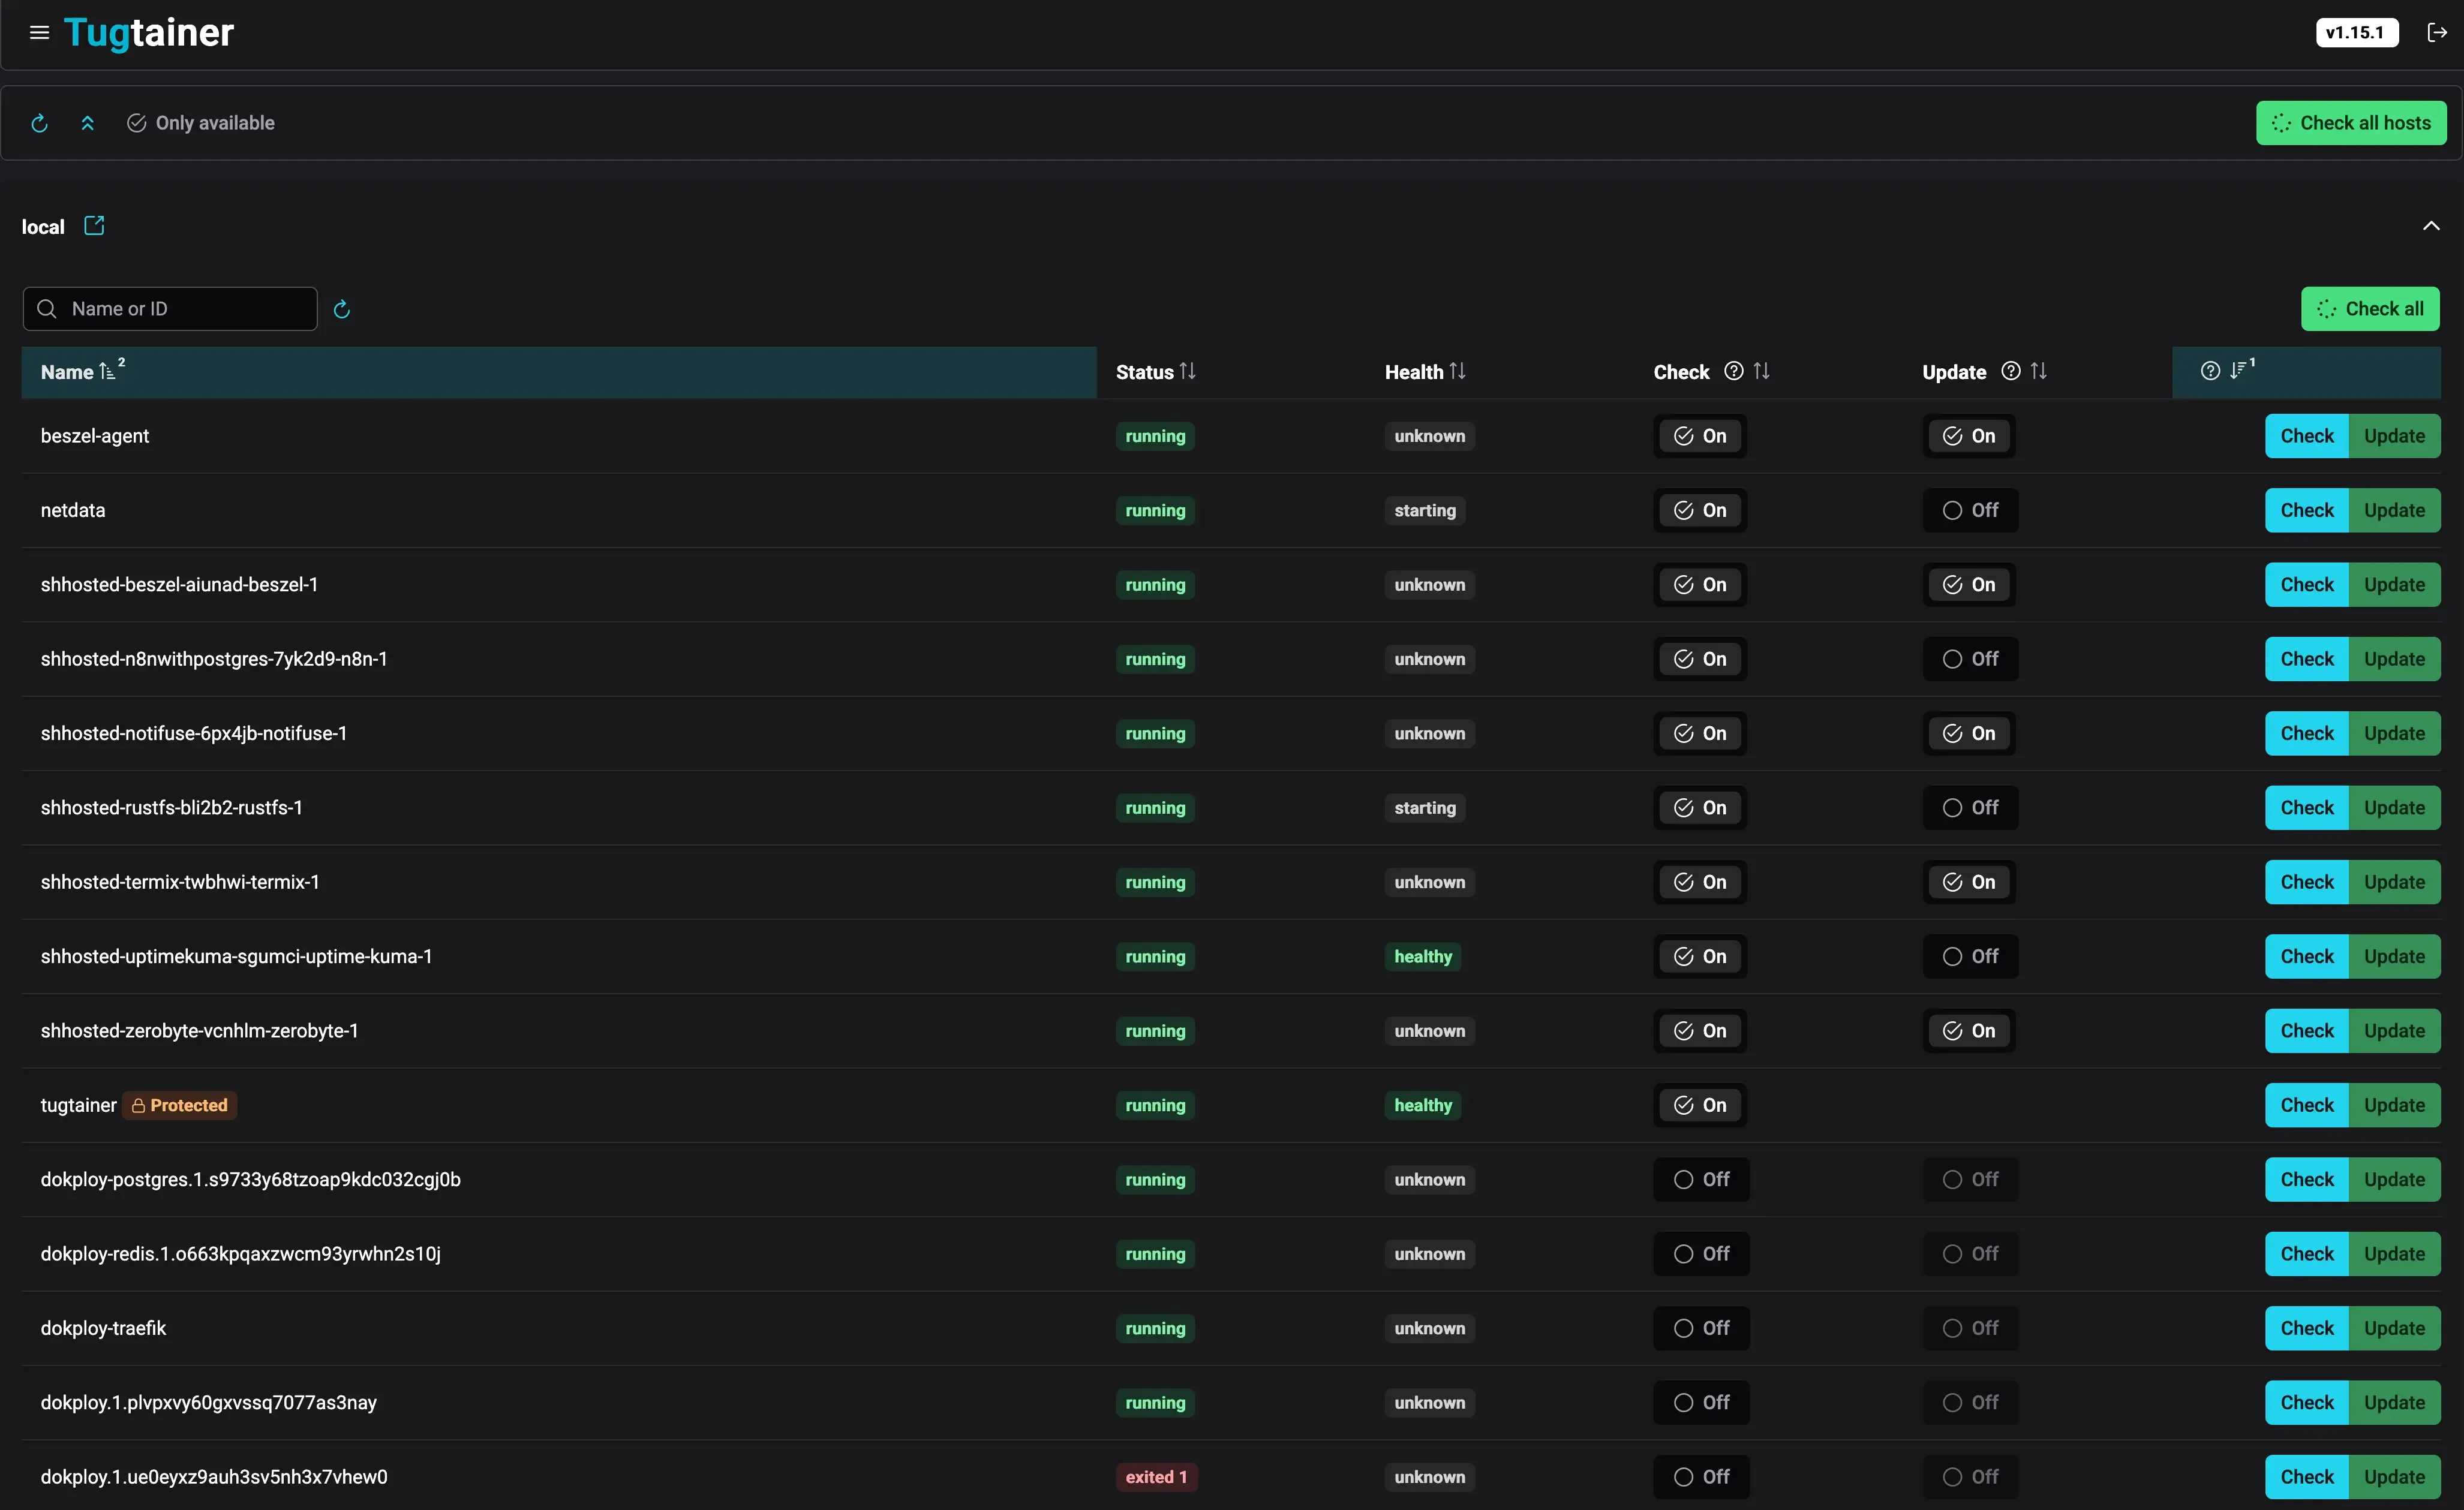
Desde esta vista puedes:
- Ver información detallada de cada contenedor
- Alternar entre los modos “check only” y “auto-update”
- Filtrar la tabla por estado (añadido en v1.33.0)
- Seleccionar varios contenedores y comprobarlos o actualizarlos en lote
- Ver la versión en ejecución extraída de las etiquetas de imagen (v1.38.0) y un enlace al código fuente en la tarjeta (v1.36.0)
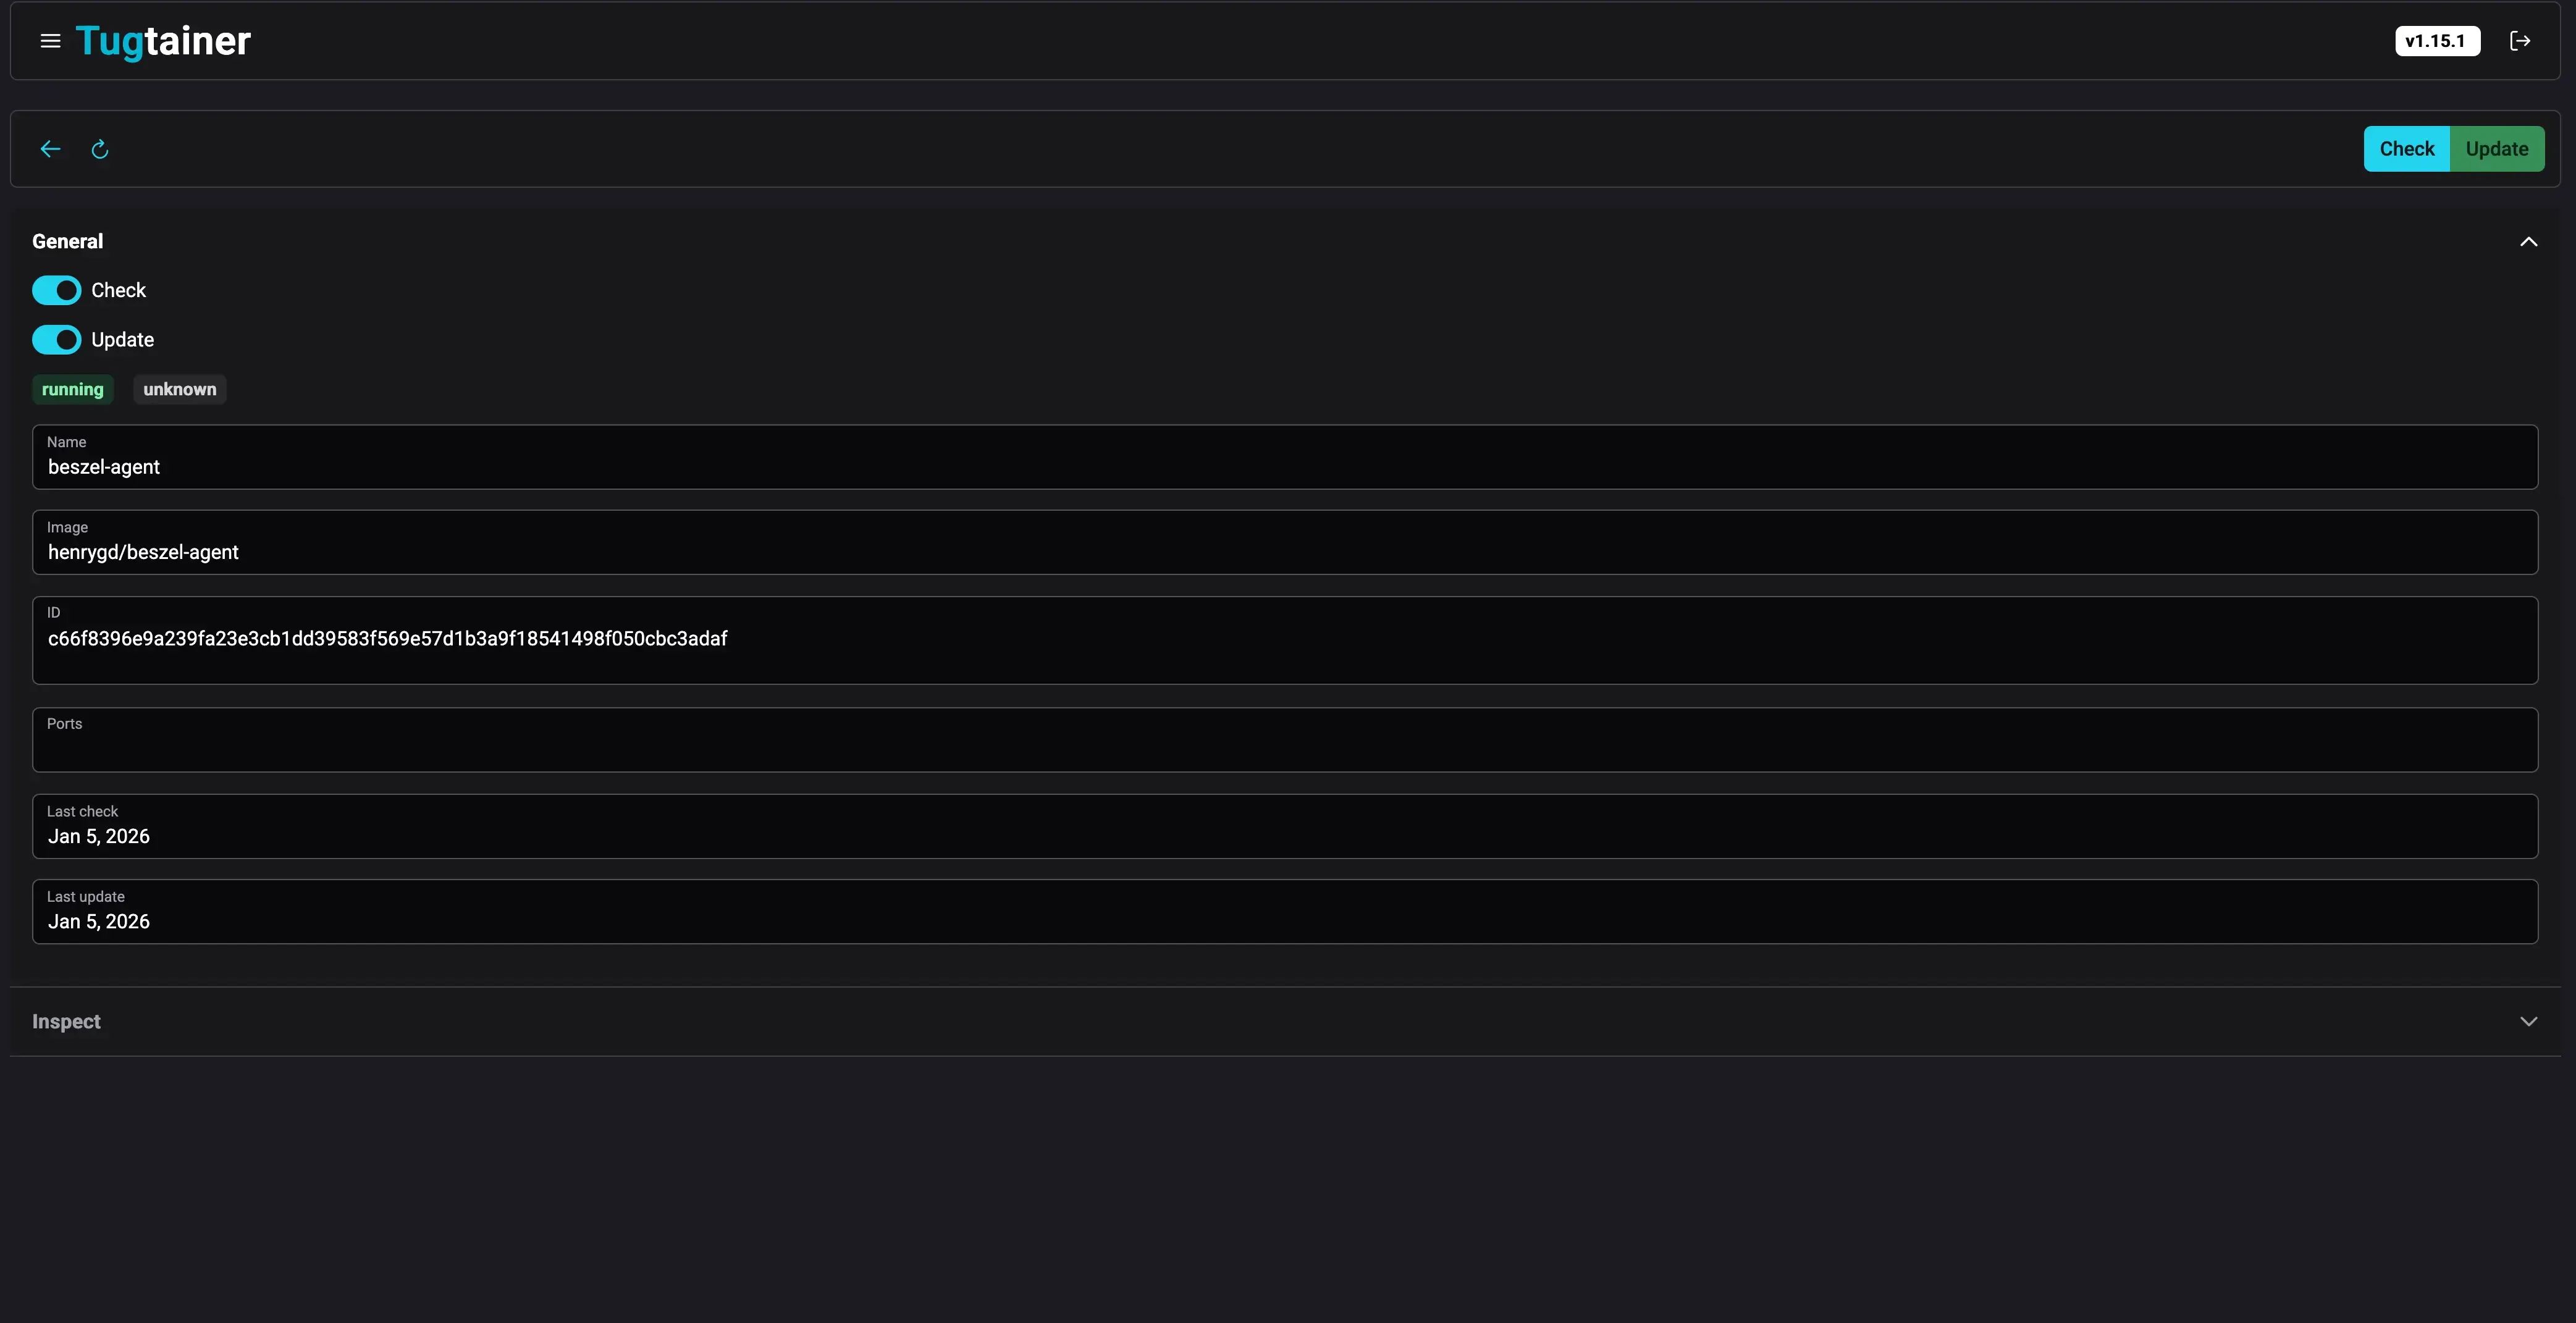
La vista de contenedor individual te permite configurar:
- Calendario de actualización y retraso de actualización por contenedor
- Preferencias de notificación
- Gestión de dependencias
- Etiquetas personalizadas y un override del timeout del healthcheck (v1.40.0)
Desde v1.39.0 también hay un diálogo de progreso de trabajos: cuando ejecutas una comprobación o actualización, transmite un journal en directo por WebSockets, así que puedes ver los pasos de pull, stop, recreación y arranque de cada contenedor a medida que ocurren en lugar de mirar un spinner.
Primer inicio de sesión
Cuando visites por primera vez la interfaz web de Tugtainer, configurarás una cuenta de administrador.
- Crea la contraseña: establece una contraseña segura durante la configuración inicial
- Inicia sesión: usa la contraseña que creaste para acceder al panel
- Cambia la contraseña: puedes cambiarla más tarde en los ajustes
Tugtainer no genera una contraseña aleatoria como algunas herramientas Docker. La estableces tú durante el asistente de configuración, así que elige algo largo.
Proceso de comprobación y actualización
Tugtainer procesa cada host como un solo conjunto. Construye un grafo de dependencias a partir de los metadatos de Compose (depends_on entre contenedores del mismo proyecto compose) y de la etiqueta personalizada depends_on para enlaces entre proyectos. Los contenedores protegidos y los detenidos se omiten.
Cuando se ejecuta una actualización (por calendario o manualmente):
- Comprobación de digest: Tugtainer compara el digest de imagen de cada contenedor con el del registro y marca los contenedores con una imagen más reciente como “available”
- Pull: se descargan las imágenes nuevas para el conjunto actualizable
- Orden de parada: todos los contenedores implicados se detienen una vez, empezando por los más dependientes
- Recreación y arranque: los contenedores actualizables se recrean con la nueva imagen, y todo arranca en orden inverso, las dependencias primero
- Espera de healthcheck: tras el arranque, Tugtainer espera a los healthchecks. Si un contenedor actualizado pasa a unhealthy, se revierte a la imagen anterior
Los trabajos en el mismo host se serializan (una comprobación de A y B no puede solaparse con una actualización de C y D), mientras que hosts diferentes se ejecutan en paralelo. Cada host guarda un historial de trabajos que puedes inspeccionar desde la interfaz.
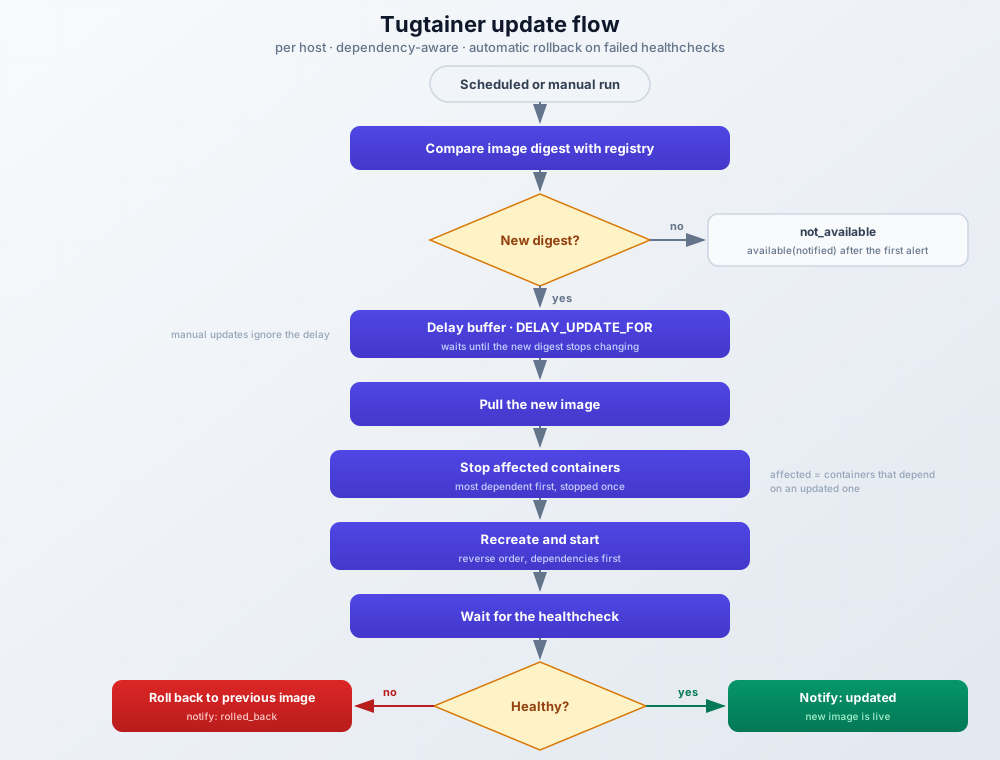
Retraso de actualización (un margen de seguridad)
Las versiones nuevas a veces se retiran a las pocas horas de publicarse. La función de retraso hace que las actualizaciones programadas esperen hasta que un nuevo digest lleva estable un tiempo:
DELAY_UPDATE_FORes el ajuste global en segundos, por defecto0(sin retraso)- Un override por contenedor
delay_update_forprevalece cuando está definido - La comprobación sigue ejecutándose y aún te notifica inmediatamente; solo la actualización programada espera
- Las actualizaciones manuales ignoran el retraso por completo
Para servicios que importan pero no son críticos de seguridad, yo pondría 24-48 horas. Para tu reverse proxy o VPN, mejor actualiza rápido. Una trampa: el botón manual “Update all” salta el retraso, así que no lo uses como vía de hotfix para contenedores retrasados a menos que hayas leído el changelog.
Volver a la imagen anterior
Desde v1.34.0, cada actualización exitosa registra lo que el contenedor ejecutaba antes:
previous_image_digests: los digests del repo, comonginx@sha256:.... Este es el único valor que fija de nuevo la imagen exactaprevious_image_tags: las etiquetas locales que tenía la imagen antigua (menos útil cuando sigueslatest)previous_image_version: una pista de las etiquetas de la imagen, no una etiqueta garantizada
Los tres aparecen en la tarjeta del contenedor. La vía automática: si un contenedor recreado falla su healthcheck tras una actualización, Tugtainer lo revierte a la imagen anterior por su cuenta y marca el resultado como rolled_back. La vía manual: copia el digest de la tarjeta a tu archivo compose y recrea:
services:
  nginx:
    image: nginx@sha256:abc123...  # paste previous_image_digests here
Fija el digest, no la etiqueta de versión. Los valores solo se registran tras actualizaciones exitosas, ya que tras un rollback la imagen anterior es la actual.
Hooks de ciclo de vida (opcionales)
Los hooks te permiten ejecutar comandos de shell dentro de un contenedor en puntos del ciclo de vida de la actualización: pre_update, post_update, pre_stop, pre_rollback y post_rollback. Cada uno se ejecuta como sh -c "<command>" dentro del contenedor objetivo.
Así es como haces un snapshot de una base de datos antes de las actualizaciones, p. ej. un hook pre_update que ejecuta pg_dump. Tugtainer no incluye lógica de backup integrada; tú escribes el comando y gestionas a dónde va la salida.
La semántica de fallos es sensata:
- Un hook
pre_updateopre_stopque falla aborta la actualización de ese contenedor, dejándolo en ejecución tal cual - Los fallos de
post_update,pre_rollbackypost_rollbackse registran y nunca bloquean nada
Los hooks ejecutan comandos arbitrarios
Los hooks son ejecución remota de código por diseño. Requieren dos interruptores a la vez: ALLOW_HOOKS=true en el backend de Tugtainer y ALLOW_EXEC=true en el agente del host concreto. Deja ambos desactivados a menos que tengas una razón específica, y nunca actives ALLOW_EXEC en hosts que ejecuten cargas de trabajo no confiables.
Monitoriza tus contenedores
Los sistemas de autoactualización fallan en silencio cuando una imagen nueva se cae al arrancar. La función de monitorización de healthchecks (nueva en v1.41.0) aborda eso: Tugtainer inspecciona periódicamente los healthchecks de Docker en todos los hosts habilitados y registra las transiciones de estado a lo largo del tiempo.
Cómo funciona:
- Detección: se ejecuta en un calendario crontab (
HEALTH_MONITOR_CRON_EXPR, por defecto cada 3 minutos). Los contenedores sin healthcheck de Docker se omiten, así que esto solo cubre contenedores que definen uno - Seguimiento de fallos: se cuentan las comprobaciones unhealthy consecutivas por contenedor
- Reinicios automáticos con backoff: cuando los fallos alcanzan
(restart_attempts + 1) * HEALTH_MONITOR_N_TO_RESTART, el contenedor se reinicia. Los reinicios se limitan aHEALTH_MONITOR_RESTART_ATTEMPTS. Desactivado por defecto; ponHEALTH_MONITOR_N_TO_RESTARTen un número positivo (p. ej.3) para habilitarlo - Notificaciones: se envían tras
HEALTH_MONITOR_N_TO_NTFYfallos consecutivos (por defecto 3), con un aviso de recuperación cuando el contenedor vuelve a healthy - Historial: cada evento de estado va a una tabla de historial, que se limpia tras
HEALTH_MONITOR_HISTORY_DAYS(por defecto 7)
Todos los ajustes viven en Menu → Settings:
| Ajuste | Por defecto | Qué hace |
|---|---|---|
HEALTH_MONITOR_CRON_EXPR |
*/3 * * * * |
Cada cuánto se ejecuta el trabajo de salud |
HEALTH_MONITOR_N_TO_RESTART |
-1 (desactivado) |
Fallos consecutivos antes de un reinicio |
HEALTH_MONITOR_N_TO_NTFY |
3 |
Fallos consecutivos antes de una notificación |
HEALTH_MONITOR_RESTART_ATTEMPTS |
3 |
Máximo de intentos de reinicio por contenedor |
HEALTH_MONITOR_HISTORY_DAYS |
7 |
Días de historial a conservar (menos de 0 conserva para siempre) |
HEALTH_MONITOR_NTFY_BODY_TMPL |
integrada | Plantilla Jinja2 para el cuerpo de la notificación |
Al esperar a que un contenedor pase a healthy tras un reinicio, el timeout proviene, en orden: del override por contenedor (tarjeta del contenedor, desde v1.40.0), del ajuste CONTAINER_HC_TIMEOUT del host, y luego de un fallback de 60 segundos.
Verifica que funciona: abre el mosaico Healthcheck Monitoring en el panel, que lleva a /hosts/:id/health y a la tabla de historial. Para generar eventos a propósito, ejecuta un contenedor de prueba con un healthcheck que falla:
docker run -d --name hc-test --health-cmd "false" busybox sleep 300En unos pocos ciclos el contenedor aparece como unhealthy en el historial. Limpia con docker rm -f hc-test.
Esto complementa la monitorización de fuera hacia dentro en lugar de sustituirla. Tugtainer reinicia contenedores unhealthy desde dentro; herramientas como Beszel y Uptime Kuma monitorizando en Dokploy te informan de los recursos del host y el uptime del servicio desde la perspectiva del usuario. Yo uso ambas. Para tendencias de CPU, memoria y disco a nivel de host, consulta nuestra guía de paneles de monitorización de servidores, y para alertas sobre endpoints concretamente, la herramienta de monitorización autoalojada Uptime Kuma es la opción fiable y aburrida.
Notificaciones
Tugtainer usa Apprise para la entrega y Jinja2 para el contenido de los mensajes, así que obtienes Discord, Telegram, Slack, correo electrónico y unos 80 servicios más desde una sola configuración.
Cada contenedor en un trabajo de comprobación o actualización obtiene uno de estos resultados:
not_available: no hay imagen nuevaavailable: se encontró imagen nuevaavailable(notified): imagen nueva, pero ya te avisaron de ella. Tugtainer recuerda los digests sobre los que ha notificado, así que las comprobaciones repetidas no te envían spamupdated: recreado con la nueva imagen con éxitorolled_back: la recreación falló, imagen anterior restauradafailed: la recreación falló, sin rollback
Un detalle: solo se envía una notificación cuando el cuerpo renderizado no está vacío. Si cada contenedor devuelve available(notified), la plantilla por defecto no produce nada y no sale ningún mensaje. Eso es la deduplicación funcionando como debe, no un webhook roto.
El monitor de salud tiene su propia plantilla y contexto (HEALTH_MONITOR_NTFY_BODY_TMPL), así que las alertas de unhealthy/recuperación se renderizan aparte de los resultados de actualización. También hay un filtro Jinja2 any_worthy si personalizas plantillas: es true cuando al menos un contenedor está available, updated, rolled_back o failed.
Una trampa para quienes autoalojan: las URLs de notificación que resuelven a redes privadas o reservadas están bloqueadas por una comprobación SSRF de mejor esfuerzo. Si ejecutas ntfy u otro receptor de webhooks en la misma red privada, puede quedar bloqueado. La opción más estricta es NOTIFICATION_ALLOW_SCHEMES (p. ej. tgram,discord,ntfy), que limita la entrega a los esquemas que usas.
Verifica: configura tu webhook de Discord en los ajustes de notificación, pulsa “Check all” manualmente y confirma que el mensaje llega al canal.
Autenticación y seguridad
Por defecto, Tugtainer usa autenticación por contraseña almacenada en un archivo cifrado. A partir de v1.6.0, puedes configurar un proveedor OpenID Connect (OIDC) para gestionar el inicio de sesión con tu sistema de identidad existente.
Configurar la autenticación OIDC
Para habilitar la autenticación OIDC necesitas:
-
Proveedor OIDC: configura tu proveedor (Auth0, Keycloak, Authentik, Azure AD, Google, etc.) con:
- Client ID
- Client Secret
- Issuer URL
- Redirect URL (tu dominio de Tugtainer +
/auth/callback)
-
Variables de entorno: añade estas a tu contenedor de Tugtainer:
environment:
  - OIDC_ENABLED=true
  - OIDC_CLIENT_ID=your_client_id
  - OIDC_CLIENT_SECRET=your_client_secret
  - OIDC_ISSUER=https://your-provider.com
  - OIDC_REDIRECT_URI=https://tugtainer.yourdomain.com/auth/callback
  - OIDC_SCOPES=openid email profile
  # Optional allowlists:
  # - [email protected]
# - OIDC_ALLOWED_SUBJECTS=auth0|12345- Reinicia el contenedor: aplica los cambios recreando el contenedor
Cosas que se endurecieron en versiones de 2026 que conviene conocer antes de depurar un login que “antes funcionaba”: desde v1.31.3, los ID tokens se verifican en el servidor, lo que significa que tu proveedor debe firmar con una clave asimétrica (RS*/ES*, no HS256), el claim iss debe coincidir exactamente con el issuer del documento de discovery, y openid debe estar en los scopes para que vuelva un id_token. El soporte de refresh tokens llegó en v1.30.3. Las listas opcionales OIDC_ALLOWED_EMAILS / OIDC_ALLOWED_SUBJECTS restringen qué identidades pueden iniciar sesión.
Proteger el socket de Docker y los agentes
El socket-proxy es el patrón por defecto por una razón: expone solo las llamadas a la API que Tugtainer necesita, con un montaje del socket de solo lectura dentro del contenedor proxy. Mantén la lista ALLOW_* mínima; cada permiso que añades amplía el radio de impacto si Tugtainer es comprometido alguna vez.
El endurecimiento del lado del agente también mejoró durante 2026: AGENT_ALLOW_NETWORKS / AGENT_ALLOW_ENDPOINTS te dan una postura de denegación por defecto para los endpoints de agentes, y v1.34.2 añadió protecciones contra DNS-rebinding para que las IPs de agentes validadas queden fijadas durante la conexión.
Postura de denegación por defecto
De fábrica, los endpoints de agentes en redes privadas están bloqueados hasta que los incluyas en la lista blanca, y las URLs de notificación que apuntan a redes privadas también están bloqueadas. Ambas se abren solo cuando las configuras explícitamente, que es el valor por defecto correcto para una máquina expuesta a internet.
Pero sé honesto con el modelo de amenazas. Es una herramienta de un solo operador con un nivel de privilegio: un administrador autenticado ya puede hacerlo todo en Docker a través de la interfaz. Está construida para una red confiable que tú controlas, no para exposición multi-inquilino. Mantenla fuera de la internet pública, o detrás de SSO y autenticación de reverse proxy como mínimo. Antes de exponer cualquier servicio relacionado con Docker, vale la pena seguir nuestra guía para proteger tu servidor Docker basada en el informe de hardening del BSI.
Mi checklist corto de hardening para una máquina con Tugtainer:
- HTTPS vía Dokploy o Traefik; nunca expongas el 9412 en crudo a internet
AGENT_SECRETfuerte y único, guardado con tus otros secretos- Socket-proxy en lugar de montajes directos del socket, en todas partes
- OIDC o una contraseña de administrador larga y aleatoria, no
password123 - Hooks desactivados a menos que una carga de trabajo los necesite de verdad
NOTIFICATION_ALLOW_SCHEMESajustado si autoalojas receptores de webhooks- Parchea el propio host; Tugtainer actualiza contenedores, no tu SO
Operar Tugtainer en el día a día
Copias de seguridad
Lo que importa son los datos de tus contenedores, no el estado de Tugtainer. Las autoactualizaciones son exactamente cuando quieres backups frescos: haz snapshots de los volúmenes antes de las ventanas de actualización programadas, y usa hooks pre_update para volcados de base de datos si un contenedor guarda datos que no puedes regenerar. El propio volumen tugtainer_data de Tugtainer guarda la configuración y el historial. Perderlo es molesto, no catastrófico.
Mantener Tugtainer actualizado
No puede actualizarse a sí mismo, ni al agente, ni al socket-proxy. Yo haría una pasada manual mensual:
cd /path/to/tugtainer-stack
docker compose pull && docker compose up -d
Eso cubre todos los contenedores protegidos del stack. Igual en los hosts de agentes.
Limpieza de imágenes (pruning)
Las imágenes viejas se acumulan tras cada ciclo de actualización. Tugtainer puede limpiarlas automáticamente o bajo demanda desde los ajustes. Para limpiezas más profundas, mira cómo limpiar todas las imágenes, contenedores y volúmenes de Docker, y si el uso de disco sigue subiendo, nuestra guía sobre cómo recuperar espacio en disco de /var/lib/docker/overlay2 va a por lo que el pruning no alcanza.
Desactivarlo
Vuelve a poner los contenedores en “check only” si quieres mantener la visibilidad sin la automatización, o elimina los stacks por completo:
docker compose down          # keeps the tugtainer_data volume
docker compose down -v       # also wipes Tugtainer's state
En cualquier caso, tus cargas de trabajo siguen ejecutándose intactas. Eliminar Tugtainer solo elimina la automatización, nunca los contenedores que gestionaba.
Solución de problemas comunes
- El host del agente aparece como unreachable →
AGENT_SECRETno coincide entre la instancia principal y el agente, o la IP privada del agente está bloqueada. ConfiguraAGENT_ALLOW_NETWORKSoAGENT_ALLOW_ENDPOINTSen la instancia principal - Las actualizaciones fallan con errores de permisos del socket-proxy → al proxy le faltan variables
ALLOW_*requeridas, especialmenteALLOW_START/ALLOW_STOP/ALLOW_RESTARTSyNETWORKS(los requisitos cambiaron en v1.37.0) - Errores “Cannot update” en tugtainer, el agente o socket-proxy → llevan la etiqueta
protectedpor diseño. Actualízalos manualmente - Puerto 9412 o 9413 ya en uso → cambia el lado del host del mapeo de puertos en el compose. Ten en cuenta además que el stack del agente espera su propio host; ejecutar el compose completo del agente en la misma máquina que la instancia principal colisiona en el nombre del contenedor
socket-proxy - Contenedor del agente unhealthy tras activar TLS nativo → su healthcheck llama a
http://localhost:8001, que falla cuando uvicorn sirve solo HTTPS. Prefiere TLS por reverse proxy - No llegan notificaciones → o todos los resultados fueron
available(notified)(cuerpo vacío, nada enviado) o tu URL de webhook está bloqueada por la comprobación SSRF de redes privadas - Contenedor atascado en un bucle de rollback tras una mala imagen → fija
previous_image_digestsde la tarjeta del contenedor en tu archivo compose, desactiva la autoactualización para ese contenedor y espera una versión corregida - Errores de redirección en el login OIDC →
OIDC_REDIRECT_URIdebe coincidir con tu dominio más/auth/callbackexactamente, y desde v1.31.3 el proveedor debe devolver un ID token firmado asimétricamente con un issuer coincidente
Preguntas frecuentes
¿Cómo gestiona Tugtainer las dependencias entre contenedores?
Tugtainer construye un grafo de dependencias por host a partir de los metadatos depends_on de Compose (para contenedores del mismo proyecto compose) y de la etiqueta dev.quenary.tugtainer.depends_on para enlaces entre proyectos. Durante las actualizaciones detiene todos los contenedores implicados una vez, empezando por los más dependientes, y luego recrea y arranca todo en orden inverso para que las bases de datos estén arriba antes que los servicios que las necesitan. Los contenedores sin dependencias se tratan como independientes.
¿Puedo excluir contenedores concretos de las autoactualizaciones?
Sí, de varias formas:
- Usa la etiqueta
dev.quenary.tugtainer.protected=truepara evitar que Tugtainer detenga o actualice un contenedor en absoluto - Pon contenedores individuales en modo “check only” en la interfaz web, así recibes notificaciones pero nada se actualiza automáticamente
- Configura un retraso de actualización por contenedor si quieres que se actualice eventualmente, solo que no el primer día
¿Qué pasa si una actualización falla?
Dos capas de protección. Si el contenedor recreado falla su healthcheck tras arrancar, Tugtainer revierte automáticamente a la imagen anterior y marca el resultado rolled_back. Si la recreación en sí falla, el resultado es failed. En cualquier caso recibes una notificación a través de tus servicios Apprise configurados, la imagen antigua sigue disponible localmente, y la tarjeta del contenedor registra previous_image_digests para que puedas fijar manualmente la última versión buena conocida.
¿Es Tugtainer seguro para entornos de producción?
Los desarrolladores no lo recomiendan para entornos de producción críticos sin pruebas. Si lo ejecutas en territorio cercano a producción:
- Prueba las actualizaciones primero en staging
- Mantén copias de seguridad regulares y haz snapshots antes de las ventanas de actualización
- Arranca los servicios críticos en modo “check only” y observa unos cuantos ciclos
- Usa el retraso de actualización para que las malas versiones envejezcan antes de llegar a ti
- Ten la vía de rollback (basada en healthcheck o fijado manual del digest) confirmada antes de activar la autoactualización
¿Cómo gestiono el espacio en disco de Docker con Tugtainer?
Tugtainer incluye limpieza automática o manual de imágenes antiguas, que cubre la mayor parte del crecimiento por actualizaciones frecuentes. Para una limpieza completa, sigue nuestra guía sobre cómo limpiar todas las imágenes, contenedores y volúmenes de Docker. Si el uso de disco sigue subiendo, mira cómo recuperar espacio en disco de /var/lib/docker/overlay2.
¿Puede Tugtainer actualizarse a sí mismo?
No. Tugtainer, el Agente de Tugtainer y el socket-proxy llevan todos la etiqueta dev.quenary.tugtainer.protected=true y no pueden actualizarse desde dentro de la app. Actualízalos manualmente con docker compose pull && docker compose up -d en cada directorio de stack, o mediante el redeploy de Dokploy. La misma limitación aplica a cualquier contenedor que protejas tú mismo.
¿Reinicia Tugtainer los contenedores unhealthy?
Sí, pero es opt-in. La monitorización de healthchecks (v1.41.0) registra las comprobaciones unhealthy consecutivas, y los reinicios se activan cuando pones HEALTH_MONITOR_N_TO_RESTART en un número positivo (por defecto -1, desactivado). Los reinicios usan backoff, se limitan a HEALTH_MONITOR_RESTART_ATTEMPTS (por defecto 3), y cada fallo y recuperación se registra en la tabla de historial de salud. Los contenedores sin healthcheck de Docker nunca se tocan.
¿Puedo retrasar las actualizaciones para que las malas versiones no lleguen a mi servidor?
Sí. Configura DELAY_UPDATE_FOR (segundos) globalmente o por contenedor. Las actualizaciones programadas solo se aplican después de que un nuevo digest de imagen haya estado estable durante el periodo de retraso, así que las versiones que se retiran o reciben hotfix en horas nunca te alcanzan. Las notificaciones de comprobación siguen llegando inmediatamente, y las actualizaciones manuales saltan el retraso.
¿Cómo vuelvo a una imagen de contenedor anterior tras una mala actualización?
Si el contenedor tiene healthcheck, el rollback es automático cuando la nueva versión pasa a unhealthy. Si no, abre la tarjeta del contenedor en la interfaz de Tugtainer y copia previous_image_digests, luego pon ese digest en el campo image: de tu archivo compose y recrea el contenedor. Fija el digest en lugar de la etiqueta de versión; la etiqueta es solo una pista del publicador y no está garantizado que exista como tag en el registro.
¿Cómo se compara Tugtainer con las actualizaciones manuales de Docker Compose?
Siempre puedes actualizar manualmente con docker compose pull y docker compose up -d, como se muestra en nuestra guía de actualización de Docker Compose, y los usuarios de Dokploy tienen su propio flujo para actualizar stacks de Docker Compose en Dokploy. Tugtainer automatiza ese bucle:
- Comprueba actualizaciones en un calendario y te notifica
- Gestiona el orden de dependencias en todo el host
- Añade un margen de retraso y rollback automático ante healthchecks fallidos
- Te da una interfaz única para varios hosts
Artículos relacionados
- Los mejores paneles self-hosted: una comparativa - Compara Tugtainer con otras soluciones de gestión autoalojadas
- Top 60+ comandos de Docker que todo desarrollador DEBE conocer - Comandos esenciales de Docker para la gestión de contenedores
- Instalación de Dokploy - Autoaloja tu SaaS - Guía completa de instalación de Dokploy
- Cómo actualizar contenedores con Docker Compose - Guía de actualización manual de contenedores
- Cómo limpiar todas las cosas de Docker - Guía completa de limpieza de Docker
- Monitorizar recursos del servidor - Monitorización de recursos del servidor y de Docker
- Instalación de Arcane Docker: gestor de contenedores self-hosted - Gestión de contenedores más amplia si las actualizaciones no son tu único problema
- Comparativa Arcane vs Dockhand - Qué gestor de Docker encaja con tu montaje