Cómo usar la API GRATUITA de Groq en tu app de Streamlit
Aprende a integrar la API gratuita de Groq en tu app de Streamlit con Llama 3.1. Código paso a paso, manejo de errores, límites de peticiones y consejos de despliegue. Actualizado para 2026.

Actualizado Publicado 23 min de lectura
El motor de inferencia LPU de Groq ofrece una de las generaciones de texto más rápidas que puedes obtener de una API en la nube, y el nivel gratuito te da acceso real sin tarjeta de crédito. Si quieres construir una app de Streamlit con IA sin pagar por llamadas a la API, este es el camino más rápido que conozco.
La versión original de este artículo (marzo de 2024) usaba modelos Mistral en Groq. Eso ya no funciona. Groq retiró todos los modelos Mistral en julio de 2025. Esta guía actualizada usa Llama 3.1 8B Instant en su lugar: mismo nivel gratuito, misma velocidad de Groq y un modelo que sigue con soporte activo. El patrón de integración base no ha cambiado, así que la mayor parte de lo que aprendas aquí se aplica independientemente del modelo de Groq que elijas.
Puedes tener una app de Streamlit con IA funcionando en menos de 15 minutos.
Qué cambió desde 2024: la retirada de Mistral y los nuevos modelos
¿Vuelves desde la versión de 2024?
Sustituye model="mixtral-8x7b-32768" por model="llama-3.1-8b-instant" en tu código. Todo lo demás —la instalación del SDK, la configuración del cliente, el patrón de streaming— sigue funcionando igual.
Esta es la cronología:
- Feb 2024: Groq se lanza con modelos Mixtral y Mistral disponibles vía API.
- Marzo 2025:
mixtral-8x7b-32768queda obsoleto y se apaga. - Julio 2025: El último modelo Mistral en Groq (
mistral-saba-24b) queda obsoleto. No queda ningún modelo Mistral en la plataforma.
Si buscas Mistral específicamente, consulta la sección de alternativa a Mistral más abajo. Mistral AI opera su propia API con un nivel gratuito.
Modelos actuales del nivel gratuito (julio de 2026)
| ID del modelo | Ideal para | RPM gratis | TPM gratis | Velocidad |
|---|---|---|---|---|
llama-3.1-8b-instant |
Prototipado de alto volumen | 30 | 6.000 | ~560 TPS |
llama-3.3-70b-versatile |
Salida de calidad, tareas complejas | 30 | 12.000 | ~280 TPS |
openai/gpt-oss-20b |
Razonamiento, programación, uso de herramientas | 30 | 8.000 | ~1.000 TPS |
meta-llama/llama-4-scout-17b-16e-instruct |
Multimodal, contexto largo | 30 | 30.000 | ~750 TPS |
Para este tutorial, mi opción por defecto es llama-3.1-8b-instant. Es rápido, barato (si alguna vez llegas al nivel de pago) y suficientemente bueno para la mayor parte del trabajo de prototipado. Si necesitas una salida de mayor calidad, llama-3.3-70b-versatile es la mejora, a costa de límites de peticiones más bajos. Consulta los mejores LLM open source para una comparación más amplia de lo disponible hoy.
Groq también ofrece ahora un Developer Tier (pago por uso, requiere tarjeta de crédito) con límites aproximadamente 10 veces superiores a los del nivel gratuito y acceso a su Batch API. Para prototipado y apps pequeñas, el nivel gratuito es de sobra.
Si estás escalando y necesitas comparar costes de modelos entre proveedores, consulta los modelos de IA más baratos para flujos de trabajo con agentes.
Requisitos previos: lo que necesitas para empezar
- Python 3.10 o superior (el SDK de Groq soporta 3.7+, pero Streamlit requiere 3.10+ desde la v1.30)
- Una API key de Groq: regístrate en console.groq.com, no hace falta tarjeta de crédito
pip(el gestor de paquetes de Python)- Un terminal y un editor de texto
- Conocimientos básicos de Python (funciones, bucles, manejo de cadenas)
No se requiere tarjeta de crédito para el nivel gratuito de Groq. Regístrate, obtén tu API key y empieza a hacer llamadas de inmediato.
Si eres completamente nuevo en Python y en el desarrollo con IA, empieza primero por la guía de programación con IA para principiantes.
Configuración del SDK de Groq para Python
Instala el SDK de Groq y python-dotenv para gestionar tu API key:
pip install groq python-dotenvCrea un archivo .env en el directorio de tu proyecto:
echo 'GROQ_API_KEY=gsk_your_api_key_here' > .envSustituye gsk_your_api_key_here por la clave de console.groq.com/keys.
Ahora escribe un script rápido de verificación para confirmar que todo funciona:
import os
from dotenv import load_dotenv
from groq import Groq

load_dotenv()

client = Groq(api_key=os.environ.get("GROQ_API_KEY"))

completion = client.chat.completions.create(
    model="llama-3.1-8b-instant",
    messages=[{"role": "user", "content": "Say hello in one sentence."}],
    max_tokens=50,
)

print(completion.choices[0].message.content)
Ejecútalo:
python verify.pyVerifica la configuración
Deberías ver un saludo corto impreso en el terminal, algo como: “Hello! How can I assist you today?” Si ves esa salida, tu API key funciona y el SDK está instalado correctamente.
Fallos comunes y sus soluciones:
- “AuthenticationError: Invalid API Key”: Comprueba que
GROQ_API_KEYen tu archivo.envcoincide con la clave de console.groq.com/keys. Sin espacios al final. - “ModuleNotFoundError: No module named ‘groq’”: Ejecuta
pip install groqde nuevo. Si usas un entorno virtual, asegúrate de que esté activado. - “Python version not supported”: Necesitas Python 3.10+. Ejecuta
python3 --versionpara comprobarlo.
Cómo usar la API de Groq con Python
El patrón base es sencillo: crea un cliente, envía una petición de chat completion y maneja la respuesta en streaming.
Este es el ciclo de vida de la petición:
Script de Python → SDK de Groq → API de Groq (LPU) → Llama 3.1 8B → Respuesta en streamingEl SDK de Groq gestiona la conexión HTTP, los reintentos (2 reintentos automáticos ante errores transitorios) y la configuración de timeouts. No necesitas gestionar nada de eso para un uso básico.
Desglose de los parámetros de la API
completion = client.chat.completions.create(
    model="llama-3.1-8b-instant",
    messages=[
        {
            "role": "system",
            "content": "You are a YouTube expert who writes engaging titles."
        },
        {
            "role": "user",
            "content": "Install WordPress on Docker"
        }
    ],
    temperature=0.5,
    max_tokens=1024,
    top_p=1,
    stream=True,
)model: El ID del modelo.llama-3.1-8b-instantes la opción rápida por defecto del nivel gratuito.messages: Una lista de objetos de mensaje. El rolsystemfija el comportamiento; el roluseraporta tu prompt.temperature(0-2): Controla la aleatoriedad. 0.5 da una salida enfocada pero no rígida. Usa 0 para respuestas deterministas y 1+ para respuestas más creativas.max_tokens: Máximo de tokens en la respuesta. 1024 es de sobra para 10 títulos de YouTube. El artículo antiguo usaba 5640, que era demasiado alto.top_p: Alternativa atemperaturepara el nucleus sampling. 1 significa sin filtrado. Déjalo en 1 salvo que tengas una razón concreta para cambiarlo.stream:Trueemite los fragmentos a medida que se generan. Da una latencia percibida mucho mejor en una UI.
El SDK de Groq reintenta automáticamente dos veces ante errores transitorios (timeouts de red, respuestas 5xx). Solo necesitas lógica de reintento manual para los límites de peticiones (HTTP 429).
Script completo en Python con manejo de errores
import os
from dotenv import load_dotenv
from groq import Groq

load_dotenv()

client = Groq(api_key=os.environ.get("GROQ_API_KEY"))

try:
    completion = client.chat.completions.create(
        model="llama-3.1-8b-instant",
        messages=[
            {
                "role": "system",
                "content": "You are a YouTube expert creator who likes to write engaging titles for a keyword. You will provide 10 attention-grabbing YouTube titles on keywords specified by the user."
            },
            {
                "role": "user",
                "content": "Install WordPress on Docker"
            }
        ],
        temperature=0.5,
        max_tokens=1024,
        top_p=1,
        stream=True,
    )

    for chunk in completion:
        content = chunk.choices[0].delta.content
        if content:
            print(content, end="")

except groq.RateLimitError:
    print("Rate limit hit. Wait a minute and try again.")
except groq.APIConnectionError:
    print("Network issue. Check your internet connection.")
except groq.APIStatusError as e:
    print(f"API error {e.status_code}: {e.response}")
except Exception as e:
    print(f"Unexpected error: {e}")
Al ejecutarlo verás los títulos de YouTube llegar a tu terminal en tiempo real. La velocidad se nota. La LPU de Groq genera tokens significativamente más rápido que la mayoría de las APIs en la nube.
Construye una app de Streamlit con Groq y Llama 3.1
Streamlit convierte cualquier función de Python en una UI web con un mínimo boilerplate. Si has probado otros frameworks de UI en Python, sabrás que Streamlit sacrifica personalización a cambio de velocidad de desarrollo. Para una demo rápida de IA, es el intercambio correcto. Para una comparación más profunda, consulta Streamlit vs NiceGUI.
Instala Streamlit:
pip install streamlitCrea app.py:
import os
from dotenv import load_dotenv
import streamlit as st
from groq import Groq

load_dotenv()

def get_groq_completions(user_content):
    client = Groq(api_key=os.environ.get("GROQ_API_KEY"))

    completion = client.chat.completions.create(
        model="llama-3.1-8b-instant",
        messages=[
            {
                "role": "system",
                "content": "You are a YouTube expert creator who likes to write engaging titles for a keyword. You will provide 10 attention-grabbing YouTube titles on keywords specified by the user."
            },
            {
                "role": "user",
                "content": user_content
            }
        ],
        temperature=0.5,
        max_tokens=1024,
        top_p=1,
        stream=True,
    )

    result = ""
    for chunk in completion:
        content = chunk.choices[0].delta.content
        if content:
            result += content
    return result

def main():
    st.title("YouTube Title Generator")
    st.write("Powered by Groq LPU + Llama 3.1 8B")

    user_content = st.text_input("Enter the keyword for YouTube titles:")

    if st.button("Generate Titles"):
        if not user_content:
            st.warning("Please enter a keyword before generating titles.")
            return

        with st.spinner("Generating titles..."):
            try:
                generated_titles = get_groq_completions(user_content)
                st.success("Titles generated successfully!")
                st.markdown("### Generated Titles:")
                st.text_area("", value=generated_titles, height=200)
            except Exception as e:
                st.error(f"Error: {e}")

if __name__ == "__main__":
    main()
Ejecútala:
streamlit run app.py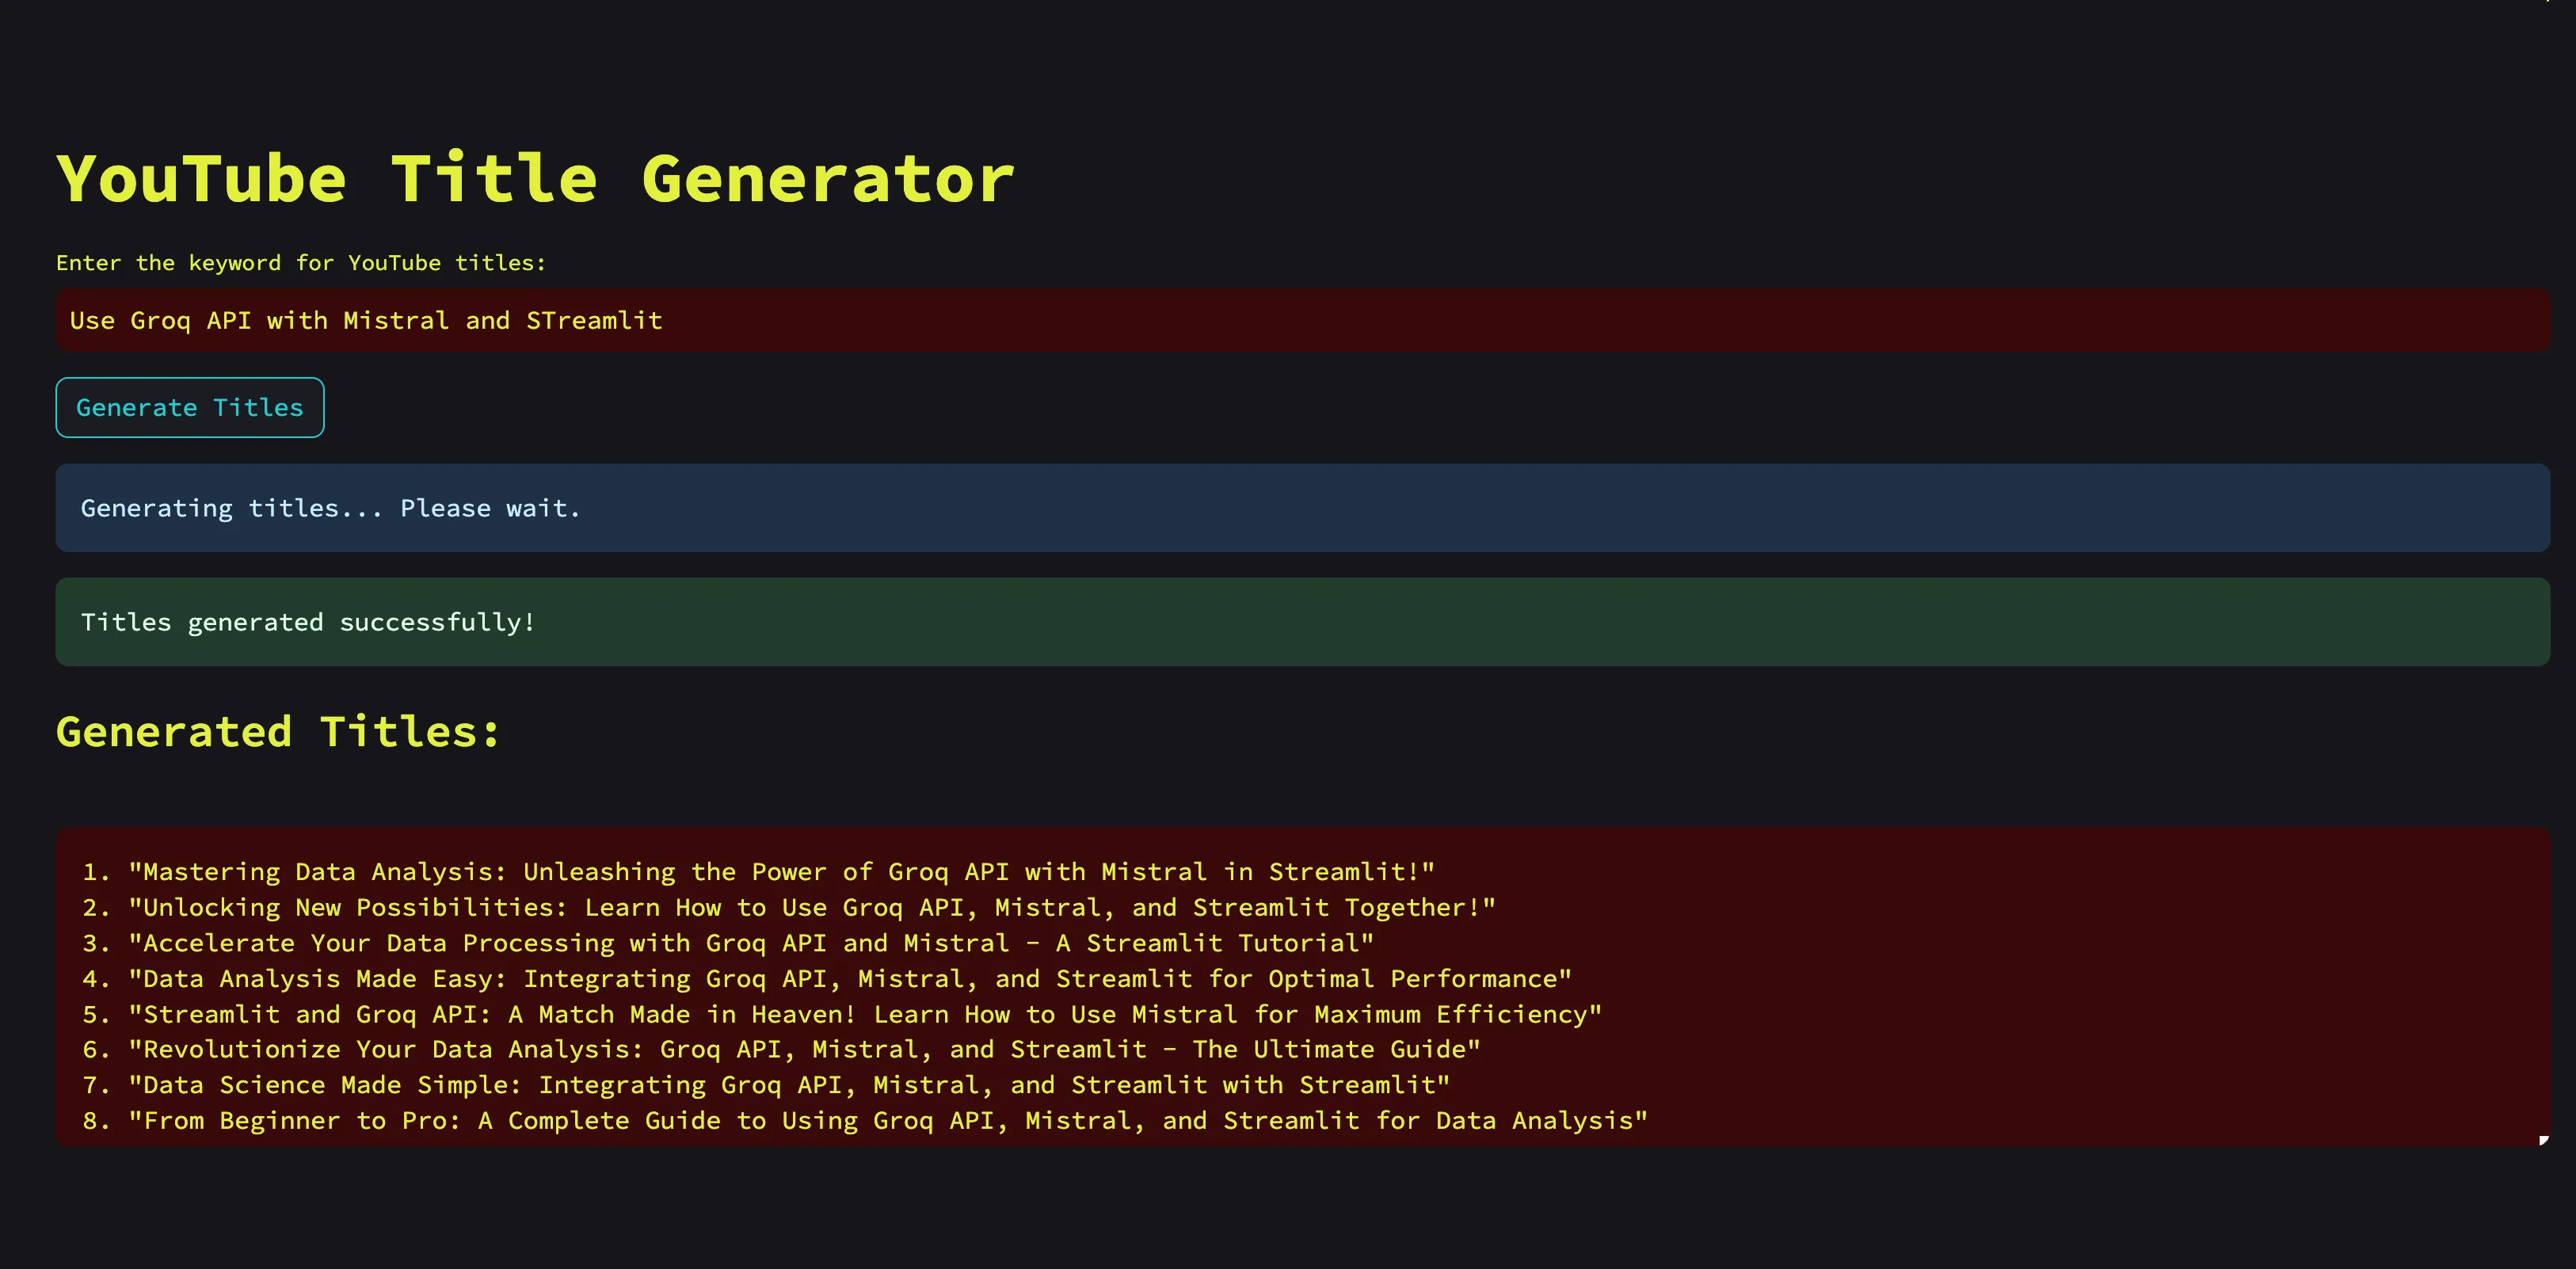
La app se abre en http://localhost:8501. Introduce una palabra clave, haz clic en “Generate Titles” y verás los resultados aparecer en el área de texto.
Algunas cosas a tener en cuenta sobre el código anterior:
st.spinneren lugar dest.info: muestra una animación de carga, que es mejor UX que un mensaje estático.- Manejo de errores en la UI:
st.error()muestra los errores en línea en lugar de romper la app. load_dotenv(): carga el archivo.envautomáticamente. Para el despliegue en Streamlit Cloud, usast.secretsen su lugar (se cubre en la sección de despliegue).
Cómo elegir el modelo de Groq adecuado para tu app
El llama-3.1-8b-instant por defecto funciona bien para la mayor parte del prototipado. Pero Groq ofrece varios modelos, y la elección correcta depende de tu caso de uso.
Llama 3.1 8B Instant
Ideal para: Prototipado de alto volumen, iteración rápida, tareas de generación sencillas.
Este es el demonio de la velocidad. ~560 tokens por segundo en el nivel gratuito, 14.400 peticiones al día. Úsalo como opción por defecto salvo que tengas una razón para no hacerlo.
model="llama-3.1-8b-instant",Llama 3.3 70B Versatile
Ideal para: Salida de mayor calidad, instrucciones complejas, texto con matices.
El modelo más grande produce una salida notablemente mejor para tareas que requieren razonamiento o matices. El intercambio: más lento (~280 TPS), límite de peticiones diarias más bajo (1.000 RPD) y alcanzarás los límites antes.
model="llama-3.3-70b-versatile",GPT-OSS 20B
Ideal para: Tareas de razonamiento, asistencia de programación, uso de herramientas.
El modelo de pesos abiertos de OpenAI corriendo sobre hardware de Groq. Bueno en salida estructurada y en seguir instrucciones complejas. ~1.000 TPS con 1.000 RPD en el nivel gratuito.
model="openai/gpt-oss-20b",Groq cachea automáticamente los system prompts repetidos con un ahorro del 50% de tokens en las partes cacheadas. Sin configuración. Simplemente funciona cuando tu app envía el mismo system prompt entre peticiones. Esto importa más cuando pasas al nivel de pago.
Gestión de límites de peticiones y errores en el nivel gratuito
El artículo original no tenía ningún manejo de errores. En el nivel gratuito, acabarás topando con los límites de peticiones, sobre todo si pruebas rápido o construyes algo que la gente usa de verdad. Esto es lo que necesitas saber.
Límites del nivel gratuito por modelo
| Modelo | RPM | RPD | TPM | TPD |
|---|---|---|---|---|
llama-3.1-8b-instant |
30 | 14.400 | 6.000 | 500.000 |
llama-3.3-70b-versatile |
30 | 1.000 | 12.000 | 100.000 |
openai/gpt-oss-20b |
30 | 1.000 | 8.000 | 200.000 |
RPM = peticiones por minuto, RPD = peticiones por día, TPM = tokens por minuto, TPD = tokens por día.
Para una app demo personal, estos límites son generosos. Para cualquier cosa con usuarios reales, te quedarás corto rápido.
Patrón de manejo de errores para Streamlit
import groq

def get_groq_completions(user_content):
    client = Groq(api_key=os.environ.get("GROQ_API_KEY"))

    try:
        completion = client.chat.completions.create(
            model="llama-3.1-8b-instant",
            messages=[
                {"role": "system", "content": "You are a YouTube expert..."},
                {"role": "user", "content": user_content}
            ],
            temperature=0.5,
            max_tokens=1024,
            stream=True,
        )

        result = ""
        for chunk in completion:
            content = chunk.choices[0].delta.content
            if content:
                result += content
        return result

    except groq.RateLimitError:
        return "⏳ Rate limit hit. Please wait about a minute and try again."
    except groq.APIConnectionError:
        return "🔌 Network error. Check your internet connection."
    except groq.APIStatusError as e:
        return f"⚠️ API error ({e.status_code}): Please try again later."
Lo clave: muestra al usuario un mensaje sobre el que pueda actuar. Un stack trace críptico en una app de Streamlit no ayuda a nadie.
El nivel gratuito es generoso para prototipado y uso personal, pero tiene límites duros. Si los alcanzas con regularidad, el Developer Tier de Groq es de pago por uso con límites aproximadamente 10 veces más altos. Sin compromiso.
Qué te dicen las cabeceras de límite de peticiones
La respuesta de la API de Groq incluye cabeceras que puedes inspeccionar programáticamente:
x-ratelimit-remaining-requests: Peticiones restantes en la ventana actualx-ratelimit-remaining-tokens: Tokens restantes en la ventana actualx-ratelimit-reset-tokens: Tiempo hasta que se reinicia el límite de tokens
Para una app de Streamlit sencilla no necesitas parsearlas. Pero si construyes algo más complejo (procesamiento en cola, apps multiusuario), monitorizar estas cabeceras te permite implementar un backoff proactivo en lugar de esperar a un error 429.
Despliegue de tu app de Streamlit
Una vez que tu app funciona en local, querrás desplegarla. Dos caminos principales:
Streamlit Community Cloud (gratis)
Streamlit Community Cloud aloja apps públicas gratis. Es el camino más rápido a una URL pública.
Pasos:
-
Sube tu código a un repositorio de GitHub. Incluye:
app.pyrequirements.txt(ver abajo).envNO se sube. Añade tu API key a través de los secretos de Streamlit en su lugar
-
Ve a share.streamlit.io e inicia sesión con GitHub.
-
Haz clic en “New app” → selecciona tu repo, la rama y el archivo
app.py. -
Antes de desplegar, haz clic en “Advanced settings” → pega tus secretos en formato TOML:
GROQ_API_KEY = "gsk_your_api_key_here"- En tu código, sustituye
os.environ.get("GROQ_API_KEY")porst.secrets["GROQ_API_KEY"]para el despliegue en Streamlit Cloud (o mantén ambos —st.secretsrecurre a las variables de entorno como alternativa).
requirements.txt:
groq
python-dotenv
streamlit
Limitaciones a conocer:
- Límite de ~1 GB de RAM
- Las apps duermen tras 12 horas de inactividad. El primer visitante ve una pantalla de “waking up”
- Solo 1 app privada (apps públicas ilimitadas)
- Sin dominios personalizados — estás atado a
tuapp.streamlit.app - GitHub obligatorio para desplegar
Para una demo rápida o una pieza de portfolio, estos límites están bien. Para cualquier cosa con tráfico regular, despliega en un VPS.
VPS con Docker
Ejecutar en un VPS te da control total: sin suspensión, sin límites de RAM, dominio personalizado, y puedes correr varias apps en el mismo servidor.
Crea un Dockerfile:
FROM python:3.12-slim

WORKDIR /app
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt
COPY . .

EXPOSE 8501
CMD ["streamlit", "run", "app.py", "--server.port=8501", "--server.address=0.0.0.0"]docker-compose.yml:
services:
  app:
    build: .
    ports:
      - "8501:8501"
    environment:
      - GROQ_API_KEY=${GROQ_API_KEY}
    restart: unless-stopped
Despliega:
# Configura tu API key
export GROQ_API_KEY=gsk_your_api_key_here

# Construye y ejecuta
docker compose up -d
Para TLS y un dominio personalizado, ponlo detrás de un reverse proxy. He cubierto en detalle cómo desplegar tu app de Streamlit en un VPS detrás de Cloudflare Tunnels. Para patrones generales de Docker, consulta cómo ejecutar apps de Python en Docker.
Para el hosting VPS yo uso Hetzner Cloud — un CX22 (2 vCPU, 4 GB de RAM) es más que suficiente para una app de Streamlit y cuesta unos 4 €/mes. Hostinger VPS es otra opción económica sólida con almacenamiento NVMe.
Los precios de los VPS subieron en todos los proveedores en 2026 — si estás replanteándote una máquina alquilada, consulta qué cambió y cuándo gana un mini PC.
Community Cloud está bien para demos y piezas de portfolio. Para cualquier cosa con usuarios reales, el límite de 1 GB de RAM y el temporizador de suspensión de 12 horas causarán problemas. Un VPS barato vale los pocos euros al mes.
Alternativa a Mistral: usar la API propia de Mistral
Los modelos Mistral ya no están disponibles en Groq. Si necesitas Mistral específicamente, su propia API (La Plateforme) tiene un nivel gratuito “Experiment”.
Si llegaste a este artículo buscando Mistral en concreto, Mistral AI opera su propia API en console.mistral.ai. El nivel gratuito “Experiment” te da acceso a sus modelos actuales, incluidos Mistral Small y Mistral Nemo.
Ejemplo rápido con el SDK de Python mistralai:
pip install mistralai python-dotenvimport os
from dotenv import load_dotenv
from mistralai import Mistral
load_dotenv()
client = Mistral(api_key=os.environ.get("MISTRAL_API_KEY"))
completion = client.chat.complete(
model="mistral-small-latest",
messages=[
{"role": "system", "content": "You are a YouTube expert who writes engaging titles."},
{"role": "user", "content": "Install WordPress on Docker"}
],
temperature=0.5,
max_tokens=1024,
)
print(completion.choices[0].message.content)El patrón es similar al de Groq. La diferencia principal: la API de Mistral corre sobre su propia infraestructura, así que no obtienes la ventaja de velocidad de la LPU de Groq. Pero los modelos en sí son competitivos, sobre todo para requisitos de residencia de datos en Europa.
Conclusión y próximos pasos
La API gratuita de Groq más Streamlit te da una app de IA funcionando en minutos, sin tarjeta de crédito y sin infraestructura que gestionar. La integración es directa: instala el SDK, envía chat completions y muestra los resultados.
Comparado con la versión de 2024 de este artículo:
- El modelo cambió de Mixtral a Llama 3.1 8B Instant (Mixtral quedó obsoleto)
- El manejo de errores ahora está incluido (el original no tenía ninguno)
- Los límites de peticiones están documentados (el original ni los mencionaba)
- Las opciones de despliegue cubren tanto el Community Cloud gratuito como Docker en un VPS
Adónde ir desde aquí:
- Prueba distintos modelos — cambia
llama-3.1-8b-instantporllama-3.3-70b-versatiley compara la calidad de salida - Añade historial de chat — usa
st.session_statepara mantener el contexto de conversación entre interacciones - Salidas estructuradas — usa
response_formatde Groq con JSON schema para obtener datos limpios en lugar de parsear texto (útil para el generador de títulos de YouTube — imagina recibir un array JSON de títulos) - Construye algo más complejo — prueba a crear un equipo de investigación de IA con Streamlit o construir un agente de IA completo
- Ejecuta modelos en local — si la privacidad importa, puedes ejecutar LLM en local con Ollama y saltarte la API en la nube por completo
Preguntas frecuentes
¿La API de Groq es realmente gratuita? Sí. El nivel gratuito no requiere tarjeta de crédito y te da acceso a varios modelos, incluidos Llama 3.1 8B, Llama 3.3 70B y GPT-OSS 20B. Cada modelo tiene sus propios límites de peticiones (peticiones por minuto, tokens por día), pero para uso personal y de prototipado son generosos.
¿Por qué desaparecieron los modelos Mistral de Groq?
Las asociaciones de modelos de Groq evolucionaron. Mixtral quedó obsoleto en marzo de 2025, y el último modelo Mistral (mistral-saba-24b) se retiró en julio de 2025. Los modelos Llama y GPT-OSS los reemplazaron en la plataforma. Si necesitas Mistral en concreto, usa su propia API en console.mistral.ai.
¿Puedo usar Groq para apps en producción? El nivel gratuito funciona para prototipado y pequeñas herramientas internas. Para tráfico de producción con usuarios reales, alcanzarás los límites de peticiones rápido. El Developer Tier de Groq es de pago por uso, con límites significativamente más altos y acceso a la Batch API con un 50% de descuento sobre el precio estándar.
¿Cómo se compara Groq con la API de OpenAI en velocidad? El hardware LPU de Groq ofrece consistentemente velocidades de inferencia más rápidas que la mayoría de las APIs en la nube. Llama 3.1 8B en Groq corre a ~560 tokens por segundo. Las comparaciones exactas dependen del tamaño del modelo y del proveedor, pero para modelos open source, Groq está entre las opciones más rápidas disponibles.