
LM Studio Bionic Review (2026): Lokaler AI-Agent auf dem M4 Mac Mini getestet
Wir haben LM Studio Bionic auf einem M4 Pro Mac Mini mit 24 GB getestet. So schlagen sich Code- und Work-Workspaces, Voxtral-Spracheingabe und MCP – und welche lokalen Coding-Modelle mithalten.
10 Min. Lesezeit
LM Studio hat gerade Bionic ausgeliefert, eine separate Desktop-App, die als AI-Agent für offene Modelle gebaut ist. Stell dir einen Coding-Agent im Codex-Stil und Cloud-Co-Work-Tools vor, aber in erster Linie für lokale LLMs gedacht – mit optionalen Secure-Cloud-Modellen, wenn du mehr Power brauchst.
Ich habe es auf einem M4 Pro Mac Mini mit 24 GB RAM getestet, mit kleinen MLX-Modellen für Geschwindigkeit, plus Vision, Dateianalyse und Voxtral-Spracheingabe. Es ist ein frühes Produkt. Die Idee ist stark. Die tatsächliche Coding-Qualität hängt aber immer noch fast komplett davon ab, welches Modell du lädst.
Offizielle Ankündigung: Introducing LM Studio Bionic.
Wenn du schon Terminal-Agents nutzt, vergleiche das mit dem OpenCode-Setup-Guide, der Codex-App mit beliebigem Modell und dem Roundup der GitHub-Copilot-Alternativen.
Was ist LM Studio Bionic?
Bionic ist kein Redesign der klassischen LM-Studio-Chat-UI. Es ist eine neue App für Agent-Arbeit:
- Code-Projekte für repo-bewusstes Coding, Datei-Edits, Shell-Befehle und Review
- Work-Projekte für Docs, PDFs, Notizen, Bildverständnis und allgemeine Aufgaben
- Lokale Modelle über die LM-Studio-Runtime (GGUF, MLX auf Apple Silicon)
- Secure Cloud: Frontier-Open-Modelle mit standardmäßig null Datenspeicherung
- Spracheingabe mit lokaler Transkription (Voxtral von Mistral zum Launch)
- MCP / verbundene Apps (Notion und andere Server) für Tools jenseits des Dateisystems
LM Studio existiert weiterhin für das Low-Level-Modellmanagement. Bionic ist die Agent-Schicht darüber.
Das Privacy-Versprechen
LM Studio sagt, Bionic hat null Datenspeicherung und trainiert nicht auf deinen Daten. Lokale Inferenz verlässt deine Maschine nie. Cloud-Aufrufe werden transient verarbeitet. Websuche und einige Cloud-Features erfordern ihren Plan.
Plattformen und Installation
Bionic ist für macOS, Windows und Linux verfügbar. Download von lmstudio.ai.
Auf dem Mac ist die Installation ein normaler App-Download. Nach dem Start bekommst du:
- Workspaces-/Projektliste
- Modellbibliothek und geladene Instanzen
- Einstellungen (Allgemein, Updates, Websuche, Erscheinungsbild, Stimme, verknüpfte Geräte)
- Den Erstellungsflow für Code- vs. Work-Projekte
Verknüpfte Geräte waren zum Testzeitpunkt noch per Warteliste geregelt.
Code- vs. Work-Workspaces
Diese Trennung ist wichtig.
Code-Workspace
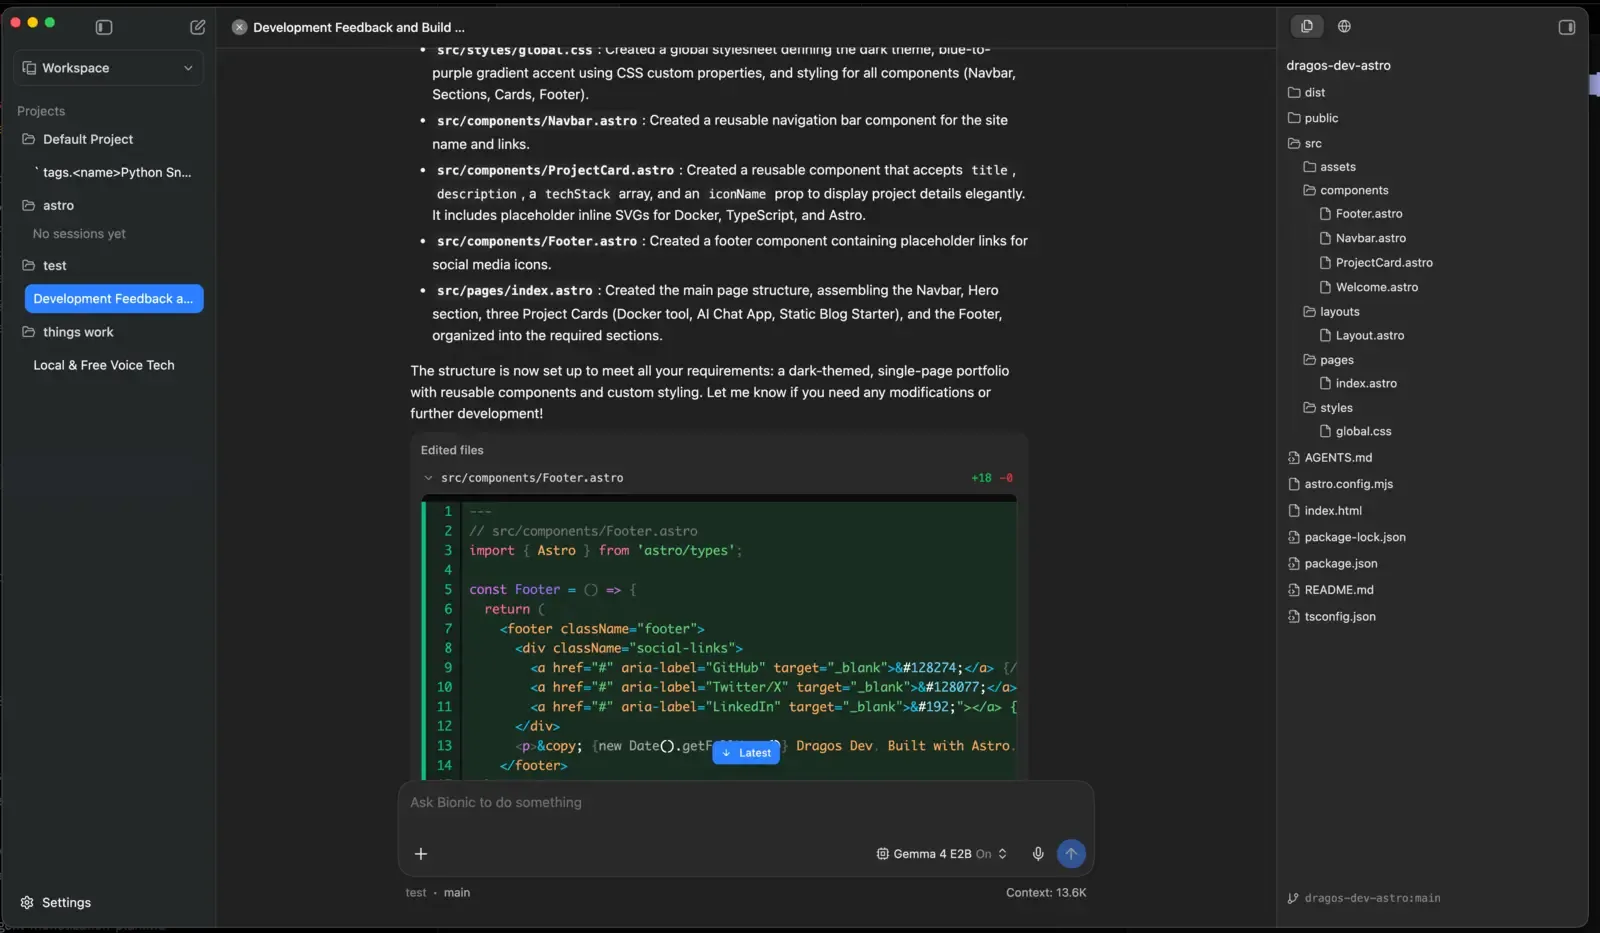
Erstelle ein Code-Projekt, benenne es, wähle ein Modell und hänge einen lokalen Ordner an (zum Beispiel eine Astro-Site).
In der Code-UI bekommst du typischerweise:
- Chat-/Agent-Timeline mit Reasoning
- Dateibaum an der Seite
- In-App-Browser / Previews
- Kontext-Verbrauchsanzeige
- Aktivitäts-/Tool-Call-Ansicht, während der Agent schreibt und Befehle ausführt
Offiziell soll Bionic Repos inspizieren, Code editieren, Diffs zeigen und die Codebase durchsuchen. In der Praxis hinkt der Feinschliff noch hinter ausgereiften Tools wie der Codex-App oder OpenCode her.
Work-Workspace
Work-Projekte lassen die Anforderung „öffne einen Coding-Ordner” weg. Du kannst externe Dateien und Ordner später anhängen.
Gute Einsatzfälle:
- Bild-Q&A
- Transkripte und Notizen
- PDFs und Docs
- Leichte Recherche mit lokalen Dateien
- Voice-first-Chat
Das ist eher ein privater Co-Worker als ein vollwertiger IDE-Agent.
Praxistest: M4 Pro Mac Mini, 24 GB RAM
Hardware und Modellwahl
Ich habe MLX-Modelle auf Apple Silicon genutzt und mit einem kleinen, schnellen Modell gestartet:
| Einstellung | Wert |
|---|---|
| Maschine | Mac Mini M4 Pro, 24 GB Unified Memory |
| Format | MLX |
| Testmodell | Gemma 4 E2B (~4 GB, Tools + Vision + Reasoning) |
| Kontext | Auf Maximum für das kleine Modell |
| Voice-Modell | Voxtral (~3 GB) |
| Beobachteter Speicher-Peak | ~20 GB mit Agent + Aufnahme + geladenem Modell |
Warum zuerst ein winziges Modell? Auf 24 GB füllen große Coding-Modelle plus langer Kontext das RAM schnell. Ein 2B-Klasse-Modell beantwortet die eigentliche Produktfrage: Ist Bionic brauchbar, oder nur mit riesigen Cloud-Gewichten beeindruckend?
Coding-Test: Portfolio-Site in Astro
Ich habe einen Code-Workspace auf ein Astro-Projekt gezeigt und eine mehrseitige Portfolio-Site mit Komponenten und SVGs angefragt.
Was funktioniert hat:
- Agent-Loop startete, reasoned und legte Dateien an
- Kontext-Anzeige war sichtbar (zum Beispiel ~8K genutzt von einem großen Max-Fenster)
- Tool-/Aktivitätsansicht zeigte, was es tat
- Build-Befehle konnten vom Agent aus versucht werden
Was mit dem kleinen Modell nicht gut funktioniert hat:
- Unvollständige Astro-Komponenten-Verdrahtung (fehlende Imports / Page-Komposition)
- Schwaches Framework-Wissen (Astro-Spezifika)
- Keine klare Hervorhebung geänderter Dateien wie bei einem ausgereiften IDE-Agenten
- Eingeschränkte Editor-Erfahrung (mehr anschauen als editieren)
- Einige Shell-/Datei-Schreibversuche schlugen fehl oder fielen auf das Dumpen kompletter Dateiinhalte in den Chat zurück
- Geschwindigkeit war langsamer als erwartet für ein 2B-Modell auf M4 Pro, sobald Thinking und Tools dazukamen
Als ich es bat, auf ein statisches index.html zurückzufallen, kämpfte es immer noch mit sauberer Dateierstellung und Geschwindigkeit. Das Ergebnis war „chat-brauchbar”, nicht „ship-diese-Site”.
Modellqualität ist der Engpass
Bionic kann Tools orchestrieren, aber ein lokales 2B-Modell ist kein Codex-Ersatz für Multi-File-Web-Frameworks. Für ernsthaftes lokales Coding nutze eine stärkere Modellklasse (siehe Empfehlungen unten). Für Astro-Arbeit im Speziellen gewinnen heute noch Terminal-Agents mit besseren Modellen.
Work-Test: Vision und Dateien
In einem Work-Workspace konnte dasselbe kleine vision-fähige Modell:
- Ein hochgeladenes Bild schnell und treffend beschreiben
- Externe Dateien und Ordner für Kontext anhängen
- Ein Video-Transkript lesen, sobald der Pfad für den Agent verfügbar war
Diese Seite fühlte sich auf begrenzter Hardware praktischer an. Dokument- und Bildaufgaben brauchen weniger mehrstufige Code-Korrektheit als Repo-Edits.
Spracheingabe mit Voxtral
Die Spracheingabe ist eines der stärksten frühen Features. Bionic bringt lokale Transkription mit Voxtral (Mistral) mit. Plane ungefähr 3 GB zusätzliches Modellgewicht ein.
Im Test:
- Zuhören / Transkription fühlte sich nach dem Laden des Modells schnell an
- Nützlich, um Prompts zu diktieren, ohne die App zu verlassen
- Der Speicherdruck steigt wieder, wenn Stimme + Haupt-LLM beide resident sind
Wenn du hauptsächlich systemweite Mac-Diktatfunktion statt einer Agent-Tastatur willst, schau dir auch FluidVoice an.
MCP und verbundene Apps
Unter „Verbundene Apps” kannst du externe Tools und MCP-Server anbinden (zum Beispiel Notion). Das ist die richtige Richtung für einen Desktop-Agenten: lokales Modell + Tools + deine Datenquellen.
Wenn MCP neu für dich ist, starte mit dem MCP-Einsteigerguide.
Einstellungen, die man kennen sollte
| Bereich | Hinweise |
|---|---|
| Modellbibliothek | Lokale Modelle laden, auf Apple Silicon MLX bevorzugen |
| Kontextgröße | Vorsichtig erhöhen; RAM füllt sich mit Kontext + Modell + Tools |
| Temperatur / System-Prompt | Pro-Modell-Regler bleiben für Agents wichtig |
| Websuche | Cloud-Plan-Feature im aktuellen Build |
| Stimme | Voxtral aktivieren, wenn du Diktat brauchst |
| Verknüpfte Geräte | Warteliste während des Early Release |
| Geladene Instanzen | Zeigt RAM-Verbrauch (zum Beispiel ~4,3 GB für ein kleines Tools+Vision-Modell) |
Modell-Empfehlungen für Bionic (2026)
Bionic ist nur so gut wie das Modell. Nutze aktuelle offene Modelle, keine ein Jahr alten 7B-Chat-Fine-Tunes.
Lokal auf einem ~24-GB-Mac (MLX)
| Ziel | Modellrichtung | Warum |
|---|---|---|
| Schneller UI-Test | Kleines Gemma 4 / ähnliches ~2B–4B-Tools-Modell | Sofortiger Gefühlscheck für Bionic selbst |
| Besseres lokales Coding | Qwen 3.6 35B-A3B oder Qwen 3.6 27B | Starkes Coding für die Größe; MoE A3B ist freundlicher zum Unified Memory |
| Vision + leichter Agent | Gemma-4-Klasse multimodale MLX-Builds | Bild + Tools ohne Cloud |
| Stimme | Voxtral (eingebauter Pfad) | Lokale Transkription |
Auf 24 GB lass Headroom für OS, Browser, Aufnahme und Agent-Overhead. Ein „brauchbares” Coding-Modell ist oft wertvoller als das größte Modell, das gerade so lädt.
Stärkeres Coding (lokal, wenn du RAM/VRAM hast, sonst Cloud)
Für Agent-Coding-Qualität näher an täglicher Codex-/Claude-Arbeit nutze den aktuellen offenen Coding-Stack aus den besten Open-Source-Claude-Alternativen:
- GLM-5.2 — gerade das stärkste offene Coding-Flaggschiff insgesamt
- Qwen 3.6 Plus / Max — exzellentes Agent-Coding via API oder OpenCode Go
- MiniMax M3 — günstige lange Sessions
- MiMo V2.5 Pro — solides Coding-Agent-Modell
- Kimi K2 / K2.x Code — langer Kontext und Coding (siehe Kimi K2); offizielle Bionic-Materialien nennen außerdem Kimi K2.7 Code für Agent-Arbeit
Bionics Secure Cloud ist nützlich, wenn dein Laptop diese Gewichte nicht hosten kann. Für API-artiges Multi-Modell-Routing außerhalb von Bionic bleiben OpenCode Go und die Codex-Any-Model-Config starke Optionen.
Alternativen im lokalen Stack
Wenn du reine lokale Inferenz ohne Bionics Agent-UI willst:
- Ollama-Docker-Install für einen einfachen lokalen Server
- OpenClaw + Ollama für einen Messaging-/Assistant-Workflow auf lokalen Modellen
- AI-Programmierungs-Einsteigerguide, wenn du noch zwischen Chat-Apps, IDEs und Agents wählst
Bionic vs. Codex vs. OpenCode
| Feature | LM Studio Bionic | Codex-App | OpenCode |
|---|---|---|---|
| Fokus | Local-first-Agent für offene Modelle | Polierte Coding-Agent-UI | Open-Source-Terminal-Agent |
| Lokale Modelle | First-class | Möglich via Custom Provider | Via Ollama / lokale Endpoints |
| Cloud-Open-Modelle | Secure Cloud + optionale Plan-Features | ChatGPT-Plan + jeder OpenAI-kompatible | Viele Provider + Go-Plan |
| Heute am stärksten | Privater lokaler Agent + Docs/Stimme | Coding-UX mit höchstem Feinschliff | Flexible CLI-Workflows |
| Heute schwach | Frühe UI, Small-Model-Coding-Qualität | Lokal ist nicht die Default-Story | Weniger „Desktop-Produkt”-Gefühl |
Ehrliche Einordnung nach der Mac-Mini-Session: Bionic hat die richtige Produktform für private Open-Model-Agents, ist aber früh. Für produktives Coding diese Woche greife ich weiterhin zu Codex oder OpenCode mit einem starken Modell. Für privaten Chat, Vision, Notizen und lokale Experimente ist Bionic schon jetzt interessant.
Pros und Cons
Pros
- Echter Local-first-Agent-Pfad für offene Modelle
- Klare Code- vs. Work-Projekt-Trennung
- MLX-Pfad auf Apple Silicon
- Lokale Spracheingabe mit Voxtral
- MCP- / Connected-Apps-Richtung
- Optionale Secure Cloud mit Zero-Data-Retention-Versprechen
- Verfügbar für Mac, Windows und Linux
Cons
- Frühe UX: Sichtbarkeit von Dateiänderungen und Editing noch dünn
- Kleine lokale Modelle kämpfen mit echten Multi-File-Frameworks
- RAM-Druck ist real auf 24 GB, sobald Modell + Stimme + Agent laufen
- Websuche und einige Power-Features hängen am Cloud-Plan
- Noch nicht so poliert wie Codex für tägliches Coding
Wer sollte Bionic jetzt ausprobieren?
Probier es, wenn du:
- Einen Desktop-Agenten willst, der lokale offene Modelle bevorzugt
- Wert auf Privacy bei Notizen, Docs und leichtem Coding legst
- Schon MLX/GGUF-Modelle fährst und eine Agent-Shell darum willst
- Lokales Diktieren in einem AI-Workspace brauchst
Warte oder nutz etwas anderes, wenn du:
- Heute zuverlässiges Multi-File-Produktions-Coding brauchst
- Nur 8–16 GB RAM hast und große Coding-Modelle erwartest
- Einen ausgereiften Terminal-Agent (OpenCode) oder die Codex-UI (Any-Model-Setup) bevorzugst
Checkliste für den Start
- Bionic von lmstudio.ai laden
- Ein Modell installieren, das zu deinem RAM passt (MLX auf dem Mac)
- Ein Code-Projekt zuerst für einen einfachen Ordner anlegen, nicht für dein Monorepo
- Ein Work-Projekt für Docs/Bilder anlegen
- Optional Voxtral-Spracheingabe aktivieren, wenn du RAM übrig hast
- MCP-Apps erst hinzufügen, wenn Basis-Chat/Tools stabil wirken
- Für harte Coding-Aufgaben auf ein stärkeres lokales oder Secure-Cloud-Modell wechseln
FAQ
Ist LM Studio Bionic kostenlos?
Lokale Modelle laufen auf deiner Maschine. Die App ist kostenlos zum Download. Cloud-Modelle, Websuche und plan-gebundene Features können einen LM-Studio-Account und Billing erfordern. Prüfe die aktuellen Preise immer auf der offiziellen Site.
Ist Bionic dasselbe wie LM Studio?
Nein. Bionic ist eine separate Agent-App. Das klassische LM Studio bleibt für Low-Level-Modellmanagement und Chat nützlich. Du kannst beide nutzen.
Kann es Codex oder Claude Code ersetzen?
Noch nicht für ernsthafte Multi-File-Arbeit, besonders mit kleinen lokalen Modellen. Mit stärkeren offenen Coding-Modellen (GLM-5.2, Qwen 3.6, Kimi-Code-Klasse) wird es eine realistische private Alternative für viele Aufgaben. Für maximalen Feinschliff heute führen Codex/OpenCode weiterhin.
Wie viel Mac-RAM brauchst du?
16 GB sind die praktische Untergrenze für leichte Modelle. 24 GB reichten für ein kleines Tools+Vision-Modell plus Agent-Overhead, aber der Speicher saß während des Tests nahe am Maximum. 32 GB+ sind komfortabler, wenn du bessere Coding-Modelle und Stimme gleichzeitig willst.
Unterstützt es MCP?
Ja. Verbundene Apps / MCP-Server sind Teil der Produkt-Richtung, du kannst also Tools wie Notion-artige Integrationen anbinden. Sieh dir unsere MCP-Einführung für die Protokoll-Basics an.
Fazit
LM Studio Bionic ist der größte Produkt-Schritt, den LM Studio Richtung Arbeit erledigen gemacht hat, statt nur mit lokalen Modellen zu chatten. Code- und Work-Workspaces, lokale Spracheingabe, MCP-Hooks und die optionale Secure Cloud ergeben eine kohärente Local-first-Agent-Story.
Auf einem M4 Pro mit 24 GB ist die App selbst brauchbar. Ein winziges Gemma-Klasse-Modell reicht für Demos, Vision und leichte Work-Aufgaben, aber nicht, um echte Astro-/React-Projekte zu shippen. Kombiniere Bionic mit einem modernen Coding-Modell (oder Secure Cloud), und es wird deutlich interessanter.
Das komplette Walkthrough gibt es hier:
Weiterführende Lektüre, wenn du einen lokalen AI-Stack aufbaust:
Ähnliche Artikel
Hat diese Anleitung bei dir funktioniert?

Geschrieben von Dragos
Dragos is the author of Bitdoze — practical DevOps, programming, and self-hosting guides.
Mehr Anleitungen von Dragos →Brauchst du Hilfe bei Astro, VPS oder einer Self-hosted-App? Services ansehen →