
Die besten Open-Source-LLMs als Ersatz für Claude Opus 5.5 (2026)
Die besten Open-Source-LLMs als Ersatz für Claude Opus 5.5 oder GPT-6 in 2026: MiMo-V2.6-Pro, GLM-5.3, DeepSeek V4.1 & mehr – verglichen nach Coding-Power und echten Kosten.
Aktualisiert Veröffentlicht 40 Min. Lesezeit
Affiliate-Hinweis
Die Hardware-Links unten sind Affiliate-Links, einschließlich /go/-Weiterleitungen, die auf Amazon landen. Wenn du darüber kaufst, erhalte ich eine kleine Provision – ohne zusätzliche Kosten für dich.
Die besten Open-Source-LLMs messen sich inzwischen bei echter Coding-Arbeit mit Claude Opus 5.5 – zu einem Bruchteil des Flaggschiff-Preises. Vor drei Wochen habe ich diese Rangliste mit Stand 24. September veröffentlicht. Seitdem hat die proprietäre Liga die Preise der offenen Liga kopiert: Claude Sonnet 5.5, GPT-6.1 Sol und Gemini 4 Argon liegen alle bei $2/$10 pro Million Tokens, während Claude Haiku 5.5 und GPT-6 Luna bei $0,10/$0,50 laufen. Das offene Feld antwortete mit Step 5 Preview auf Platz 3 der Open-Weights-Modelle und Xiaomi, das MOPD-Checkpoints liefert, die einen echten agentischen Fehlermodus beheben.
Ich lasse diese Modelle laufend gegen die bezahlte Frontier bei echter Coding-Arbeit antreten. Die Lücke ist kleiner, als die Flaggschiff-Preisschilder vermuten lassen, und das Argument für Open Source ist nicht mehr „günstigerer Listenpreis”. Es sind die Kosten pro nützlichem Agent-Run, herunterladbare Weights, Off-Peak-Abrechnung und keine Rate Limits.
Kostenvergleich im Überblick
Claude Opus 5.5 kostet $4/$20 pro Million Tokens. Sonnet 5.5, GPT-6.1 Sol und Gemini 4 Argon liegen bei $2/$10. Haiku 5.5 und Luna bei $0,10/$0,50. Die offenen Modelle hier reichen von unter einem Cent (DeepSeek-Cache-Hits) bis $3,00 pro Million Input-Tokens. Gegenüber Fable 5.1 und GPT-6 Astra ($10/$50) ist das ein Rückgang um 70–97 %. Gegenüber Opus 5.5 ($4/$20) laufen MiMo, GLM-5.3 und DeepSeek beim Input immer noch 65–93 % günstiger; Kimi K3 mit $3/$15 ist mit etwa 25 % die Ausnahme. Gegenüber Haiku 5.5 und Luna lautet das Open-Argument: Weights, Self-Hosting und Fähigkeiten, nicht Listenpreis.
Aktualisiert am 16. Oktober 2026: Sonnet 5.5, Haiku 5.5, GPT-6.1 Sol, Gemini 4 Argon, Step 5 Preview, MiMo-MOPD-Checkpoints, DeepSeek-API-Umbenennungen.
Wenn du erst noch den Agenten vor dem Modell wählen musst, starte mit unserem Vergleich der besten AI-Coding-Tools und Agents und komm für die Modell-Shortlist hierher zurück. Für Always-on-Assistants, die ein günstiges Modell im Rücken brauchen, sieh dir unsere Open-Source-Grok-Bot-Alternativen an.
Was sich seit unserem September-2026-Update geändert hat
Drei Wochen sind in diesem Markt eine lange Zeit. Sechs Dinge haben sich bewegt:
- Claude Sonnet 5.5 erschien am 28. September: AA Intelligence 56 bei $2/$10. Das ist die neue Value-Bedrohung, nicht Opus.
- Claude Haiku 5.5 erschien am 7. Oktober: $0,10/$0,50 (Batch $0,05/$0,25) bei AA 43. Es unterbietet GLM-5.3-Flash beim Input-Preis und punktet höher.
- GPT-6 Sol wurde am 29. September zu GPT-6.1 Sol: AA 48 auf 52 bei gleichen $2/$10. Ein kostenloses 4-Punkte-Upgrade für alle auf diesem Tier.
- Gemini 4 Argon landete am 30. September: AA 53 bei $2/$10, positioniert für komplexes Software-Engineering und mehrstufige Agents.
- Step 5 Preview (18. September) ist das neue Open-Weights-Modell Nr. 3: AA 44, 600B gesamt / 27B aktiv.
- Xiaomi veröffentlichte am 9. Oktober MiMo-MOPD-Checkpoints: Sie beheben Tool-Call-Wiederholungen, einen Fehlermodus, bei dem der Agent beschäftigt wirkt, aber nichts voranbringt.
Noch eine Korrektur: Fable 5.1 und GPT-6 Astra mit 53 waren früher der höchste veröffentlichte Score auf dem Artificial Analysis Intelligence Index. Nicht mehr. Claude Opus 5.5 (max mit Fallback) steht bei 58.
Warum Open-Source-LLM-Alternativen in Betracht ziehen?
Die Kurzfassung: Das offene Feld hat beim Coding aufgeholt – und das, während es günstig im Betrieb blieb.
- Kosten pro nützlichem Agent-Run: Die meisten Modelle hier laufen bei $0,15–$3 pro Million Input-Tokens, und Cache-Hits plus Off-Peak-Preise senken das noch einmal
- Offene Weights: Jedes Modell auf dieser Liste hat herunterladbare Weights – du kannst selbst hosten, fine-tunen oder eine Version für immer pinnen
- Performance: MiMo-V2.6-Pro (AA 46) und GLM-5.3 (AA 45) schlagen ältere Frontier-Modelle auf mehreren agentischen Coding-Suiten
- Flexibilität: Provider-APIs, OpenRouter oder dein eigener GPU-Cluster
- Notausgang: Weights pinnen, Provider wechseln, wenn eine API hakt, und Rate Limits sowie überraschende Deprecations vermeiden
- Tempo: Step 5 Preview, Muse Spark Open und MiMo MOPD sind alle seit Mitte September gelandet
Was du bewerten solltest
- Coding: Generieren, debuggen und refactoren in einem echten Repo
- Agentische Arbeit: Tool-Calls, lange mehrstufige Runs, ohne bei Schritt 200 den Faden zu verlieren
- Kontextlänge: Wie viel von einer Codebase in einen einzigen Shot passt
- Kosten pro nützlichem Ergebnis: Nicht nur Listenpreis pro Million Tokens
- Verfügbarkeit der Weights: „Offen” reicht inzwischen von MIT über GLMs $10B-Revenue-MaaS-Klausel bis zu den Umsatzbedingungen der StepFun Model License 1.0. Lies das, bevor du shippst.
Die proprietäre Messlatte: Claude Opus 5.5, Sonnet 5.5, GPT-6.1, Gemini 4
Das ist es, was die offenen Modelle jagen – Stand 16. Oktober 2026.
| Modell | AA Intelligence | Preis in/out pro M | Warum es zählt |
|---|---|---|---|
| Claude Opus 5.5 | 58 | $4/$20 | Höchster veröffentlichter AA-Score, 1M Kontext, 128K max Output |
| Claude Sonnet 5.5 | 56 | $2/$10 (Batch $1/$5) | 3 Punkte über Astra zu einem Fünftel des Output-Preises |
| Fable 5.1 / GPT-6 Astra / Gemini 4 Argon | 53 | $10/$50, $10/$50, $2/$10 | Ehemalige Decke; Argon erreicht sie bei $2/$10 |
| Muse Wonder / GPT-6.1 Sol | 52 | TBD, $2/$10 | Metas neues Flaggschiff und das aufgewertete OpenAI-Mid-Tier |
| Haiku 5.5 / GPT-6 Luna | 43 / 38 | $0,10/$0,50 | Das neue Budget-Tier |
Drei Betreiber-Anmerkungen zu dieser Tabelle.
Der Opus-5.5-Migrationsschmerz ist real. Adaptive Thinking ist immer an (die Tiefe wird über den Effort-Parameter gesteuert), erzwungene Tool-Nutzung ist gestrichen, und thinking: disabled liefert jetzt einen 400-Fehler. Wenn dein Agent-Stack auf Opus 5 aufgebaut war, lies die Migrationshinweise, bevor du wechselst.
Breaking Changes in Opus 5.5
thinking: disabled liefert jetzt einen 400, und erzwungene Tool-Nutzung wurde entfernt. Jeder Client, der eines dieser Verhaltensweisen hartkodiert hat, bricht beim ersten Request. Teste gegen die neue API-Form, bevor du Produktionstraffic umstellst.
Sonnet 5.5 ist das Modell, das beim Value mit dem offenen Feld konkurriert. AA 56 bei $2/$10 ist 3 Punkte über GPT-6 Astra und kostet dabei ein Fünftel dessen Output-Preises. Wenn du nur „günstig und schlau” willst und dir Weights egal sind, ist das die proprietäre Antwort.
Das Budget-Tier ist nur ein halber Sieg für Proprietäres. Haiku 5.5 bei $0,10/$0,50 mit AA 43 ist beim Input günstiger als GLM-5.3-Flash ($0,15) und punktet höher (43 vs. 42). Aber GPT-6 Luna mit AA 38 liegt unter GLM-5.3-Flash (42), DeepSeek V4.1-Flash (39) und Kimi K3 (44) – zum gleichen Preis. „Proprietär ist jetzt am günstigsten” stimmt also für Haiku und ist für Luna größtenteils falsch.
Ebenfalls im Hinterkopf behalten: Requests der GPT-6-Familie über 272K Input-Tokens werden auf Astra-Niveau mit $20/$75 umgepreist. Langer Kontext ist nirgends umsonst.
1. MiMo-V2.6-Pro: Der neue Open-Weights-Anführer
MiMo-V2.6-Pro ist Xiaomis Flaggschiff vom 22. September und aktuell das Top-Open-Weights-Modell auf dem Artificial Analysis Intelligence Index mit 46 – vor GLM-5.3 (45) und dem Paar Step 5 Preview / Kimi K3 bei 44. Das platziert es über Grok 4.6 und Gemini 3.8 Flash, gleichauf mit Grok 4.7 und etwa zwölf Punkte hinter Opus 5.5s 58. Es ist ein 1.02T Sparse MoE mit 42B aktiv pro Token, MIT-lizenziert und nativ omnimodal: Text, Bild, Video und Audio als Input.
Zwei Details, die ich vom KI-Labor eines Handy-Herstellers nicht erwartet hatte: Sie haben die RL-Trainingsrechnung veröffentlicht (etwa $2,62M für Pro, 30 Steps in unter sechs Tagen und rund 750K Trajectories), und der API-Preis blieb gegenüber V2.5 unverändert bei $0,435/M Input und $0,87/M Output.
Technische Daten
| Feature | MiMo-V2.6-Pro |
|---|---|
| Parameter gesamt | 1.02T (Sparse MoE, 384 Experten / 8 aktiv) |
| Aktive Parameter | 42B |
| Kontextlänge | 1M Tokens |
| Architektur | Hybrid SWA/GA MoE + 5-Layer-MTP-Decoder |
| Multimodal | Text-, Bild-, Video-, Audio-Input |
| AA Intelligence | 46 (#1 Open Weights) |
| DeepSWE v1.1 | 71.9 |
| Terminal-Bench 2.1 | 89.9% (Vendor-Run) |
| Input-Kosten | $0.435/M Tokens |
| Output-Kosten | $0.87/M Tokens |
| Lizenz | MIT |
Was heraussticht
- AA Intelligence 46: Höchster Open-Weights-Score – und es ist AAs eigener Harness, der die Zahl produziert, nicht Xiaomis Marketing-Seite
- DeepSWE 71.9: Über Claude Fable 5s 70.0 auf derselben Suite, nah an GPT-5.6 Sols 73.0
- Terminal-Bench 2.1 mit 89.9%: Vendor-Run und zum Release-Zeitpunkt nahe der Spitze der veröffentlichten Scores. Prüfe das Live-Leaderboard, bevor du es als „stärkstes” zitierst
- AutomationBench 53.1 und Agents’ Last Exam 31.6: Schlägt oder erreicht Claude Opus 5s veröffentlichte Zahlen bei beiden
- Omnimodaler Input: Das einzige Modell hier, das nativ Audio verarbeitet, dazu Bild und Video
- ~134 tok/s Output: Schnell für ein Billionen-Parameter-Modell, unterstützt durch den MTP-Speculative-Decoder
- Günstige Geschwister: MiMo-V2.6-Flash (310B/15B aktiv) bei $0,14/$0,28 und eine Pro-UltraSpeed-Variante bei $4,35/$8,70, wenn du grob 20-fache Generierungsgeschwindigkeit willst
Die MOPD-Checkpoints: Nimm diese, nicht das Original-Release
Am 9. Oktober veröffentlichte Xiaomi MiMo-V2.6-Pro-MOPD und MiMo-V2.6-Flash-MOPD unter MIT, plus die rohen RL-Stage-Checkpoints (MiMo-V2.6-Pro-RL, MiMo-V2.6-Flash-RL) und einen 52-seitigen Technical Report (Abschnitt 5.6 behandelt MOPD2). Das MOPD-Upgrade existiert, um genau einen Fehlermodus zu beheben: Tool-Call-Wiederholungen.
Xiaomi beschreibt es in ihrer Tool-Call-Repetition-Diagnose ganz klar: Das Modell „feuert immer wieder dieselben oder sehr ähnliche Tool Calls ab, wirkt beschäftigt und macht keinen Fortschritt”, und das Muster „bleibt leicht unbemerkt”. Dieser zweite Teil ist das Betreiber-Problem. Ein festsitzender Agent, der produktiv aussieht, verbrennt Tokens und Stunden.
Achte auf Tool-Call-Wiederholungen
Wenn ein Agent-Run einen Strom fast identischer Tool Calls produziert, ohne Dateiänderungen oder Fortschritt beim Output, steckst du in dieser Schleife. Kurzfristig: Run killen, Loop-Detection oder ein Max-Identical-Call-Limit in deinen Harness einbauen. Struktureller Fix: das MOPD-Checkpoint servieren statt des ursprünglichen September-Releases. Diagnose-Details stehen im oben verlinkten Xiaomi-Blogpost.
Für Self-Hoster ist die Checkliste einfach: Lade MiMo-V2.6-Pro-MOPD (oder Flash-MOPD), nicht den Original-Tag. Wenn deine Box klein ist, ist MiMo-V2.6-Distill-Qwen-9B (22. September, MIT) die realistische Option, und du kannst lokale Modelle mit Ollama in Docker laufen lassen, um den Serving-Stack einzudämmen.
Wann du es nutzen solltest
- Allgemeine Agent-Arbeit: Höchster offener Score auf AAs agent-lastigem Index
- Lange Coding-Sessions: 1M Kontext mit starken DeepSWE- und Terminal-Bench-Zahlen
- Multimodale Pipelines: Screenshots, Video-Frames, Audio-Notizen in einem Modell
- Überspringen, wenn: du einen kleinen Self-Host-Fußabdruck brauchst. 1.02T erfordert selbst quantisiert einen Multi-GPU-Node; MiMo-V2.6-Flash (310B) oder das 9B-Distill ist die realistischere Homelab-Option
MiMo-Bonus
Melde dich über go.bitdoze.com/mimo an und erhalte ein $2-Bonusguthaben. Xiaomi hat außerdem parallel zu V2.6 einen MiMo-Desktop-Client und Membership-Pläne gestartet, falls du ein Flat-Abo der Per-Token-Abrechnung vorziehst. Bonus-Bedingungen ändern sich; die Landingpage zeigt, was heute live ist.
2. GLM-5.3: Das offene Coding-Arbeitstier
GLM-5.3 startete am 14. August über den GLM Coding Plan, offene Weights folgten am 28. August. Dieselbe 744B-A40B-Basis wie GLM-5.2; jeder Gewinn kommt aus dem Post-Training. Die Zahlen zeigen, wie weit das trägt: Terminal-Bench 3.0 sprang von 4.6 auf 28.3, DeepSWE von 46.2 auf 66.9, und Z.ai meldet eine 50%-Verbesserung auf seinem hausinternen Code-Bench. Z.ai nennt es das fähigste Open-Weights-Coding-Modell, und es hält AA Intelligence 45 – Platz zwei unter den offenen Modellen.
Ein Vorbehalt: GLM-5.3s Post-Training-Run brachte auch einen großen Sprung bei Cyber-Fähigkeiten. Z.ai ist offen damit (CyberGym 84.5, State of the Art; Exploitation-Benchmarks mehr als verdoppelt gegenüber 5.2). Nützlich für Security-Forschung – und ein Grund, Agent-Berechtigungen ohnehin eng zu halten.
Technische Daten
| Feature | GLM-5.3 |
|---|---|
| Parameter | 744B gesamt / 40B aktiv |
| Kontextlänge | 1M Tokens |
| Max Output | 128K Tokens |
| Modalität | Nur Text |
| Terminal-Bench 2.1 | 88.2% |
| Terminal-Bench 3.0 | 28.3 (Open SOTA) |
| DeepSWE v1.1 | 66.9 |
| Input-Kosten | $1.40/M Tokens ($0.26 cached) |
| Output-Kosten | $4.40/M Tokens |
| Lizenz | GLM-5.3 License (MIT-artig, mit einer $10B-Revenue-MaaS-Klausel) |
Die Z.ai-Speed-Leiter
Seit Mitte September liefert Z.ai vier Throughput-Stufen aus derselben Modellfamilie. Gut zu wissen, bevor du einen Endpoint wählst:
- GLM-5.3-Flash ($0.15/$0.50): das Budget-Tier, weiter unten behandelt
- GLM-5.3-FlashX (18. September, $0.37/$1.25, Cache $0.09): bis zu ~200 tok/s
- GLM-5.3 ($1.40/$4.40): der Weights-gestützte Daily Driver
- GLM-5.3-Prime (23. September, $2.80/$8.80, Cache $0.56): 1,5–2x Throughput, nur Text
FlashX und Prime sind API-only. Ich habe für keines der beiden Weights auf Hugging Face gefunden, Stand 16. Oktober. Wenn du herunterladbare Weights brauchst, bleiben Flash oder das volle GLM-5.3.
Stärken
- Terminal-Bench 3.0 mit 28.3: Open SOTA, hoch von GLM-5.2s 4.6; Fable 5 bekommt 33.7 und GPT-5.6 Sol 34.6 – also nah an der Frontier auf dem härteren Bench
- FrontierSWE 78.1: Bester offener Score auf dieser Suite in der Release-Tabelle
- 1M Kontext, 128K Output: Dieselbe Hüllkurve wie die proprietären Flaggschiffe
- Drei API-Protokolle: OpenAI Chat Completions, OpenAI Responses und Anthropic Messages – Claude-Code-artiges Tooling funktioniert direkt
- Gleicher Preis wie 5.2: $1.40/$4.40 unverändert trotz des Fähigkeitssprungs
GLM-Preisanomalie: verifizieren, bevor du budgetierst
OpenRouter listet z-ai/glm-5.3 aktuell bei $0.079 Input / $4.80 Output und z-ai/glm-5.3-flash bei $0.031/$0.61. Diese Input-Raten liegen weit unter Z.ais eigenen Listenpreisen in den Tabellen oben. Entweder hat Z.ai die Listenpreise gesenkt, es läuft eine Promo, oder der Router rechnet ein günstigeres Kontext-Tier ab. Die Tabellen in diesem Artikel nutzen Z.ais direkte Listenpreise. Prüfe z.ai direkt, bevor du mit den OpenRouter-Raten planst.
GLM Coding Plans
GLM Coding Plans laufen auf einer punktebasierten Quote. Off-Peak-Calls – einschließlich des ganzen Wochenendes – verbrauchen die Hälfte der Standard-Punkte. GLM-5.3 ist in allen Plan-Stufen verfügbar.
Beste Anwendungsfälle
- Daily-Driver-Coding-Agent: Stärkstes Allround-Open-Coding-Profil
- Langfristige Terminal-Arbeit: TB-3.0-Gewinne deuten darauf hin, dass es standhält, wo andere Modelle auseinanderfallen
- Claude-Code-artige Stacks: Nativer Anthropic-Messages-Endpoint
- Self-Hosting im großen Stil: FP8- und BF16-Weights auf Hugging Face und ModelScope – aber 744B ist Cluster-Territorium
3. DeepSeek-V4.1-Flash: Der Effizienz-König
DeepSeek-V4.1-Flash erschien am 10. September unter MIT und ist die interessanteste Architektur auf dieser Liste. Es nutzt ein Causal-Encoder-Decoder-Design: 552B Parameter gesamt, aber nur 8B aktiv beim Lesen deines Inputs und 16B beim Generieren des Outputs. Kombiniert mit FP4-KV-Caching liegt der arbeitende KV-Cache bei etwa 890 Bytes pro Token – grob ein Viertel des Vorgängers. Klartext: Es ist gebaut, um Millionen-Token-Agent-Loops günstig zu servieren.
Die Vendor-gemeldeten Zahlen sind aggressiv: Terminal-Bench 2.1 bei 90.6% und DeepSWE 74.2, über Fable 5s 70.0 und GPT-5.6 Sols 73.0. Behandle sie als DeepSeeks eigene Runs, bis mehr Dritt-Verifizierung landet, und prüfe das Live-Leaderboard, bevor du sie als Rekorde zitierst. Der seltsame Teil: Artificial Analysis scored es mit 39 auf dem Intelligence Index – weit unter seinen Coding-Ergebnissen –, weil dieser Index Breite belohnt und V4.1-Flash ein Spezialist ist.
Technische Daten
| Feature | DeepSeek-V4.1-Flash |
|---|---|
| Parameter | 552B MoE |
| Aktive Parameter | 8B beim Input / 16B beim Output |
| Kontextlänge | 1M Tokens |
| Max Output | 384K Tokens |
| Modalität | Text- + Bild-Input |
| Terminal-Bench 2.1 | 90.6% (Vendor-Run) |
| DeepSWE v1.1 | 74.2 (Vendor-Run) |
| Terminal-Bench 3.0 / 4.0 | 30.0 / 31.2 |
| Input-Kosten | $0.30/M Peak, $0.15/M Off-Peak |
| Output-Kosten | $1.20/M Peak, $0.60/M Off-Peak |
| Cache-Hit | $0.006/M Peak, $0.003/M Off-Peak |
| Lizenz | MIT |
Preise und Konditionen am 16. Oktober 2026 unverändert gegen die DeepSeek-API-Docs verifiziert. Peak-Fenster sind 01:00–04:00 und 06:00–10:00 UTC an Wochentagen.
Was es gut kann
- 8B-aktives Prefill: Input-lastige Agent-Workloads (Repo-Dumps, Tool-Outputs, lange Prompts) kosten einen Bruchteil von Dense-Reads
- Vendor-gemeldete 90.6% Terminal-Bench 2.1 und 74.2 DeepSWE: Vor den veröffentlichten Fable-5- und GPT-5.6-Sol-Zahlen auf denselben Suiten – wenn die Runs sich bewähren
- Halber Preis Off-Peak – und Wochenenden zählen: Alles außerhalb der zwei Wochentags-Peak-Fenster wird zu 50 % abgerechnet, inklusive kompletter Wochenenden und chinesischer Feiertage. Bündele deine Evals und Nightly-Runs entsprechend
- 384K Max Output: Größtes Output-Budget hier, nützlich für lange Datei-Generierung
- MIT-Weights ab Tag eins: Echtes Open Release mit 51-seitigem Tech Report
Plattform-Hinweise, die du kennen solltest
- Aktuelle API-Modellnamen sind
deepseek-flashunddeepseek-v4-pro. Die alten Namendeepseek-v4-flashunddeepseek-v4-flash-vision-expsind eingestellt, werden aber noch akzeptiert – zum Flash-Preis abgerechnet. Update deine Configs trotzdem. - Anthropic-formatierte Base URL:
https://api.deepseek.com/anthropic. Richte Claude-Code-kompatible Clients darauf und der Rest des Toolings funktioniert. Derselbe Trick gilt in unserem Codex-App-mit-beliebigem-Modell-Guide. - Concurrency-Limits: 2500 für Flash vs. 500 für Pro. Dimensioniere Agent-Flotten entsprechend.
- Search- und Fetch-APIs kosten $0.75 pro 1.000 erfolgreiche Requests, und DeepSeek Harness ist in Developer Preview für Agent-Harness-Bauer.
Wann du es nutzen solltest
- Always-on-Agents mit Budget: $0.30/$1.20 Peak, die Hälfte Off-Peak
- Terminal- und Repo-Level-Coding: Wo sein Benchmark-Profil am stärksten ist
- Self-Host-Experimente: MIT-Weights plus die cache-effizienteste Serving-Story hier
- Überspringen, wenn: du breite Allgemeinwissens-Arbeit brauchst; sein AA-Index zeigt die Trade-offs der Spezialisierung. Ein V4.1-Pro für das kommt noch.
4. GLM-5.3-Flash: Das Value-Monster
GLM-5.3-Flash erschien am 26. August unter MIT und hat das Budget-Tier still umgekrempelt. 320B gesamt, 18B aktiv, mit einem Hybrid-Attention-Stack, der 34 KDA-Linear-Attention-Layer mit 11 Sparse-Attention-Layern im 3:1-Muster verschachtelt. Das senkt Attention-Compute grob um das 3-Fache und den KV-Cache grob um das 4,4-Fache gegenüber GLM-5.3. Es ist außerdem das erste nativ multimodale GLM-5-Modell, mit Bild- und Video-Input.
Die Pointe ist der Preis: $0.15/M Input und $0.50/M Output, $0.03 cached. Es erreicht 84.3% auf Terminal-Bench 2.1, 63.4 auf DeepSWE und hält AA Intelligence 42. Amüsantes Detail: Vor dem Launch kursierte es auf OpenRouter und OpenCode als anonymes „Ox Alpha”-Modell, das alle zu identifizieren versuchten.
Technische Daten
| Feature | GLM-5.3-Flash |
|---|---|
| Parameter | 320B gesamt / 18B aktiv |
| Kontextlänge | 1M Tokens |
| Architektur | Hybrid KDA Linear + Sparse Attention |
| Multimodal | Text-, Bild-, Video-Input |
| AA Intelligence | 42 |
| Terminal-Bench 2.1 | 84.3% |
| DeepSWE v1.1 | 63.4 |
| Input-Kosten | $0.15/M Tokens ($0.03 cached) |
| Output-Kosten | $0.50/M Tokens |
| Lizenz | MIT |
Haiku 5.5 hat die Budget-Rechnung geändert
Claude Haiku 5.5 erschien am 7. Oktober bei $0,10/$0,50 mit AA 43. Gegenüber GLM-5.3-Flash (AA 42, $0,15/$0,50) ist das günstigerer Input und ein höherer Index-Score auf dem Papier. Das ehrliche Open-Argument lautet jetzt: MIT-Weights, ein 320B-Modell, das auf einen Multi-GPU-Node passt, $0,03-Cache-Hits, Bild- plus Video-Input und kein Vendor-Lock-in. Wenn du nichts davon brauchst, ist Haiku heute der einfachere Kauf.
Was es gut kann
- $0.15/$0.50-Preis: Günstigstes offenes Modell auf dieser Liste zum Listenpreis – und es schlägt GLM-5.2 (das ~9x mehr kostete) auf jedem gemeldeten Bench
- AA Intelligence 42: Innerhalb von vier Punkten vom Flaggschiff GLM-5.3
- Native Multimodalität: Bild- und Video-Input zu Budget-Raten
- 320B/18B-Profil: Das praktischste Self-Host-Ziel unter den großen Releases; FP8-Weights passen auf einen einzelnen Multi-GPU-Node
- Einziger Budget-Pick mit herunterladbaren Weights bei diesem Score: Haiku 5.5 hat keine
- GDPval-AA 1773 Elo: Starker Real-Work-Score für Office-artige Aufgaben
Beste Anwendungsfälle
- Default-Modell für alles Günstige: Immer noch mein Budget-Pick für offene Weights; M3 hat seinen Platz über den MiniMax Token Plan, wenn du ein Flat-Abo statt Per-Token-Abrechnung willst
- Self-gehosteter Coding-Stack: MIT-Lizenz, vLLM-/SGLang-Support, ein Node statt eines Clusters
- Multimodal mit Budget: Screenshot-to-Code und Video-Verständnis ohne K3-Preise
- Hochfrequente Agent-Loops: Cache-Hits bei $0.03/M machen warme Sessions fast umsonst
- Mehr Speed nötig? GLM-5.3-FlashX läuft bis zu ~200 tok/s bei $0.37/$1.25 (API-only)
5. Kimi K3: Immer noch die größten offenen Weights
Kimi K3 ist nicht mehr in den Top drei auf dem AA-Index. AA Intelligence 44 bedeutet jetzt Gleichstand mit Step 5 Preview – effektiv Platz vier in AAs Sortierung: MiMo-V2.6-Pro 46, GLM-5.3 45, Step 5 Preview 44, K3 44. Was sich nicht geändert hat: Mit 2.8T Parametern bleibt es das größte Open Release, und seine Coding-Zahlen halten sich. Terminal-Bench 2.1 bei 88.3%, DeepSWE 67.5, SWE-Marathon 42.0, FrontierSWE 81.2 und BrowseComp 91.2 für Web-Research-Agents.
Seit dem 18. September ist es außerdem allgemein auf Amazon Bedrock verfügbar – relevant, wenn deine Organisation die Weights-Modell-Story innerhalb einer AWS-Security-Boundary mit Prompt-Caching will. Das ist eine September-Behauptung, die ich in dieser Runde nicht erneut verifizieren konnte; prüfe die Bedrock-Docs, falls sie für dich tragend ist.
Der Preis-Vorbehalt aus der Originalversion dieses Guides gilt weiterhin: $3/M Input und $15/M Output ist Frontier-nahes Geld. Cache-Hits bei $0.30/M sind es, die es in warmen Coding-Loops vernünftig halten. Wenn deine Cache-Hit-Rate schlecht ist, macht MiMo-V2.6-Pro vergleichbare Arbeit für ein Siebtel des Output-Preises. Und wenn du über OpenRouter routest statt direkt, rechnet moonshotai/kimi-k3 Stand 16. Oktober etwa $0.304 Input / $12.53 Output / $0.21 Cache ab – grob 17 % weniger beim Output als die Direkt-Rate.
Technische Daten
| Feature | Specification |
|---|---|
| Parameter gesamt | 2.8T (MoE, 16 von 896 Experten) |
| Aktive Parameter | ~104B |
| Kontextlänge | 1M Tokens |
| Architektur | MoE + Kimi Delta Attention |
| Multimodal | Text-, Bild-, Video-Input |
| AA Intelligence | 44 (gleichauf #3 Open Weights) |
| Terminal-Bench 2.1 | 88.3% |
| BrowseComp | 91.2 |
| Input-Kosten | $0.30/M Cache-Hit / $3.00/M frisch |
| Output-Kosten | $15.00/M |
| Lizenz | Kimi K3 License (Open Weights) |
Was heraussticht
- 2.8T offene Weights: Nichts anderes Herunterladbares ist so groß; Self-Hosting bedeutet einen echten Cluster, nicht einen Mini-PC
- FrontierSWE 81.2: Bester Score auf dieser Suite in seiner Release-Tabelle
- BrowseComp 91.2: Immer noch der Pick für Web-Research-Agents
- Bedrock-GA-Pfad: Open-Weight-Modell mit explizitem Prompt-Caching innerhalb einer AWS-Security-Boundary
- 1M Kontext + multimodal: Bild und Video in denselben langen Sessions
Wann du es nutzen solltest
- Hartes Coding und Agent-Marathons: FrontierSWE- und SWE-Marathon-Führung unter offenen Modellen
- Web-lastige Research-Agents: BrowseComp 91.2
- AWS-Shops: Bedrock mit Caching seit dem 18. September
- Überspringen, wenn du preissensibel bist: $15/M Output ist hier mit Abstand der höchste
6. Qwen3.8-Max und die offenen 2.4T-Weights
Alibaba fährt Qwen 3.8 als zwei Produkte unter einem Namen. Qwen3.8-Max ist die gehostete API bei $2/$6 pro Million Tokens, live seit dem 3. August und am 2. September als Qwen3.8-Max-0902 erneuert. Dieser Snapshot debütierte auf Platz 1 von Arenas Code Arena WebDev Leaderboard mit 1.691 Punkten – 3 Punkte vor Claude Opus 5 und 17 vor Kimi K3. Seine Terminal-Bench-3.0- und ProgramBench-Scores verdoppelten sich mehr als gegenüber dem Launch-Build. Wenn deine Arbeit Frontend und „Vibe Coding” ist, ist das aktuell die stärkste Option im offenen Ökosystem.
Die herunterladbare Hälfte ist Qwen3.8-2.4T-A95B, released am 12. August: 2.4T Parameter, 95B aktiv, hybride Linear-plus-Full-Attention, 262K nativer Kontext erweiterbar auf 1M, unter einer Custom-Qwen-Lizenz. Community-MXFP4/NVFP4-Quants drücken es auf etwa 1.2TB – das passt auf einen einzelnen 8-GPU-B300-Node. Ein Haken: Das September-0902-Post-Training ist bisher API-only, die Weights hinken also dem gehosteten Modell hinterher. Bestätigt am 16. Oktober: Die Qwen-Org zeigt keine neuen 3.8-Weights seit August (nur Qwen3Guard-Stream-Safety-Modelle und Qwen-Image-2.1).
Technische Daten
| Feature | Qwen3.8-Max / Qwen3.8-2.4T-A95B |
|---|---|
| Parameter | 2.4T gesamt / 95B aktiv |
| Kontextlänge | 1M API / 262K nativ auf Weights |
| Code Arena WebDev | 1691 (#1, 0902-Snapshot) |
| AA Intelligence | 45 (0902 API) / ~40 (Open Weights) |
| Terminal-Bench 2.1 | 86.6% Vendor / 88.8% unabhängig (AA) |
| Input-Kosten | $2.00/M Tokens ($0.25 Cache-Read) |
| Output-Kosten | $6.00/M Tokens |
| Lizenz | Custom Qwen License (Open Weights) |
Diese AA-Spaltung ist wichtig. Das API-Modell, das du heute aufrufen kannst, scored 45 und überflügelt damit GLM-5.3. Die Weights, die du herunterladen kannst, scoren immer noch um die 40. Wenn dein Eval „Qwen3.8-Max” sagt, stelle sicher, dass du weißt, welches davon gelaufen ist.
Was es bietet
- #1 Code Arena WebDev: Erstes chinesisches Modell an der Spitze dieses Leaderboards; fairerweise misst es hauptsächlich One-Shot-UI-Generierung
- Offene Weights auf Max-Niveau: Erstes Qwen-Max-Release mit herunterladbaren Weights
- $2/$6 API-Preis: Grob ein Fünftel von Fable 5.1s Output-Rate
- 1M-Kontext-API: Mit implizitem Prefix-Caching bei $0.25/M
- Kleinere Geschwister: Qwen3.8-27B und Qwen3.8-Flash-Next, falls 2.4T zu viel Eisen ist. Es gibt auch ein Qwen3.8-Max-Prime-Throughput-SKU bei $4/$12 (23. September)
Wann du es nutzen solltest
- Frontend und Design-to-Code: Die WebDev-Arena-Führung ist das ganze Argument
- API-Komfort plus Weights-Ausstieg: Auf QwenCloud starten, die Option zum Selbst-Hosten des 2.4T behalten
- Self-Host auf Frontier-Niveau: Wenn du den Node dafür hast, ist das das zweitgrößte offene Modell nach K3
- Überspringen, wenn: du die September-Verbesserungen heute on-prem brauchst; das 0902-Checkpoint ist vorerst hosted-only
Begleitende Berichterstattung zu den kleineren Qwen-Modellen und wie sie sich in Coding-Agents verhalten, findest du in unserem Guide zu Qwen-Modellen für AI-Coding-Agents.
7. Step 5 Preview: Das neue Open-Modell Nr. 3
StepFun hat Step 5 Preview am 18. September veröffentlicht, und es ging weitgehend unbemerkt durch, bis der AA-Index aufholte. Es ist ein 600B-gesamt-/27B-aktiv-MoE mit 1M Kontext, und AA Intelligence 44 platziert es auf Platz 3 der Open-Weights-Modelle in AAs eigener Sortierung – ein Haar vor Kimi K3. Bei Aktiv-Parameter-Effizienz ist das der beste Deal in den offenen Top fünf: 27B aktiv ist ein Drittel von MiMos 42B.
Weights liegen auf Hugging Face als stepfun-ai/Step-5-Preview, mit offiziellen BF16- und NVFP4-Varianten plus Community-GGUF- und MLX-Quants. Downloads sind noch niedrig (hunderte bis niedrige tausende) – behandle das also als früh.
Technische Daten
| Feature | Step 5 Preview |
|---|---|
| Parameter | 600B gesamt / 27B aktiv (MoE) |
| Kontextlänge | 1M Tokens |
| Modalität | Text (prüfe die Model Card für multimodalen Support) |
| AA Intelligence | 44 (#3 Open Weights) |
| Weights | BF16, NVFP4, Community-GGUF/MLX |
| Input-/Output-Kosten | TBD, prüfe StepFuns Plattform |
| Lizenz | StepFun Model License 1.0 (custom) |
Preview-Checkpoint und Custom-Lizenz
Zwei Gründe, das noch nicht zum Produktions-Default zu machen. Erstens heißt es wörtlich Preview, die Download-Zahlen sind niedrig, und API-Preise sind Stand 16. Oktober nicht bestätigt. Zweitens ist die StepFun Model License 1.0 custom mit Umsatzbedingungen. Lies die Lizenz vor kommerzieller Nutzung, genauso wie du es mit GLMs MaaS-Klausel tun würdest. Beobachte dieses Modell: Wenn StepFun es unter K3s $3/$15 preist, wird es das Default-Open-Modell für harte Aufgaben.
Open-Source-LLMs vs. Claude Opus 5.5 und GPT-6.1: der direkte Vergleich
Zahlen Stand 16. Oktober 2026. „n/a” heißt nicht veröffentlicht oder auf dieser exakten Suite nicht vergleichbar. DeepSWE- und Terminal-Bench-Spalten mischen Vendor- und Dritt-Runs; Zahlen aus einer Quelle bekommen weniger Vertrauen. Lies die Tabelle so: Auf dem $2/$10-Tier ist das Argument Fähigkeit pro Dollar, auf dem $0,10/$0,50-Tier sind es Weights und Self-Hosting.
| Modell | AA | DeepSWE v1.1 | TB 2.1 | Kontext | Open Weights | In $/M | Out $/M |
|---|---|---|---|---|---|---|---|
| Claude Opus 5.5 | 58 | 74.0* | n/a | 1M | Nein | $4.00 | $20.00 |
| Claude Sonnet 5.5 | 56 | n/a | n/a | 1M | Nein | $2.00 | $10.00 |
| Claude Fable 5.1 | 53 | 70.0 | n/a | 1M | Nein | $10.00 | $50.00 |
| GPT-6 Astra | 53 | n/a | n/a | 1.05M | Nein | $10.00 | $50.00 |
| Gemini 4 Argon | 53 | n/a | n/a | 1M | Nein | $2.00 | $10.00 |
| Muse Wonder | 52 | n/a | n/a | 1M | Nein | TBD | TBD |
| GPT-6.1 Sol | 52 | n/a | n/a | 1.05M | Nein | $2.00 | $10.00 |
| MiMo-V2.6-Pro | 46 | 71.9 | 89.9% | 1M | MIT | $0.435 | $0.87 |
| GLM-5.3 | 45 | 66.9 | 88.2% | 1M | GLM-Liz. | $1.40 | $4.40 |
| Qwen3.8-Max | 45 (API) / ~40 (Wts)† | 56.6 | 86.6% | 1M API / 262K Wts | Custom | $2.00 | $6.00 |
| Step 5 Preview | 44 | n/a | n/a | 1M | StepFun-Liz. | TBD | TBD |
| Kimi K3 | 44 | 67.5 | 88.3% | 1M | Kimi-Liz. | $3.00 | $15.00 |
| Claude Haiku 5.5 | 43 | n/a | n/a | 1M | Nein | $0.10 | $0.50 |
| GLM-5.3-Flash | 42 | 63.4 | 84.3% | 1M | MIT | $0.15 | $0.50 |
| DeepSeek V4.1 Flash | 39 | 74.2 | 90.6% | 1M | MIT | $0.15-0.30 | $0.60-1.20 |
| Muse Spark Open | 39 | n/a | n/a | 1M | Muse-Liz. | TBD | TBD |
| GPT-6 Luna | 38 | n/a | n/a | 1M | Nein | $0.10 | $0.50 |
| MiniMax M3 | 29 | n/a | n/a | n/a | n/a | $0.30 | $1.20 |
*Opus-5-Zahl, wo Opus 5.5 keinen veröffentlichten DeepSWE-Run hat; Anthropic stuft 5.5 grob auf Fable-5.1-Niveau ein. †AA scored den 0902-API-Snapshot mit 45 und die offenen 2.4T-A95B-Weights mit etwa 40. Gezeigte Kimi-K3-Preise sind Direkt-Liste; OpenRouter rechnet $0.304/$12.53 ab. MiniMax M3 ist die OpenRouter-Listung, siehe die Preis-Fußnoten unten. DeepSeek-Input ist $0.30 Peak / $0.15 Off-Peak.
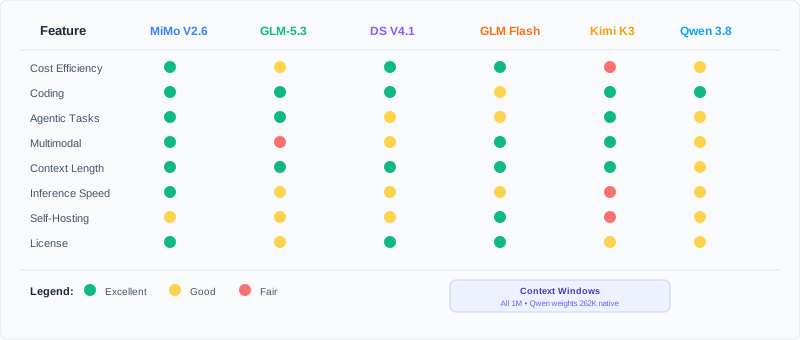
Wie du diese Open-Source-LLMs nutzt (OpenRouter, Direkt-API oder self-hosted)
Schritt 1: Wähle deinen Zugangsweg
OpenRouter
Ein API-Key für jedes Modell in diesem Artikel, einschließlich der proprietären Zeilen, gegen die du vergleichen willst. Am besten für Evaluation und gemischte Flotten. Zahle pro Token, keine Bindung. Wenn du diese Woche fünf Modelle vergleichst, mach es zuerst hier.
Direkt-API
Bessere Rate Limits, Plan-Preise und Off-Peak-Fenster (Z.ai, DeepSeek, Xiaomi MiMo, Qwen und Kimi haben alle eigene Endpoints). Wähle das, sobald du weißt, welche ein oder zwei Modelle deinen Workload tragen. DeepSeek exponiert auch einen Anthropic-formatierten Endpoint für Claude-Code-artige Clients.
Self-hosted
GLM-5.3-Flash (320B) ist die realistische Single-Node-Option. MiMo-MOPD-Checkpoints und das 9B-Distill sind die anderen praktischen Ziele. K3, Qwen 2.4T und Step 5 Preview wollen echte Cluster. Self-Hosting gewinnt bei Datenlokalität und dauerhaftem Volumen, nicht bei deiner ersten Monatsrechnung.
- OpenRouter: Ein Key, jedes Modell auf dieser Liste, schnellster Weg zum Vergleichen
- Direkte Provider-APIs: Bessere Rate Limits und Plan-Preise (Z.ai, DeepSeek, Xiaomi MiMo, Qwen, Kimi)
- Flat-Rate-Agent-Zugang: Das OpenCode-Go-Review (31 KI-Modelle für $10/Monat) behandelt ein Flat-Abo, das mehrere Modelle aus dieser Liste enthält, über einen OpenCode-Go-Coding-Agent
- Ein Key für deine CLI-Tools: Agent Router (Claude Code, Codex, Gemini CLI hinter einem Key), wenn du mehrere Coding-CLIs fährst und keine per-Provider-Config willst
- Self-Hosting: GLM-5.3-Flash (320B) ist die realistische Single-Node-Option; K3 und Qwen 2.4T wollen einen Cluster. Siehe die Self-Hosting-Hinweise unten
- Gateway-Routing: Ein LLM-Gateway mit LiteLLM self-hosten, wenn du einen OpenAI-kompatiblen Endpoint vor alle Provider willst
- Agent-Tools: OpenCode, Claude-Code-kompatible Endpoints, Hermes, Codex-Beliebiges-Modell-Configs. Für die Box darunter reicht ein VPS-Setup für AI-Coding-Agents, um alles außer self-gehosteten Weights laufen zu lassen. Ein günstiger Hetzner-VPS ist mein Default, wenn der Workload API-only ist
Schritt 2: Umgebung (OpenRouter-Beispiel)
# Install OpenAI SDK
pip install openai

# Set environment variables
export OPENROUTER_API_KEY="your_api_key_here"
export OPENROUTER_BASE_URL="https://openrouter.ai/api/v1"
Verifiziere den Key, bevor du irgendeinen Code schreibst:
curl -s https://openrouter.ai/api/v1/models \
  -H "Authorization: Bearer $OPENROUTER_API_KEY" | head
Du willst JSON zurückbekommen. Wenn du eine HTML-Fehlerseite oder 401 bekommst, fixe zuerst den Key oder den Netzwerkpfad.
Schritt 3: Erster Call, zwei Modelle nebeneinander
import openai

client = openai.OpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key="your_openrouter_api_key"
)

def ask(model: str, prompt: str) -> str:
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}]
    )
    usage = response.usage
    print(f"{model}: {usage.prompt_tokens} in / {usage.completion_tokens} out")
    return response.choices[0].message.content

prompt = "Create a Python web scraper for product prices"

# The open coding workhorse vs the new proprietary budget tier
print(ask("z-ai/glm-5.3", prompt))
print(ask("anthropic/claude-haiku-5.5", prompt))
Derselbe Call in curl, wenn du nur die Form der Antwort sehen willst:
curl https://openrouter.ai/api/v1/chat/completions \
  -H "Authorization: Bearer $OPENROUTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"z-ai/glm-5.3","messages":[{"role":"user","content":"Create a Python web scraper for product prices"}]}'
Hinweis zu DeepSeek: Der aktuelle API-Modellname ist deepseek-flash (serviert V4.1-Flash), und wenn du das Anthropic-Messages-Format willst, ist die Base URL https://api.deepseek.com/anthropic. Alte Namen wie deepseek-v4-flash resolven noch, werden zum Flash-Preis abgerechnet – aber baue keine neuen Configs darauf.
Schritt 4: Kontext zur Aufgabe passen
Kontextlänge
Jedes Modell hier wirbt mit einem 1M-Token-Fenster, aber langer Kontext ist nicht umsonst: Provider verlangen mehr über Schwellen hinaus (GPT-6 preist über 272K Input um), und Qwens offene Weights schaffen nativ nur 262K vor Erweiterung. Für günstige Long-Context-Optionen sieh unseren Guide zu den besten günstigen Modellen für Hermes Agent.
Schritt 5: Verifiziere, dass es funktioniert
Drei Checks, die fünf Minuten dauern und einen Nachmittag retten:
- Die Antwort hat Inhalt und
response.modelstimmt mit dem Angefragten überein. Provider tauschen Modelle öfter still aus, als sie zugeben. - Logge den Usage-Block und preise eine echte Aufgabe. Multipliziere
prompt_tokensundcompletion_tokensmit den Listenraten. Vergleiche das mit derselben Aufgabe auf Haiku 5.5 oder Opus 5.5. Deine Kosten pro nützlichem Ergebnis sind die Zahl, die zählt. - Lass denselben Prompt durch zwei Modelle laufen und diff die Output-Qualität. Das ist „in deiner Domäne messen” ausführbar gemacht. Mach es bei einer Aufgabe, deren Antwort du kennst, nicht bei einem Toy-Prompt.
Häufige Fehler
- 401 Unauthorized: falscher Key, oder der Key hat keinen Zugriff auf dieses Modell. Auf OpenRouter brauchen manche Modelle extra Credits oder Allowlisting.
- 402 Payment Required: Guthaben aufgebraucht. Aufladen, dann exakt denselben Request erneut senden, bevor du irgendetwas anderes debugst.
- 404 Not Found: umbenannte Modell-IDs. Das ist es, was
deepseek-v4-flash-Nutzern passiert ist; nutzedeepseek-flash. Suche im Model-List-Endpoint des Providers nach der aktuellen ID. - 429 Too Many Requests: Concurrency, nicht Quote. DeepSeek erlaubt 2500 gleichzeitige auf Flash und 500 auf Pro. Back off und retry mit Jitter.
Self-Hosting-Hinweise
Wenn du Weights selbst servieren willst, sind die praktischen Picks Stand Oktober 2026:
- MiMo-V2.6-Pro-MOPD / Flash-MOPD (MIT): Ziehe den MOPD-Tag, nicht das Original-September-Release. Das MOPD-Checkpoint fixt die weiter oben beschriebene Tool-Call-Wiederholungsschleife
- MiMo-V2.6-Distill-Qwen-9B (MIT): Die Small-Box-Option. Du kannst lokale Modelle mit Ollama in Docker laufen lassen für einen eingedämmten Serving-Stack
- GLM-5.3-Flash (MIT, 320B/18B): Der Single-Multi-GPU-Node-Pick unter den großen Modellen. FP8-Weights
- Step 5 Preview und Muse Spark Open: BF16/NVFP4/GGUF/MLX-Quants existieren ab Tag eins, aber beide sind früh (Preview-Checkpoint, und Spark kam am 15. Oktober). Okay für Experimente, nicht zum Produktions-Pinnen
Kopiere keine unverifizierten Serving-Flags
Ich veröffentliche hier absichtlich keine vLLM- oder SGLang-Startbefehle für diese Modelle. Support-Matrizen bewegen sich wöchentlich, und ein falsches --tensor-parallel-size oder Quantisierungs-Flag kostet einen Abend. Prüfe die Hugging-Face-Card jedes Modells für aktuelle Serving-Anleitungen, bevor du den Server startest. Für die Agent-Seite der Sandbox: AI-CLI-Tools sicher in Docker oder Podman laufen lassen.
Zwei Ops-Anmerkungen.
Rollback ist langweilig – und das ist der Punkt. Ein self-gehostetes Modell ist Weights plus ein API-Prozess. Pinne ein Checkpoint-Tag in deiner Deploy-Config, und ein fehlgeschlagenes Upgrade zurückzudrehen heißt, das vorherige Tag neu zu deployen. Keine Migration, kein Datenformatwechsel.
Kostenrechnung, bevor du Eisen kaufst. Ein 320B-Klasse-Modell (GLM-5.3-Flash) braucht einen Multi-GPU-Node. Ein 2.4T-Klasse-Modell (Qwen3.8, K3) braucht die 8-GPU-Node-Klasse. Bei den Volumina im nächsten Abschnitt (10M in + 10M out pro Monat) liegt API-Ausgabe bei $6.50 für GLM-5.3-Flash und $80–$180 für Qwen3.8-Max und Kimi K3. Hardware gewinnt nur, wenn du Datenlokalität brauchst, dauerhaft viel höheres Volumen oder cache-lastige Workloads, die du lieber nicht meterst. Für das Small-Footprint-Ende der Skala sieh beste Mini-PCs für lokale LLMs.
Wenn du Hardware kaufst: Nichts davon läuft die 320B+-Modelle oben. Was eine Home-Box laufen kann, ist das kleine Ende: MiMo-V2.6-Distill-Qwen-9B und die quantisierte 30B–120B-Klasse.
| Box | Preis (23. Okt. 2026) | Wofür |
|---|---|---|
| Mac mini M6 16GB | $779 | Den Agenten gegen API-Modelle laufen lassen, plus ein 9B-Distill lokal. Siehe der beste Mac mini für OpenClaw |
| Desktop mit einer RTX 5060 Ti 16GB | $765.99 für die Karte | 9B–14B-Modelle schnell, mit CUDA für vLLM oder SGLang. Siehe den GPU-Box-Abschnitt |
| GMKtec EVO-X2 128GB | $3,649.99 | 70B dense und 120B-Klasse-MoE-Quants, langsam. Der günstigste 128GB-Mini-PC im Local-LLM-Guide |
Kostenaufschlüsselung: Was diese günstigen AI-Coding-Modelle wirklich kosten
Illustrative monatliche Kosten bei 10M Input- + 10M Output-Tokens, API-Listenpreise Stand 16. Oktober 2026. Echte Rechnungen bewegen sich mit Cache-Hits, Plänen, Batch-Rabatten und Off-Peak-Timing. Opus 5.5 ist die Baseline.
Monatlicher Kostenvergleich (10M in + 10M out)
| Modell | Input | Output | Gesamt | vs. Opus 5.5 | AA |
|---|---|---|---|---|---|
| GPT-6 Astra | $100 | $500 | $600 | 150% mehr | 53 |
| Claude Fable 5.1 | $100 | $500 | $600 | 150% mehr | 53 |
| Claude Opus 5.5 | $40 | $200 | $240 | Baseline | 58 |
| Kimi K3 (frischer Input) | $30 | $150 | $180 | ~25% weniger | 44 |
| Kimi K3 (Cache-Hit-Input) | $3 | $150 | $153 | ~36% weniger | 44 |
| Claude Sonnet 5.5 | $20 | $100 | $120 | 50% weniger | 56 |
| GPT-6.1 Sol | $20 | $100 | $120 | 50% weniger | 52 |
| Gemini 4 Argon | $20 | $100 | $120 | 50% weniger | 53 |
| Qwen3.8-Max | $20 | $60 | $80 | ~67% weniger | 45 / ~40 |
| GLM-5.3 | $14 | $44 | $58 | ~76% weniger | 45 |
| DeepSeek V4.1 Flash (Peak) | $3 | $12 | $15 | ~94% weniger | 39 |
| MiniMax M3 | $3 | $12 | $15 | ~94% weniger | 29 |
| MiMo V2.6 Pro | $4.35 | $8.70 | $13.05 | ~95% weniger | 46 |
| DeepSeek V4.1 Flash (Off-Peak) | $1.50 | $6 | $7.50 | ~97% weniger | 39 |
| GLM-5.3-Flash | $1.50 | $5 | $6.50 | ~97% weniger | 42 |
| Claude Haiku 5.5 | $1 | $5 | $6 | ~97% weniger | 43 |
| GPT-6 Luna | $1 | $5 | $6 | ~97% weniger | 38 |
Zwei Preis-Fußnoten
MiniMax M3: Die $0.30/$1.20-pro-Million-Rate ist die OpenRouter-Listung Stand 16. Oktober. Ein früherer Entwurf dieser Tabelle wurde als mögliche Dublette der DeepSeek-Zeile markiert (die Summen sind identisch, weil die Raten identisch sind). Prüfe MiniMax’ Direkt-Preise oder den MiniMax Token Plan, wenn du stattdessen ein Flat-Abo willst.
GPT-6-Familien-Umpreising: Requests über 272K Input-Tokens werden auf Astra-Niveau mit $20/$75 umgepreist. Qwens offene Weights schaffen nativ nur 262K vor Erweiterung. Langer Kontext ist der Punkt, an dem „günstig pro Million”-Rechnung bricht.
Die Pointe hat sich seit September geändert. Bei $6/Monat-Klasse-Ausgaben erreicht das proprietäre Tier jetzt den offenen Listenpreis: Haiku 5.5 und Luna landen bei dieser Rechnung beide auf $6. Du wählst trotzdem offene Modelle wegen Weights, Self-Hosting, Off-Peak- und Batch-Preisen und keinen Rate Limits. Und die Spitze des offenen Feldes (MiMo 46, GLM-5.3 45) kostet bei diesem Volumen immer noch $13–$58, während sie Haiku um 2–3 AA-Punkte und Luna um 7–8 schlägt. Der Trade: $6 kaufen dir 43 (Haiku) oder 38 (Luna) ohne Weights – oder $6.50 kaufen dir 42 mit MIT-Weights und Cache-Hits bei $0.03.
Zwei weitere Fußnoten zu dieser Tabelle. GPT-6 Astra und Fable 5.1 für $600 kaufen die Spitze des Index nur, wenn dein Workload AA 53–58 braucht. Die meiste Coding-Agent-Arbeit tut das nicht. Und Kimi K3s $15/M Output bedeutet, dass sein „günstiger” Ruf nur hält, wenn deine Input-Cache-Hit-Rate hoch bleibt.
Wenn du lieber einen monatlichen Flat-Rate zahlst und das Routing jemand anderem überlässt, behandelt die Aufschlüsselung OpenCode Go vs. ClinePass für günstigen Zugriff auf DeepSeek, Qwen und Kimi die Abo-Seite derselben Modelle.
Tipps und häufige Fehler
Was funktioniert
- Modell zur Aufgabe passen: GLM-5.3-Flash oder DeepSeek für Volumen, MiMo-V2.6-Pro (MOPD) oder GLM-5.3 für harte Agent-Runs, K3 für Research-Agents, Qwen3.8-Max für Frontend. Step 5 Preview zur Hard-Task-Liste hinzufügen, sobald es echte Preise hat
- Off-Peak-Fenster nutzen: DeepSeek halbiert die Preise außerhalb seiner zwei Wochentags-Peak-Fenster (01:00–04:00 und 06:00–10:00 UTC), und Wochenenden plus chinesische Feiertage zählen voll als Off-Peak. Der GLM Coding Plan halbiert Punkte Off-Peak und am Wochenende
- Pro Modell prompten: Jede Familie hat immer noch ihre eigenen Instruction-Macken
- In deiner Domäne messen: Vendor-Benches sind Marketing mit Methodik-Abschnitt; fahre eigene Evals
- Einen Fallback bereithalten: Provider-Hiccups passieren; OpenRouter macht den Wechsel zu einer Config-Zeile
Was du vermeiden solltest
- Jede Aufgabe standardmäßig ans teuerste Modell zu routen. Bei $20/M Output verbrennt Opus 5.5 bei Bulk-Refactors Geld
- Vendor-gemeldeten Benchmarks ohne unabhängige Runs zu vertrauen (DeepSeek V4.1-Flashs Terminal-Bench-Zahlen sind bisher selbst gemeldet)
- Agents ohne Permission-Scoping laufen zu lassen – gerade angesichts dessen, wie schnell die Cyber-Fähigkeiten in diesen Releases klettern. AI-CLI-Tools sicher in Docker oder Podman laufen lassen statt auf deinem Home-Verzeichnis
- Das Lizenz-Kleingedruckte zu ignorieren: MIT ist sauber, GLM-5.3 hat eine $10B-MaaS-Klausel, StepFun Model License 1.0 hat Umsatzbedingungen, Qwen, Kimi und Muse nutzen Custom-Lizenzen
- Tool-Call-Wiederholungsschleifen zu übersehen. Wenn ein Agent beschäftigt wirkt, aber der Dateibaum sich nie ändert, verbrennst du Tokens auf wiederholte Tool Calls. Wechsle zu einem MOPD-Checkpoint oder baue Loop-Detection in den Harness. Xiaomis Diagnose-Post beschreibt das Muster gut
Was als Nächstes kommt
- DeepSeek-V4.1-Pro: Das Familien-Flaggschiff. Stand 16. Oktober immer noch abwesend auf Hugging Face und in der API;
deepseek-v4-proserviert weiterhin DeepSeek-V4-Pro-0813 bei $0.66–$1.32 in / $1.98–$3.96 out - Erneuerte Qwen3.8-Weights: Das 0902-Post-Training ist heute API-only. Verifiziert am 16. Oktober: keine neuen 3.8-Weights auf der Qwen-Org seit August. Ein aktualisiertes Checkpoint wäre für Self-Hoster relevant
- Tencent Hy4: 770B Apache-2.0-Preview, immer noch
tencent/hy4-previewauf OpenRouter bei $0.751/$2.251 und auf Hugging Face mit FP8- und Community-GGUF-Quants. Kein GA - Step 5 GA und Preise: Wenn StepFun das finale Modell unter K3s $3/$15 preist, wird es das Default-Open-Modell für harte Aufgaben
- Metas Muse-Linie: Muse Wonder (AA 52, 12. Oktober) ist das proprietäre Flaggschiff; Muse Spark Open (15. Oktober, 816B/42B, AA 39, Muse Model License) ist das Open Release mit NVFP4- und MLX-Quants ab Tag eins. Lies die Umsatzbedingungen der Muse-Lizenz, bevor du eines davon kommerziell empfiehlst
- Weitere Kandidaten: GLM-5.3-Prime- und FlashX-Weights (beide heute API-only), Inkling von Thinking Machines (975B/41B, Apache-2.0, AA 25) und Reflections Beam 1.0 (501B/23B, Apache-2.0, AA 30). Interessante Lizenzen, noch keine Coding-Anwärter
Welches Open-Source-LLM solltest du wählen?
MiMo-V2.6-Pro, wenn du willst:
- Den höchsten Open-Weights-Score (AA 46) mit MIT-Weights
- Starke agentische Zahlen (AutomationBench 53.1, DeepSWE 71.9)
- Text + Bild + Video + Audio in einem Modell
- $0.44/$0.87-Preise, ~134 tok/s
- Ziehe das MOPD-Checkpoint für Agent-Arbeit
GLM-5.3, wenn du brauchst:
- Das stärkste offene Coding-Profil (TB 3.0 28.3, FrontierSWE 78.1)
- Einen bewährten Daily Driver mit Coding-Plan-Abo-Optionen
- Einen Anthropic-kompatiblen Endpoint für Claude-Code-artige Tools
- Planbare $1.40/$4.40-Preise
DeepSeek V4.1 Flash, wenn du willst:
- Vendor-gemeldete 90.6% Terminal-Bench 2.1 und 74.2 DeepSWE (verifiziere gegen das Live-Leaderboard)
- MIT-Weights und das günstigste ernsthafte Agent-Serving
- Off-Peak-Preise, die eine ohnehin niedrige Rechnung halbieren – Wochenenden inklusive
- 384K Output-Budget für lange Generierungen
GLM-5.3-Flash, wenn du willst:
- $0.15/$0.50-Listenpreise mit MIT-Weights
- Nativen Bild- + Video-Input
- Ein 320B-Modell, das auf einen Node passt
- 84.3% TB 2.1, vier AA-Punkte hinter seinem Flaggschiff-Geschwister
Kimi K3, wenn du willst:
- Die größten offenen Weights (2.8T)
- BrowseComp-91.2-Research-Agents
- AWS-Bedrock-Deployment mit Prompt-Caching
- Du kannst mit $15/M Output leben und dich auf Cache-Hits stützen
Qwen3.8-Max, wenn dir wichtig ist:
- #1 auf Code Arena WebDev für Frontend-Arbeit
- $2/$6 API-Preise mit 1M Kontext
- Ein 2.4T-Open-Weights-Pfad, wenn du bereit zum Self-Hosten bist
Step 5 Preview, wenn du willst:
- Den neuen Open-Score Nr. 3 (AA 44) mit nur 27B aktiven Parametern
- 600B Weights mit BF16/NVFP4 und Community-GGUF-Quants bereits draußen
- Du kannst mit einem Preview-Checkpoint und einer Custom-Lizenz leben, während Preise noch TBD sind
Meine Rangfolge für Coding-Agent-Arbeit im Moment: GLM-5.3 als Default, MiMo-V2.6-Pro (MOPD), wenn die Aufgabe lang oder multimodal ist, GLM-5.3-Flash für Volumen, wenn du Weights brauchst, und Haiku 5.5, wenn nicht, DeepSeek V4.1-Flash für terminal-lastige Loops, und Kimi K3 oder Qwen3.8-Max, wenn ihre spezifischen Stärken (Research, Frontend) zum Job passen. Step 5 Preview tritt der Hard-Task-Liste an dem Tag bei, an dem es echte Preise bekommt.
Speziell für agentische Harnesses filtert die Shortlist beste Open-Source-Modelle für OpenClaw dasselbe Set nach Tool-Calling-Zuverlässigkeit.
Ein Satz dazu, wann du Open komplett überspringen solltest: Claude Sonnet 5.5 mit AA 56 und $2/$10 ist die Value-Bedrohung, und wenn du keine Weights, Off-Peak-Abrechnung oder einen Self-Host-Ausstieg brauchst, ist es ein vertretbarer Default. Ich wähle trotzdem Open für alles Langlebige, weil ein Checkpoint pinnen und selbst servieren die einzige Version von „dieses Modell wird nächstes Quartal noch existieren” ist, die du kontrollierst.
FAQ
Was ist gerade das beste Open-Source-LLM?
Stand Oktober 2026: MiMo-V2.6-Pro hält den Top-Open-Weights-Score auf dem Artificial Analysis Intelligence Index mit 46, GLM-5.3 ist der stärkste offene Coding-Spezialist mit 45, und Step 5 Preview ist die aufsteigende Nr. 3 mit 44. Für die meiste Coding-Agent-Arbeit fahre ich GLM-5.3 als Default und wechsle zu MiMo-V2.6-Pro (MOPD-Checkpoint) für lange oder multimodale Runs. Prüfe die Zahlen erneut, bevor du dich festlegst; diese Tabelle bewegt sich monatlich.
Können Open-Source-Modelle Claude Opus 5.5 wirklich ersetzen?
Für die meiste Coding-Agent-Arbeit ja – bei 5–10 % der Flaggschiff-Kosten. Die offenen Top fünf beherrschen Refactors, Tool-Calling und lange Repo-Sessions gut. An der absoluten Fähigkeits-Spitze nein: Opus 5.5s AA 58 ist immer noch die Decke, und Fable 5.1 / Astra bei 53 halten einen Vorsprung auf den härtesten agentischen Evals. Der praktische Test ist nicht der Benchmark, sondern ob deine Task-Retries verschwinden. Lass beide auf einer echten Arbeitswoche laufen und vergleiche Kosten pro gemergtem PR, nicht Kosten pro Million Tokens.
Was ist der günstigste Weg, diese Modelle zu nutzen?
Vier Hebel, geordnet nach Wirkung: schwere Arbeit Off-Peak schedulen (DeepSeek halbiert Preise außerhalb seiner zwei Wochentags-Peak-Fenster, Wochenenden inklusive), Cache-Hit-Raten hoch halten (DeepSeek-Cache-Hits sind $0.006/M, GLM-5.3-Flash ist $0.03/M), Evals batchen statt interaktiv zu fahren, und auf Haiku 5.5 ($0.10/$0.50, AA 43) runtergehen, wenn du ohne Weights leben kannst. Flat-Rate-Abos wie OpenCode Go ändern die Rechnung noch einmal, wenn dein Verbrauch sprunghaft ist.
Brauche ich eine GPU, um anzufangen?
Nein. OpenRouter und die direkten Provider-APIs geben dir jedes Modell in diesem Artikel ganz ohne Hardware. Eine GPU ist nur fürs Self-Hosting: GLM-5.3-Flash (320B) braucht einen Multi-GPU-Node, Qwen3.8 und K3 brauchen die 8-GPU-Node-Klasse, und nur MiMo-V2.6-Distill-Qwen-9B ist realistisch auf kleinem Eisen. Wenn du einfach ein 9B-Modell lokal laufen lassen willst, reicht Ollama in Docker für den Start.
Sind diese Lizenzen für kommerzielle Nutzung sicher?
MIT ist sauber (MiMo-V2.6-Familie, GLM-5.3-Flash, DeepSeek V4.1-Flash). Der Rest braucht ein Lesen: GLM-5.3 nutzt eine MIT-artige Lizenz mit einer $10B-Revenue-MaaS-Klausel, StepFun Model License 1.0 hat Umsatzbedingungen, und Qwen, Kimi und Muse nutzen alle Custom-Lizenzen. Keine davon ist „closed”, aber zwei davon werden relevant, wenn dein Produkt eine Umsatzschwelle überschreitet oder das Modell als Service anbietet. Lies den Lizenztext, nicht den Blogpost.
Bereit loszulegen?
Die Kurzfassung: GLM-5.3 oder MiMo-V2.6-Pro (MOPD) für harte Arbeit, GLM-5.3-Flash oder Haiku 5.5 für Volumen, DeepSeek für Terminal-Loops. Alle offenen Modelle sind über ihre Provider erreichbar, und die meisten liegen auf OpenRouter. Wenn du die Codex-App nutzt, zeigt unser Codex-App-mit-beliebigem-Modell-Guide, wie du GLM, MiniMax und MiMo mit einer kurzen Config einsteckst. Für Coding-Agents auf einem günstigen VPS sieh den OpenCode-Setup-Guide und den Pi-Coding-Agent-Setup-Guide; unser VPS-Setup für AI-Coding-Agents deckt die Box darunter ab. Volle Preise und Hermes-fokussierte Benches liegen in beste günstige Modelle für Hermes Agent, die Tooling-Karte in Top-KI-GitHub-Repos, und die Agent-first-Sicht in beste AI-Coding-Tools und Agents.
Ähnliche Artikel
Hat diese Anleitung bei dir funktioniert?

Geschrieben von Dragos
Dragos is the author of Bitdoze — practical DevOps, programming, and self-hosting guides.
Mehr Anleitungen von Dragos →Brauchst du Hilfe bei Astro, VPS oder einer Self-hosted-App? Services ansehen →