Configura las copias de seguridad de Dokploy con Cloudflare R2 - Guía completa
Configura las copias de seguridad de Dokploy en Cloudflare R2: destino S3, copias programadas del sistema, de bases de datos y de volúmenes, retención y una restauración probada en la que puedes confiar.

Actualizado Publicado 54 min de lectura
Si te autoalojas con Dokploy, tus copias de seguridad son lo único que separa una mala edición de docker compose de un fin de semana muy largo. Esta guía conecta el sistema de copias de seguridad de Dokploy con Cloudflare R2: el destino S3, los tres tipos de backup, una retención que se limpia sola y pasos de restauración que ejecutas antes de necesitarlos.
Cloudflare R2 funciona bien aquí porque es compatible con S3, tiene un nivel gratuito aprovechable y no cobra nada por el egress (la descarga de datos), lo que importa el día en que realmente tengas que bajarte un backup de volúmenes de 20 GB. Además vive en un proveedor distinto al de tu VPS, que es exactamente la idea.
Todo lo que sigue se volvió a comprobar contra la documentación de Dokploy (backups, backups de bases de datos, restauración, backups de volúmenes, destinos S3 y la referencia de la API) en septiembre de 2026. Cuando un comportamiento depende de la versión lo indico, en lugar de fingir que es estable.
Qué cambió en esta actualización de 2026
- Los backups de volúmenes ahora importan para más que aplicaciones: la API acepta los tipos de servicio
postgres,mysql,mariadb,mongo,redis,composeylibsql. Los volúmenes de Redis y libSQL se respaldan como cualquier otro volumen nombrado. - La retención está integrada. Los registros de backup y de backup de volúmenes llevan un
keepLatestCount, así que podar objetos antiguos ahora es trabajo de Dokploy, no tu tarea mensual. - El límite estricto que casi nadie ve: los backups de volúmenes solo funcionan con volúmenes nombrados de Docker. Cualquier cosa montada como
../files/…(un bind mount) no se respalda en absoluto. Si tu stack usa bind mounts, migra antes de fiarte de la programación. - El backup del sistema no contiene los datos de tus aplicaciones. Es la propia base de datos Postgres de Dokploy más
/etc/dokploy. Tus bases de datos y volúmenes de aplicaciones necesitan sus propias entradas de backup. - Todo lo que hay en la UI tiene un endpoint de API (
/api/destination.create,/api/backup.create,/api/volumeBackups.create), así que los destinos y las programaciones pueden vivir en tu repo de configuración en lugar de en tu memoria.
Por qué importan las copias de seguridad
Esta es la lista corta de formas en que desaparecen los datos autoalojados:
- Fallos de hardware y del proveedor: discos muertos, un hipervisor que se traga la VM, un incidente en el centro de datos
- Error humano: tablas eliminadas, un compose que apunta la base de datos a un volumen vacío,
docker volume rmsobre el nombre equivocado - Incidentes de seguridad: una contraseña del panel filtrada o un contenedor comprometido con ruta de escritura a tus datos
- Problemas de cuenta: facturación suspendida, una cuenta cloud bloqueada, una tarjeta caducada que olvidaste
- Bugs de software: una migración fallida, una actualización de la app que reescribe datos en el sitio
- Cumplimiento: algunos trabajos exigen retención y un plan de recuperación documentado, no un encogimiento de hombros
La regla que sigo: nunca guardes la única copia en el proveedor que aloja los datos primarios. Si tu proveedor de VPS suspende la cuenta o pierde un rack, necesitas datos que nunca estuvieron en esa cuenta.
Por qué usar un proveedor distinto
Hetzner, donde corren mis hosts de Dokploy, vende almacenamiento barato compatible con S3, y sus snapshots de servidor están bien para revertir una mala actualización de paquetes. Ninguna de las dos cosas es un backup:
- Los snapshots viven en la misma cuenta y normalmente en la misma región que el servidor, así que los problemas a nivel de proveedor se llevan las dos copias.
- Un snapshot de una base de datos en ejecución no es un volcado consistente. Obtienes los bytes que había en disco a mitad de escritura.
- Una suspensión de cuenta no es un fallo de hardware. Te deja fuera de todo el proveedor, snapshots incluidos.
Guardar los backups en la cuenta de otro proveedor te da:
- Separación del radio de explosión: una cuenta de VPS suspendida sigue dejando tus backups legibles
- Separación geográfica: centros de datos distintos, dominios de fallo distintos
- Separación de facturación: un pago fallido en un proveedor no congela la recuperación en el otro
- Independencia del proveedor: el almacenamiento compatible con S3 se mueve entre proveedores con un cambio de configuración
Regla crítica de backups
Guarda los backups en una cuenta de proveedor distinta a la de tu infraestructura principal. Los snapshots en el mismo proveedor son comodidad, no recuperación ante desastres.
Los precios de los VPS subieron en general en 2026 — si estás replanteándote una máquina alquilada, mira qué cambió y cuándo gana un mini PC.
Opciones de backup de Dokploy
Dokploy tiene tres mecanismos de backup separados, y no se solapan. Configuras cada uno, y nada corre hasta que lo haces. No hay programación por defecto.
1. Backups del sistema de Dokploy
Respalda la propia instalación de Dokploy.
Qué contiene:
- La base de datos PostgreSQL
dokploy-postgrescon tus aplicaciones, servicios, variables de entorno, destinos e historial de despliegues - El sistema de archivos de Dokploy en
/etc/dokploycon ajustes, configuraciones de Traefik y certificados - Tus usuarios, conexiones con proveedores git y claves de despliegue
Ambas piezas se combinan y comprimen en un único .zip que se sube a tu destino S3. La disposición exacta de carpetas dentro del archivo ha cambiado entre versiones de Dokploy, así que trátalo como una caja negra y verifícalo restaurando, no descomprimiéndolo y adivinando.
Cuándo usarlo: antes de actualizar Dokploy, después de grandes cambios de configuración y como primer paso de cualquier migración de servidor.
Comprobación de realidad: este archivo no contiene las bases de datos de tus aplicaciones ni tus volúmenes Docker. Restaurarlo te devuelve la configuración de Dokploy, no los datos de tus apps.
2. Backups de bases de datos
Volcados por base de datos, ejecutados por Dokploy en una programación cron.
Tipos soportados: PostgreSQL (pg_dump), MySQL (mysqldump), MariaDB (mariadb-dump), MongoDB (mongodump), libSQL, más un tipo web-server para el backup del sistema de Dokploy de arriba.
Qué contiene: el esquema, los datos y, en los motores SQL, los permisos que pediste al volcado conservar. En Postgres el comando por defecto elimina deliberadamente las ACL y la propiedad (--no-acl --no-owner), lo que hace que restaurar en un clúster nuevo duela bastante menos.
Cuándo usarlo: en toda base de datos que guarde algo que echarías de menos, antes de migraciones de esquema y al clonar producción a staging.
Comprobación de realidad: un backup de base de datos se restaura en una base de datos. No recuperará los archivos subidos ni el volumen propio del contenedor.
3. Backups de volúmenes
Respalda volúmenes nombrados de Docker a un destino S3.
Bueno para: apps basadas en SQLite (n8n, Memos, Uptime Kuma), archivos subidos, estado de aplicación que vive en un volumen, directorios de datos de Redis y libSQL.
Servicios soportados: Applications de un solo contenedor y servicios Docker Compose, con tipos de servicio application, postgres, mysql, mariadb, mongo, redis, compose y libsql.
Cuándo usarlo: cualquier cosa que almacene estado fuera de una base de datos volcable.
Comprobación de realidad: los bind mounts no están cubiertos. Si tu compose monta ../files/my-data:/app/data, Dokploy no puede respaldarlo, ni siquiera con un aviso. Simplemente no lo hace. Detalles en el Paso 5.
Por qué Cloudflare R2 para los backups
Cloudflare R2 es almacenamiento de objetos compatible con S3 con un nivel gratuito realmente aprovechable.
Nivel gratuito
- 10 GB de almacenamiento gratis cada mes
- Cero costes de egress: no pagas nada por descargar tus backups, que es cuando menos quieres una factura
- API compatible con S3: funciona con la AWS CLI, rclone, restic y el formulario de destinos de Dokploy
- Cifrado en reposo activado por defecto
- Sin duración mínima de almacenamiento ni tasas de recuperación: a diferencia de los niveles S3 baratos que te facturan por borrar objetos jóvenes
Comparación de costes
Los precios se mueven, así que toma esto como una planificación de orden de magnitud y confirma en la página de precios de cada proveedor antes de comprometerte.
| Proveedor | Almacenamiento (por GB/mes) | Egress | Nivel gratuito |
|---|---|---|---|
| Cloudflare R2 | $0.015 | $0.00 | 10 GB de almacenamiento |
| Backblaze B2 | ~$0.006 | cobrado, con una franquicia diaria gratuita | 10 GB de almacenamiento |
| AWS S3 Standard | $0.023 | $0.09 por GB | 5 GB, cuentas nuevas, primeros 12 meses |
| Hetzner Storage Box | mensual fijo, unos 4 € por la caja más pequeña | incluido | ninguno |
La ventaja de R2 no es la línea de almacenamiento más barata, es la línea de egress. Una restauración de 200 GB desde S3 Standard cuesta unos 18 $ en ancho de banda. Desde R2 no cuesta nada, y ese es el momento en que no quieres estar optimizando.
R2 también factura las operaciones por separado (Clase A para escrituras y listados, Clase B para lecturas). Para cargas de backup esos números son errores de redondeo respecto a tu línea de almacenamiento, pero si apuntas al bucket un trabajo de sincronización parlanchín, revísalos.
Más allá del nivel gratuito
Por encima de 10 GB pagas la tarifa estándar de almacenamiento, así que 100 GB de backups cuestan unos 1,50 $/mes. Ese es el coste total de una estrategia de backups sensata para alguien que se autoaloja, motivo por el cual dejo de discutir con quien dice que los backups son caros.
Alternativas que conviene conocer
R2 es mi opción por defecto aquí porque es la mejor historia de egress y es un proveedor distinto al de mi VPS. Si quieres opciones: Backblaze B2 si quieres la tarifa de almacenamiento más baja, Hetzner Storage Box si quieres una factura mensual fija y no te importa la separación de proveedores, y Bunny Storage vs S3 vs Backblaze si vas a hacer la comparación en serio. Si prefieres guardar los backups en hardware propio, RustFS con Dokploy te da un endpoint S3 que controlas; solo recuerda que una segunda copia en el mismo servidor no es offsite.
Paso 1: Configura el bucket de R2 y el token de API
Esto lleva unos cinco minutos en el panel de Cloudflare.
1.1 Crea el bucket
- Entra en el panel de Cloudflare y abre R2 Object Storage.
- Haz clic en Create bucket.
- Ponle un nombre explícito:
dokploy-backups, o un bucket por propósito si quieres reglas de ciclo de vida limpias más adelante. - Elige una pista de ubicación cercana a tu VPS: WEUR (Europa Occidental), ENAM (Este de Norteamérica), WNAM (Oeste de Norteamérica), APAC (Asia Pacífico). El campo Region de Dokploy tiene que coincidir con esto.
- Créalo.
Reglas de nombres de bucket: 3-63 caracteres, letras minúsculas, números y guiones, y no puede empezar ni terminar con guion.
1.2 Crea un token de API con alcance a ese bucket
- Vuelve a R2 Object Storage y elige Manage API tokens en el desplegable.
- Haz clic en Create API token.
- Llámalo
Dokploy Backup Access. - Permisos: Object Read & Write.
- Apply to specific buckets only y selecciona
dokploy-backups. No le des a Dokploy acceso a toda la cuenta porque fuera más fácil. - Créalo y copia los dos valores enseguida:
Access Key ID:     f3811c6d27415a9s6cv943b6743ad784
Secret Access Key: aa55ee40b4049e93b7252bf698408cc22a3c2856d2530s7c1cb7670e318f15e58
Estos son los valores de ejemplo de la documentación de Dokploy. Los tuyos serán distintos, y el secreto se muestra una sola vez. Mete ambos en un gestor de contraseñas antes de cerrar la pestaña.
Limitar el token es toda la historia de endurecimiento aquí
Un token con acceso a todo R2 puede leer y borrar cada bucket que poseas si se filtra a través de un archivo de backup de Dokploy o una llamada de API mal configurada. Limítalo a un bucket, ponle fecha de caducidad si tu plan de R2 lo permite, y rótalo si alguna vez lo pegas donde te arrepientas.
1.3 Obtén el endpoint de la cuenta
En la página de resumen de R2 verás el endpoint de tu cuenta, con este formato:
https://8ah554705io7842d54c499fbee1156c1c.r2.cloudflarestorage.comSin nombre de bucket en la URL, https:// incluido, termina en .r2.cloudflarestorage.com. Ese es el valor que quiere Dokploy.
1.4 Verifica las credenciales antes de tocar Dokploy
Fallar dentro de Dokploy no te dice nada útil. Prueba primero la clave con la AWS CLI:
# requires aws cli v2 -> aws --version
export AWS_ACCESS_KEY_ID="<R2 access key id>"
export AWS_SECRET_ACCESS_KEY="<R2 secret access key>"
export AWS_DEFAULT_REGION="auto"   # R2 ignores the value but the CLI wants one

aws s3 ls "s3://dokploy-backups/" \
  --endpoint-url "https://<account-id>.r2.cloudflarestorage.com" \
  --recursive --human-readable --summarize
Un listado vacío y código de salida 0 significa que la clave, el endpoint y el nombre del bucket son correctos. Así se ve lo roto:
InvalidAccessKeyIdoSignatureDoesNotMatch: clave equivocada, o pegaste el secreto con un espacio al finalNoSuchBucket: errata en el nombre del bucket, y distingue mayúsculasAccessDenieden un listado: el token tiene alcance a un bucket distinto del que estás pidiendo- quejas de región: en algunas versiones de la CLI pon
AWS_DEFAULT_REGION=us-east-1en lugar deauto
Si prefieres rclone, tiene un proveedor Cloudflare integrado:
rclone config create r2 s3 provider Cloudflare \
  access_key_id "$AWS_ACCESS_KEY_ID" \
  secret_access_key "$AWS_SECRET_ACCESS_KEY" \
  endpoint "https://<account-id>.r2.cloudflarestorage.com"

rclone lsl r2:dokploy-backups --max-depth 2
Paso 2: Añade el destino R2 en Dokploy
Los destinos son globales: configuras uno y lo reutilizas para cada entrada de backup.
- En Dokploy, abre Settings → Destinations (la ruta es
/dashboard/settings/destinations). - Haz clic en New Destination y elige S3 Compatible.
- Rellena el formulario:
| Campo de Dokploy | Valor | Notas |
|---|---|---|
| Destination Name | Cloudflare R2 Backups |
Cualquier etiqueta; local a Dokploy |
| Access Key ID | clave de acceso R2 | Del paso 1.2, sin espacios extra |
| Secret Access Key | secreto R2 | Se muestra una vez en Cloudflare |
| Region | WEUR, ENAM, WNAM o APAC |
Debe coincidir con la pista de ubicación del bucket |
| Endpoint | https://<account-id>.r2.cloudflarestorage.com |
Sin nombre de bucket añadido |
| Bucket | dokploy-backups |
Distingue mayúsculas, sin barras |
| Force Path Style | Activado | Obligatorio para R2 |
Por qué importa Force Path Style: sin él, el cliente S3 construye URLs de tipo virtual-hosted como bucket.endpoint/key. R2 quiere URLs path-style, endpoint/bucket/key. Déjalo apagado y el test de conexión puede pasar mientras las subidas fallan, que es el peor tipo de fallo.
Dónde viven las credenciales: Dokploy las guarda en su propia base de datos Postgres (la tabla destination son columnas en claro: clave de acceso, secreto, bucket, región, endpoint). Dos consecuencias: tus destinos vuelven con una restauración del sistema, y cualquiera que pueda leer la base de datos de Dokploy puede leer tus claves de R2. Limita el token en consecuencia.
- Haz clic en Test Connection. Un mensaje de éxito significa que endpoint, región, bucket y clave cuadran.
Verifícalo de verdad en lugar de fiarte del aviso: después de guardar el destino, crea cualquier backup pequeño (o lanza una prueba manual desde la pestaña Backup de una base de datos) y lista el bucket desde tu portátil:
aws s3 ls "s3://dokploy-backups/" \
  --endpoint-url "https://<account-id>.r2.cloudflarestorage.com" \
  --recursive --human-readable --summarize
Deberías ver aparecer un objeto con una marca de tiempo en un minuto o dos. Ningún objeto más un test en verde suele significar que el test del destino solo validó la llamada de API, no la ruta de escritura, así que revisa los logs de Dokploy y mira la sección de resolución de problemas al final.
Paso 3: Respalda el propio sistema Dokploy
Este es el backup que salva tu configuración cuando el panel está roto o estás cambiando de servidor.
Configúralo
- Ve a Web Server → Backups.
- Haz clic en Create Backup.
- Rellena los ajustes:
| Ajuste | Valor recomendado | Por qué |
|---|---|---|
| Destination | Cloudflare R2 Backups | El destino del Paso 2 |
| Prefix | dokploy-system |
Carpeta dentro del bucket |
| Schedule (cron) | 0 2 * * * |
Diario a las 02:00, hora del servidor |
| Keep latest count | 7 |
Dokploy borra los objetos más antiguos del prefijo |
| Enabled | Activado | Nada corre sin esto |
La sintaxis cron es la estándar de cinco campos: minuto hora día mes día-de-semana.
0 2 * * *     # daily at 02:00
0 */6 * * *   # every 6 hours
0 2 * * 0     # weekly, Sunday 02:00
0 3 1 * *     # monthly, 1st at 03:00
Keep latest count es el ajuste de retención. Ponlo y Dokploy poda los archivos antiguos de ese prefijo por ti, así que la retención deja de ser un script que olvidas escribir. Déjalo vacío y los objetos se acumulan hasta que alcances el nivel gratuito de R2 y empieces a depurar errores de cuota.
La programación la evalúa el propio servicio Dokploy, así que si Dokploy está caído o el VPS apagado, el backup no corre. Presupuesta para eso: backups manuales antes de actualizar y una comprobación externa de que el objeto más reciente está fresco (Paso 6).
Ejecuta primero uno manual
Antes de fiarte del cron, dispara un backup y obsérvalo. Luego confirma tres cosas:
- Existe un objeto en el bucket bajo el prefijo que pusiste.
- Su tamaño es plausible (un archivo del sistema Dokploy suele ser de decenas de MB, ni 0 bytes ni 5 GB).
- Dejó de cambiar. Un archivo que sigue creciendo minutos después significa que la subida sigue en vuelo o se ha atascado.
Qué contiene y qué no contiene el archivo
Contiene: el volcado de dokploy-postgres y una copia de /etc/dokploy (config de Traefik, certificados, metadatos), comprimidos en un solo .zip.
No contiene: las bases de datos de tus aplicaciones, tus volúmenes Docker ni el código fuente de tus aplicaciones (que vive en Git, presumiblemente).
Paso 4: Respalda las bases de datos de las aplicaciones
Hazlo para cada base de datos que guarde algo que no puedas regenerar.
- Abre Databases, elige la base de datos y luego la pestaña Backup.
- Configura:
| Ajuste | Ejemplo | Notas |
|---|---|---|
| Destination S3 Bucket | Cloudflare R2 Backups | Reutiliza el mismo destino |
| Database Name | precumplimentado | La base de datos a la que pertenece esta entrada |
| Schedule Cron | 0 */6 * * * |
Cada seis horas para producción |
| Prefix | prod-db |
Carpeta dentro del bucket |
| Keep latest count | 7 |
Conserva los últimos 7 objetos del prefijo |
| Enabled | Activado |
- Haz clic en Test. Dokploy ejecuta un backup real al destino; comprueba el resultado en el bucket. Es el único botón del flujo que demuestra que toda la ruta funciona.
Programaciones que uso de verdad:
0 */6 * * *   # production databases with real writes
0 2 * * *     # staging, once a day
0 2 * * 0     # dev or scratch databases, weekly
0 */3 * * *   # e-commerce or anything transactional
Disposición de archivos en el bucket:
dokploy-backups/
  └── prod-db/
      ├── postgres-backup-2026-09-14-00-00.sql.gz
      ├── postgres-backup-2026-09-14-06-00.sql.gz
      ├── postgres-backup-2026-09-14-12-00.sql.gz
      └── postgres-backup-2026-09-14-18-00.sql.gz
Los comandos que ejecuta Dokploy
No necesitas escribirlos, pero conviene saber qué es realmente tu backup, porque decide cómo restauras y en qué puedes confiar.
PostgreSQL:
pg_dump -Fc --no-acl --no-owner -h localhost -U ${databaseUser} \
  --no-password '${database}' | gzip
-Fc produce el formato de archivo custom, --no-acl --no-owner elimina privilegios y propiedad para que las restauraciones en un clúster nuevo funcionen, y la tubería a gzip comprime el resultado. Así que el archivo es un archivo en formato custom comprimido con gzip: restaúralo con gunzip -c file.gz | pg_restore, no con psql.
MySQL:
mysqldump --default-character-set=utf8mb4 -u 'root' \
  --password='${databaseRootPassword}' \
  --single-transaction --no-tablespaces \
  --quick '${database}' | gzip
--single-transaction te da una instantánea consistente en InnoDB sin bloquear tablas, --quick vuelca las filas en streaming en lugar de guardarlas en memoria, y --no-tablespaces evita errores de privilegios al restaurar.
MariaDB:
mariadb-dump --user='${databaseUser}' \
  --password='${databasePassword}' \
  --databases ${database} | gzip
MongoDB:
mongodump -d '${database}' -u '${databaseUser}' \
  -p '${databasePassword}' \
  --archive --authenticationDatabase=admin --gzip
Verifica el volcado, no solo la subida
Un archivo en el bucket demuestra que la subida funcionó. No demuestra que el volcado sea usable. Para backups de Postgres, este one-liner lista la tabla de contenidos del archivo sin restaurar nada:
gunzip -c postgres-backup-2026-09-14-06-00.sql.gz \
  | docker run --rm -i postgres:16 pg_restore -l | head -20
Si eso imprime una TOC con tus tablas, el volcado es legible. Si falla con “did not find magic string”, comprimiste con gzip un volcado de texto y estás usando la ruta de restauración equivocada, o la subida quedó truncada.
Varias bases de datos
Buenas prácticas para varias bases de datos
Usa un prefijo por servicio, no adivinanzas por entorno:
prod-web-app/     # main app database
prod-analytics/   # analytics
prod-auth/        # auth service
dev-testing/      # throwaway
Escalona los crons. Cinco bases de datos volcando todas a 0 2 * * * se pelearán por E/S de disco y CPU en un VPS pequeño. Repártelas:
0 2 * * *   # database 1
15 2 * * *  # database 2
30 2 * * *  # database 3
Pon la retención según la criticidad: producción 7+ objetos, staging 3, dev 1.
Revisa los tamaños semanalmente. Un volcado que de repente baja de 400 MB a 40 MB o es una gran noticia sobre tu trabajo de limpieza o es un volcado roto. No sabrás cuál a menos que mires.
Prueba una restauración al mes en las bases de datos que importan. Ver Paso 7.
Paso 5: Respalda los volúmenes Docker
Los backups de volúmenes cubren el estado que vive fuera de una base de datos: archivos SQLite, subidas, volcados de Redis, datos de libSQL.
Solo volúmenes nombrados: esta es la trampa
Los Volume Backups funcionan únicamente con volúmenes nombrados de Docker. Los bind mounts como ../files/my-data:/app/data no están cubiertos, no se pueden seleccionar y no producen ningún aviso. Si tu servicio usa bind mounts, no tiene backup de volúmenes. Migra primero a un volumen nombrado.
Migrar un bind mount a un volumen nombrado:
# Before: ../files/... is a bind mount, invisible to Volume Backups
services:
  app:
    image: dokploy/dokploy:latest
    volumes:
      - ../files/my-data:/app/data

# After: a named volume Dokploy can back up
services:
  app:
    image: dokploy/dokploy:latest
    volumes:
      - my-volume:/app/data

volumes:
  my-volume:
Haz la migración con el contenedor parado y mueve tú los archivos (docker run --rm -v my-volume:/data -v "$PWD/files/my-data":/src alpine cp -a /src/. /data/). Es un movimiento de datos real, no una edición de config que te cubran.
Ejemplo práctico: n8n
n8n guarda su base de datos SQLite, credenciales y workflows dentro del volumen n8n_data, así que los backups de bases de datos no te ayudan.
version: "3.8"
services:
  n8n:
    image: docker.n8n.io/n8nio/n8n:1.83.2
    restart: always
    environment:
      - N8N_HOST=${N8N_HOST}
      - N8N_PORT=${N8N_PORT}
      - N8N_PROTOCOL=http
      - NODE_ENV=production
      - WEBHOOK_URL=https://${N8N_HOST}/
      - GENERIC_TIMEZONE=${GENERIC_TIMEZONE}
      - N8N_SECURE_COOKIE=false
    volumes:
      - n8n_data:/home/node/.n8n
volumes:
  n8n_data:
La propia plantilla n8n de Dokploy usa exactamente este volumen. Hay un recorrido completo en Cómo autoalojar n8n con Docker, Traefik y Dokploy si lo estás montando ahora.
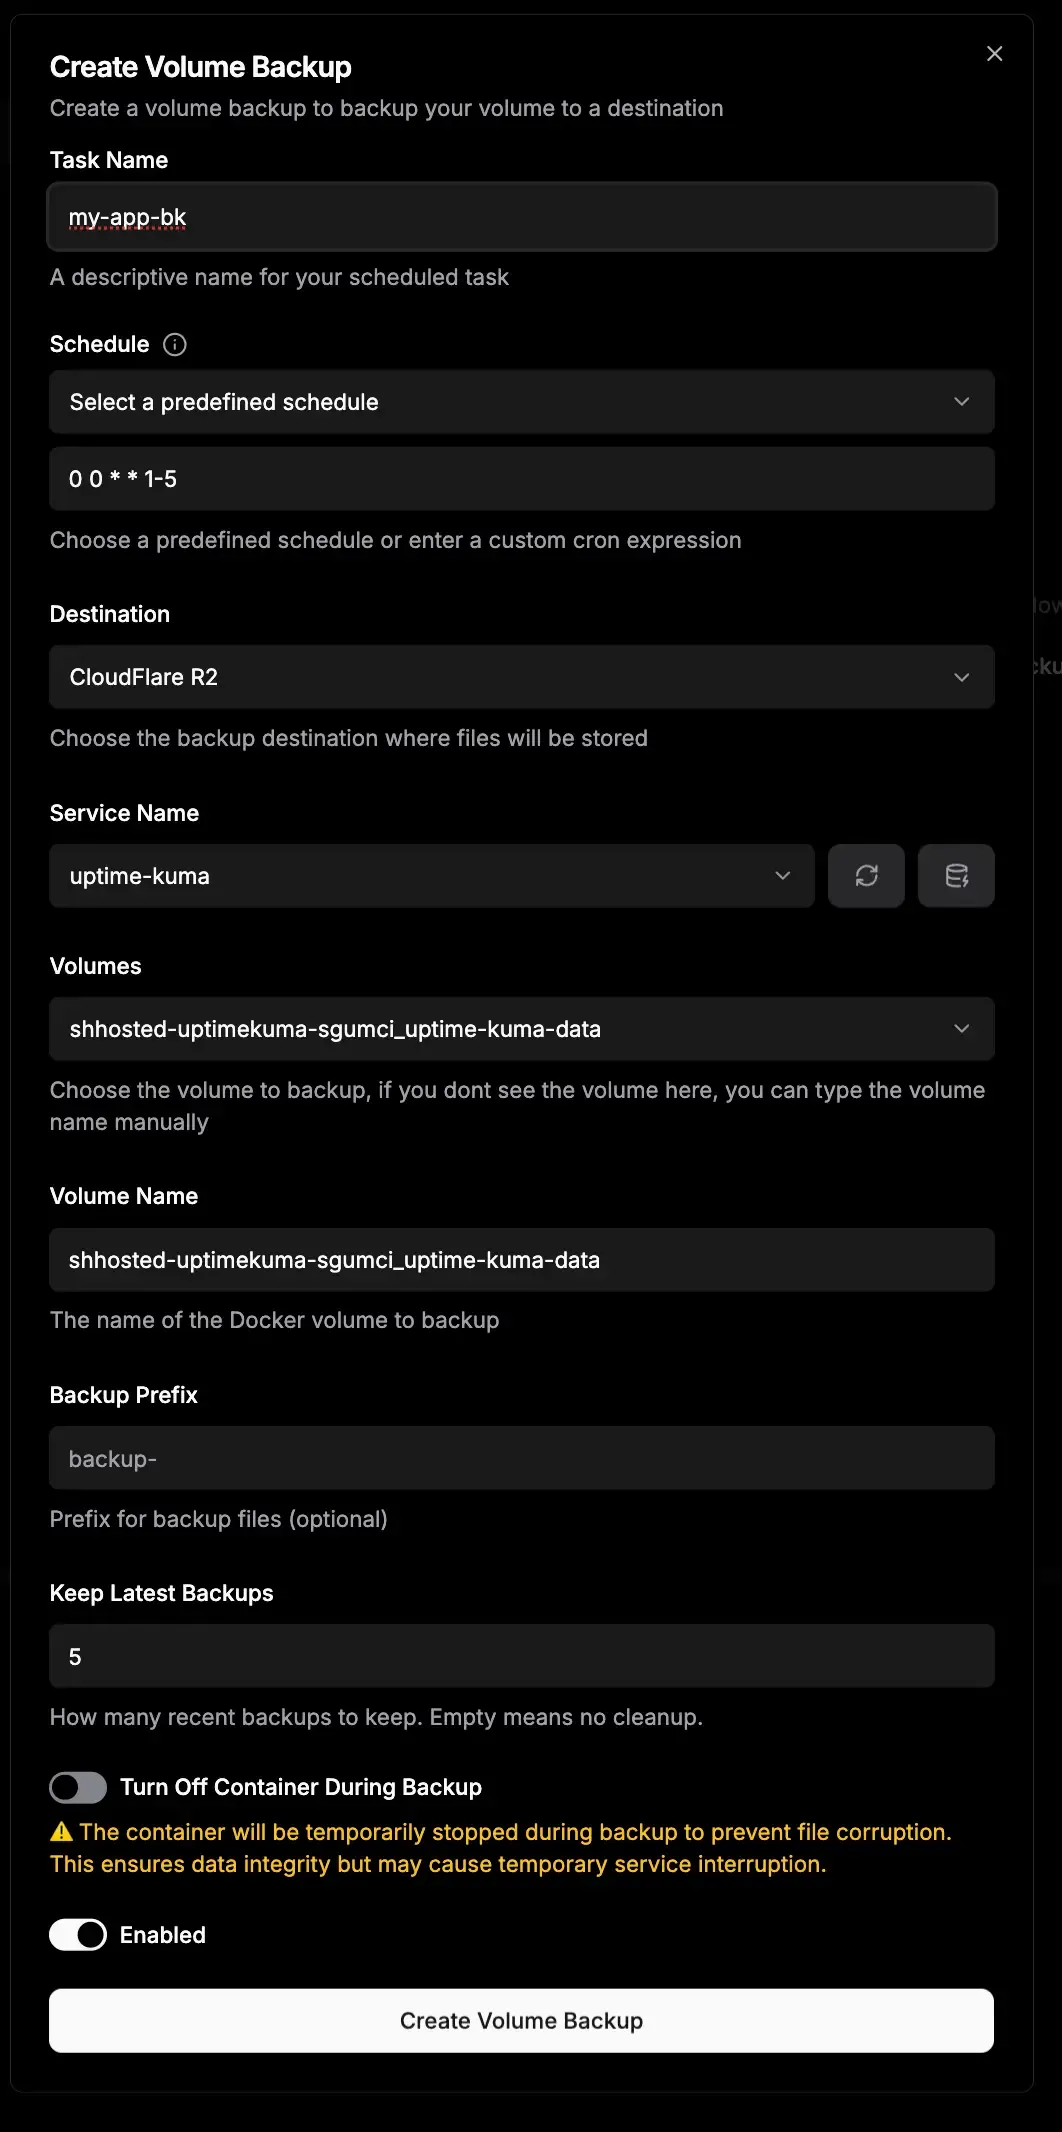
Configura el backup de volumen
- Abre la aplicación o el servicio compose en Dokploy.
- Ve a la sección Volume Backups y haz clic en Create Volume Backup.
- Rellena:
| Ajuste | Valor | Notas |
|---|---|---|
| Name | n8n-daily-backup |
Etiqueta para esta entrada |
| Schedule | 0 3 * * * |
Diario a las 03:00 |
| Destination | Cloudflare R2 Backups | Tu destino S3 |
| Service Name | n8n |
Se autocompleta desde los servicios del compose |
| Volume Name | n8n_data |
Se autorrellena tras elegir el servicio |
| Backup Prefix | n8n-volumes |
Carpeta opcional en el bucket |
| Turn off Container | Activado | Recomendado, ver abajo |
| Keep latest count | 7 |
Poda los objetos antiguos |
| Enabled | Activado |
Contenedor apagado o encendido durante el backup
Apagar el contenedor durante el backup (recomendado)
Lo que te da: consistencia. Dokploy para el contenedor con elegancia, copia el volumen mientras nada escribe, sube y vuelve a arrancar el contenedor.
Lo que cuesta: caída mientras se sube el archivo: segundos para un volumen pequeño, un par de minutos para uno de varios GB, y la velocidad de subida de tu VPS a R2 decide la mayor parte. Prográmalo a las 03:00 y nadie lo nota.
Úsalo para: apps basadas en SQLite, cualquier cosa con bases de datos embebidas, datos de producción con los que prefieres no apostar. SQLite respaldado mientras un contenedor escribe puede producir un archivo que abre y luego falla a mitad de consulta, lo cual es peor que no tener backup porque vas a confiar en él.
Mantener el contenedor corriendo durante el backup
Lo que te da: sin caída, ejecuciones más rápidas, sin efectos colaterales del reinicio.
Lo que arriesga: archivos capturados a mitad de escritura, bases de datos embebidas capturadas en un estado inconsistente y una restauración que falla en el peor momento posible. Los archivos grandes en plena escritura son el caso clásico: te llevas un blob truncado que solo falla cuando la app intenta leerlo.
Úsalo para: contenido estático que cambia poco, entornos de desarrollo y apps cuyo almacenamiento es genuinamente append-only.
Mitigaciones si no te queda otra: programa en la hora más tranquila que tengas, usa la función de exportación propia de la app y prueba las restauraciones con calendario en lugar de asumir.
Encontrar el nombre de volumen correcto
Para servicios Docker Compose, Dokploy nombra los volúmenes con el patrón {appName}_{volumeName}.
App: n8n-kqlble   Volume: n8n_data   ->  n8n-kqlble_n8n_data
App: memos-prod   Volume: memos_data ->  memos-prod_memos_data
Comprueba con Docker en lugar de adivinar:
# on the VPS
docker volume ls | grep n8n
Para aplicaciones de un solo contenedor, el nombre del volumen suele ser el que pusiste en Advanced → Mounts.
Apps que pertenecen a los backups de volúmenes
| Aplicación | Contenido del volumen | Prioridad |
|---|---|---|
| n8n | base de datos SQLite, credenciales, workflows | Alta, diaria |
| Memos | base de datos SQLite, adjuntos | Alta, diaria |
| Plausible Analytics | datos de ClickHouse | Alta, diaria |
| Umami | base de datos SQLite | Media, diaria |
| FileBrowser | subidas y su propia base de datos | Alta, diaria |
| Uptime Kuma | base de datos SQLite (toda tu config de monitores) | Alta, diaria |
| Docmost | subidas y base de datos | Alta, diaria |
| Stirling PDF | archivos temporales | Baja, semanal |
| Redis / Valkey | archivo de volcado si la persistencia está activa | Alta si dependes de él |
| libSQL / bases de datos estilo Turso | directorio de datos | Alta, diaria |
Si guarda estado y no está en un motor de base de datos volcable, pertenece a esta lista.
Paso 6: Verifica que los backups corren de verdad
Un backup sin verificar es una hipótesis. Tres comprobaciones, de la más barata a la menos.
6.1 Mira en el bucket
aws s3 ls "s3://dokploy-backups/" \
  --endpoint-url "https://<account-id>.r2.cloudflarestorage.com" \
  --recursive --human-readable --summarize
Quieres: un objeto por entrada de backup por tick de programación, marcas de tiempo que coincidan con el cron que pusiste y tamaños de archivo que hayan dejado de crecer. Los objetos de cero bytes son fallos disfrazados de éxito.
6.2 Revisa los propios logs de Dokploy
# Dokploy runs as a Swarm service on current versions
docker service logs dokploy --tail 200 | grep -i -E "backup|s3|error"

# its Postgres
docker service logs dokploy-postgres --tail 100
Así se ve lo roto: ENOENT, AccessDenied, SignatureDoesNotMatch, ETIMEDOUT, o un trabajo de backup que empieza y nunca registra finalización. Si ni siquiera los contenedores se llaman como esperas, revisa docker ps: una instalación actual muestra dokploy, dokploy-postgres y dokploy-traefik. Redis desapareció de las instalaciones autoalojadas desde la v0.29.9, así que un contenedor dokploy-redis significa versión vieja.
6.3 Alerta sobre un backup viejo
El modo de fallo que duele es el silencioso: el cron deja de correr, nadie se entera en dos meses y entonces necesitas el archivo. Este script comprueba que el objeto más reciente es más joven que tu intervalo esperado más largo y empuja el resultado a Uptime Kuma.
#!/usr/bin/env bash
# /usr/local/bin/check-dokploy-backups.sh
set -euo pipefail

BUCKET="dokploy-backups"
ENDPOINT="https://<account-id>.r2.cloudflarestorage.com"
MAX_AGE_HOURS=30
PUSH_URL="https://uptime.example.com/api/push/<monitor-token>"

newest=$(aws s3api list-objects-v2 \
  --bucket "$BUCKET" \
  --endpoint-url "$ENDPOINT" \
  --query 'reverse(sort_by(Contents,&LastModified))[0].LastModified' \
  --output text)

if [ -z "$newest" ] || [ "$newest" = "None" ]; then
  curl -fsS "$PUSH_URL?status=down&msg=no-backup-objects" >/dev/null || true
  exit 1
fi

age_hours=$(( ( $(date +%s) - $(date -d "$newest" +%s) ) / 3600 ))

if [ "$age_hours" -gt "$MAX_AGE_HOURS" ]; then
  curl -fsS "$PUSH_URL?status=down&msg=newest-backup-${age_hours}h-old" >/dev/null || true
  exit 1
fi

curl -fsS "$PUSH_URL?status=up&msg=newest-backup-${age_hours}h-old" >/dev/null
Ejecútalo cada hora:
0 * * * * /usr/local/bin/check-dokploy-backups.sh >> /var/log/dokploy-backup-check.log 2>&1Notas antes de desplegarlo: necesita la CLI aws y las credenciales de R2 en el entorno (date -d es GNU; macOS necesita gdate). Si prefieres no instalar la AWS CLI en el host, ejecuta el mismo script desde un contenedor. Luego añade un monitor de tipo push en Uptime Kuma y deja que te avise. El montaje está cubierto en Monitoriza tu servidor con Beszel y Uptime Kuma, y puedes revisar tendencias de disco y contenedores a la vez con la monitorización de recursos de servidor y Docker.
Prueba restauraciones, no solo backups
Pon una cita recurrente en el calendario: una vez al mes, restaura un backup de base de datos en una base de datos de pruebas y comprueba un par de recuentos de filas. Una vez al trimestre, restaura un backup completo del sistema Dokploy en un VPS desechable. Un backup que nunca has restaurado es un archivo, no un plan de recuperación.
Paso 7: Restaura los backups
Restaura el sistema Dokploy
Para recuperación ante desastres o migración de servidor.
La restauración del sistema es destructiva
Restaurar reemplaza el estado actual por el del backup: el directorio /etc/dokploy existente se vacía y se sustituye, la base de datos dokploy-postgres se elimina y se recrea desde el archivo, y los usuarios conectados se desconectan. Todo lo creado después del backup que restaures desaparece. Elige la marca de tiempo a propósito.
- Ve a Web Server → Backups y haz clic en Restore Backup.
- Elige el destino S3 que contiene el backup.
- Navega o busca el archivo de backup que quieres.
- Revisa el resumen de lo que se restaurará.
- Confirma y espera. Cuenta con unos minutos.
- Al completar puede que se cierre tu sesión; vuelve a entrar y comprueba que tus aplicaciones, variables de entorno y destinos están presentes. Si el enrutado se ve mal, reinicia Traefik:
docker restart dokploy-traefik.
Migrar a un servidor distinto:
Lista de comprobación de la migración
- Actualiza la IP del servidor en Web Server → Server → Update IP.
- Arregla el DNS para que tus registros A apunten a la nueva IP, y espera la propagación.
- Recrea los dominios Traefik.me si los usabas; siguen la IP del servidor y hay que recrearlos en los ajustes de la app.
- Reconfigura los proveedores Git si algún webhook o integración se configuró con una IP en crudo en lugar de un hostname. Los proveedores basados en dominio no necesitan nada.
- Espera los certificados. Traefik aprovisiona certificados Let’s Encrypt nuevos en el host nuevo; dale unos minutos antes de decidir que HTTPS está roto.
- Prueba las conexiones de base de datos desde cada aplicación, y actualiza las cadenas de conexión que referencien el host viejo.
- Visita la URL de cada app y revisa los logs buscando errores. Un stack restaurado con un contenedor roto es el resultado normal de una migración con prisas.
Restaura una base de datos
- Abre Databases, selecciona la base de datos, ve a la pestaña Backup.
- Haz clic en Restore.
- Elige el bucket S3 de origen, empieza a escribir el nombre del archivo y el campo autocompleta desde lo que hay en el bucket.
- Si usas prefijos, escribe el prefijo para acotar: teclear
prod-db/autocompleta aprod-db/postgres-backup-2026-09-14-06-00.sql.gz. - Confirma el nombre de la base de datos y ejecuta la restauración.
Qué pasa: la base de datos actual se elimina, el backup se descarga de R2 y se restaura, y los permisos se reaplican. Las aplicaciones conectadas darán errores brevemente y normalmente se reconectan solas; si la tuya no lo hace, reinicia el contenedor de la app.
Las restauraciones solo están garantizadas para los volcados propios de Dokploy
Dokploy elige el comando de restauración según cómo creó el backup. Un .sql.gz que generaste a mano, o un volcado de otra versión de pg_dump, puede no funcionar por la vía automatizada. En caso de duda, descarga el archivo y restaura manualmente:
gunzip -c prod-db-backup.sql.gz | docker exec -i <postgres-container> \
  psql -U postgres -d appdb
Restaura un volumen
- Abre la aplicación o el servicio compose, encuentra Volume Backups, haz clic en Restore Volume.
- Elige el destino y el archivo de backup concreto.
- Introduce el nombre del volumen de destino. Para servicios compose es el
{appName}_{volumeName}completo, por ejemplon8n-kqlble_n8n_data. Unn8n_dataa secas fallará.
Precondiciones de la restauración de volúmenes
El volumen de destino no debe existir ni estar en uso. Para los contenedores que lo usan, elimina el volumen y luego restaura. Respalda primero el volumen actual si hay cualquier posibilidad de que estés restaurando el archivo equivocado.
# 1. stop the stack (or use the Dokploy UI)
docker compose -f /opt/stacks/n8n-kqlble/docker-compose.yml down

# 2. confirm nothing still references the volume
docker volume ls | grep n8n

# 3. remove the old volume - this deletes its data
docker volume rm n8n-kqlble_n8n_data

# 4. restore from the Dokploy UI (Volume Backups -> Restore Volume)

# 5. bring the stack back up
docker compose -f /opt/stacks/n8n-kqlble/docker-compose.yml up -d
Luego verifica: logs del contenedor limpios, la app carga, y los datos que restauraste están realmente ahí (abre un workflow en n8n, comprueba que existe un archivo subido). “El contenedor arrancó” no es verificación.
Paso 8: Automatiza destinos y programaciones con la API
Todo lo que puedes clicar, lo puedes llamar. Eso importa cuando gestionas más de un host Dokploy y quieres la configuración de backups en control de versiones en lugar de en tu memoria.
Consigue una clave de API en los ajustes de tu cuenta de Dokploy y envíala en la cabecera x-api-key. Trátala como una credencial de root: puede crear destinos, lo que significa que puede repartir acceso de escritura a tu bucket de backups.
export DOKPLOY_URL="https://app.example.com"
export DOKPLOY_API_KEY="<your api key>"

# what destinations already exist?
curl -sS "$DOKPLOY_URL/api/destination.all" \
  -H "x-api-key: $DOKPLOY_API_KEY" | jq
Crea el destino R2. Los valores son los mismos que escribirías en la UI. Ojo: el interruptor Force Path Style se guarda como una entrada del array additionalFlags, y Dokploy no documenta la cadena exacta, así que la forma fiable de averiguarla es crear el destino una vez en la UI y leerlo de vuelta:
# 1. create the destination in the UI, then read back exactly what Dokploy stored
curl -sS "$DOKPLOY_URL/api/destination.all" \
  -H "x-api-key: $DOKPLOY_API_KEY" | jq '.[] | select(.name=="Cloudflare R2 Backups")'
Con ese valor en la mano, aprovisionar un segundo host queda así:
export R2_ACCESS_KEY_ID="<r2 access key id>"
export R2_SECRET_ACCESS_KEY="<r2 secret access key>"

curl -sS -X POST "$DOKPLOY_URL/api/destination.create" \
  -H "x-api-key: $DOKPLOY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "name": "Cloudflare R2 Backups",
    "provider": "cloudflare",
    "accessKey": "'"$R2_ACCESS_KEY_ID"'",
    "secretAccessKey": "'"$R2_SECRET_ACCESS_KEY"'",
    "bucket": "dokploy-backups",
    "region": "WEUR",
    "endpoint": "https://<account-id>.r2.cloudflarestorage.com",
    "additionalFlags": ["<flag string your instance uses>"]
  }'
Pruébalo también desde la API. destination.testConnection acepta el mismo cuerpo que destination.create:
curl -sS -X POST "$DOKPLOY_URL/api/destination.testConnection" \
  -H "x-api-key: $DOKPLOY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "name": "Cloudflare R2 Backups",
    "provider": "cloudflare",
    "accessKey": "'"$R2_ACCESS_KEY_ID"'",
    "secretAccessKey": "'"$R2_SECRET_ACCESS_KEY"'",
    "bucket": "dokploy-backups",
    "region": "WEUR",
    "endpoint": "https://<account-id>.r2.cloudflarestorage.com",
    "additionalFlags": ["<flag string your instance uses>"]
  }'
Crea una programación de backup de base de datos:
curl -sS -X POST "$DOKPLOY_URL/api/backup.create" \
  -H "x-api-key: $DOKPLOY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "schedule": "0 */6 * * *",
    "enabled": true,
    "prefix": "prod-db",
    "destinationId": "<destinationId>",
    "keepLatestCount": 7,
    "database": "appdb",
    "databaseType": "postgres",
    "postgresId": "<postgresId>"
  }'
databaseType acepta postgres, mysql, mariadb, mongo, libsql y web-server (el backup del sistema). backupType puede ser database o compose, este último con un serviceName cuando el backup pertenece a un servicio compose. La API también expone includeEncryptionKey para el backup del sistema de Dokploy. Si esa copia es tu recuperación ante desastres para un servidor nuevo de cero, déjala activada; si no, las variables de entorno que Dokploy guardó cifradas podrían no ser legibles en la instalación restaurada.
Crea una entrada de backup de volumen (turnOff es el interruptor que para el contenedor):
curl -sS -X POST "$DOKPLOY_URL/api/volumeBackups.create" \
  -H "x-api-key: $DOKPLOY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "name": "n8n-daily-backup",
    "volumeName": "n8n-kqlble_n8n_data",
    "prefix": "n8n-volumes",
    "serviceType": "compose",
    "appName": "n8n-kqlble",
    "serviceName": "n8n",
    "turnOff": true,
    "cronExpression": "0 3 * * *",
    "keepLatestCount": 7,
    "enabled": true,
    "destinationId": "<destinationId>"
  }'
serviceType acepta application, postgres, mysql, mariadb, mongo, redis, compose y libsql.
Ejecuta cosas ahora en lugar de esperar al cron, útil justo antes de una migración:
# force a Postgres backup
curl -sS -X POST "$DOKPLOY_URL/api/backup.manualBackupPostgres" \
  -H "x-api-key: $DOKPLOY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"backupId": "<backupId>"}'

# force a volume backup
curl -sS -X POST "$DOKPLOY_URL/api/volumeBackups.runManually" \
  -H "x-api-key: $DOKPLOY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"volumeBackupId": "<volumeBackupId>"}'
Hay endpoints manuales equivalentes para MySQL, MariaDB, MongoDB y el servidor web, más backup.listBackupFiles, que es el mismo listado que lee el selector de restauración:
curl -sS -G "$DOKPLOY_URL/api/backup.listBackupFiles" \
  -H "x-api-key: $DOKPLOY_API_KEY" \
  --data-urlencode "destinationId=<destinationId>" \
  --data-urlencode "search=prod-db/"
Dos notas de operador. Primera, create no es idempotente: ejecuta tu script de aprovisionamiento dos veces y obtienes dos destinos y dos programaciones. Comprueba destination.all primero, o deja el script como un bootstrap de un solo uso. Segunda, las claves de API tienen alcance de cuenta y viven mucho, así que guárdalas en un gestor de secretos o en un archivo env con chmod 600, nunca en el repo junto a los compose.
Retención, matemáticas de almacenamiento y la regla 3-2-1
La regla 3-2-1 sigue vigente:
- 3 copias de los datos: producción más dos backups
- 2 soportes o plataformas distintas: por ejemplo el disco del VPS más almacenamiento de objetos compatible con S3
- 1 offsite, en un proveedor distinto: Cloudflare R2 en este montaje
Un plan de retención que cabe en el nivel gratuito:
| Tipo de backup | Frecuencia | Retención | Objetos conservados |
|---|---|---|---|
| Base de datos (producción) | cada 6 horas | 7 días | unos 28 |
| Sistema Dokploy | diario | 7 días | 7 |
| Volumen (n8n, Kuma, Memos) | diario | 7 días | 7 cada uno |
| Archivo semanal | domingo | 4 semanas | 4 |
Pon keepLatestCount en cada entrada para que Dokploy pode por ti, y considera una regla de ciclo de vida de R2 en el bucket como segunda red (por ejemplo, caducar objetos de más de 30 días en un prefijo concreto). Dos podadores independientes son mejores que un script olvidado.
Matemáticas aproximadas de almacenamiento para un stack autoalojado pequeño:
Dokploy system backup:   10 MB x 7 days        =   70 MB
Database backups:        50 MB x 4/day x 7     = 1400 MB
n8n volume:             200 MB x 7 days        = 1400 MB
Other volumes:          100 MB x 7 days        =  700 MB
--------------------------------------------------------
Total:                                         ~3.5 GB
Eso cabe en el nivel gratuito de R2 con espacio de sobra. Si tus volúmenes son grandes, la presión viene de los backups de volúmenes, no de las bases de datos. Una biblioteca de fotos montada como volumen nombrado superará los 10 GB mucho antes que tus volcados de Postgres. Comprime o excluye lo que puedas, y recuerda que bajar los datos de vuelta es gratis.
Seguridad y cifrado
- Un token por propósito. Un token para los backups de Dokploy, con alcance a un bucket, que se pueda borrar sin tocar nada más.
- Sin acceso público. Los buckets de R2 son privados por defecto; no actives buckets públicos ni una URL dev pública en tu bucket de backups “solo para comprobar algo”.
- Rota con calendario. Tokens en un gestor de contraseñas con un recordatorio en el calendario ganan a tokens que nadie vuelve a mirar.
- Sabe dónde viven las claves. Dokploy guarda las credenciales de destino en su propia base de datos Postgres, en columnas en claro. Cualquiera con acceso a la base de datos tiene tus claves de R2, otra razón para que el token tenga alcance de bucket y solo lectura/escritura en ese bucket.
- Cifra lo que sale de la máquina, si los datos lo justifican. R2 cifra en reposo, pero Cloudflare puede leer técnicamente tus objetos. Si eso importa:
# encrypt before upload, store the passphrase in your password manager
gpg --symmetric --cipher-algo AES256 backup-file.zip
# produces backup-file.zip.gpg
El cifrado simétrico significa que debes guardar la frase de paso en algún sitio al que sigas teniendo acceso durante un apagón. Una frase de paso solo en el .bash_history del mismo VPS no es un plan.
- TLS en todas partes. Los endpoints de R2 son solo HTTPS y el destino de Dokploy los usa tal cual. No insertes un proxy que degrade.
- Audita el acceso de vez en cuando. Cloudflare muestra el uso de los tokens de R2; Dokploy guarda sus propios logs. Si tú no ejecutaste una restauración, nadie debería estar leyendo ese bucket.
Si también estás endureciendo el lado del host, securizar un servidor Docker tras un informe del BSI cubre el trabajo de firewall y exposición que debería venir antes de todo esto.
Resolución de problemas comunes
El backup termina pero no aparece nada en R2
- Vuelve a ejecutar el Test Connection del destino, y luego comprueba la ruta de escritura con el listado de la AWS CLI del paso 1.4.
- Confirma que el nombre del bucket es exactamente correcto: distingue mayúsculas.
- Confirma que la región coincide con la pista de ubicación del bucket (
WEUR,ENAM,WNAM,APAC). - Confirma que el endpoint es el endpoint de tu cuenta sin ruta de bucket añadida.
- Confirma que Force Path Style está activado. Sin él el test puede pasar y las subidas seguir fallando.
- Revisa los permisos del token: Object Read & Write, con alcance a este bucket.
docker service logs dokploy --tail 300 | grep -i -E "backup|s3|denied|error"Los backups corrían ayer y hoy no
Revisa primero la expresión cron, porque una errata tipo * * * * * en el campo equivocado es el clásico. Luego comprueba que la entrada sigue Enabled y que el servicio Dokploy está realmente arriba (docker ps). Si se supone que los backups corren con el host apagado, no lo harán: el planificador vive dentro de Dokploy.
El backup tarda demasiado o expira
# how big is the volume, really?
docker system df -v | grep <volume-name>
Volúmenes grandes más una subida lenta es la respuesta habitual, y no hay arreglo ingenioso: divide el volumen, deja de respaldar datos de descarte o acepta la ventana. Subir 50 GB por un enlace de 100 Mbit tarda más de una hora diga lo que diga el panel.
La restauración falla
df -h: la falta de espacio en disco es la causa más común, y el mensaje de error menos obvio.- Confirma que nada usa el volumen o la base de datos de destino (
docker ps,docker volume ls). - Confirma que el archivo está íntegro: descárgalo y ejecuta la comprobación de gzip/pg_restore del Paso 4.
- Para bases de datos, confirma que Dokploy puede eliminar y crear bases de datos en esa instancia:
docker exec -it dokploy-postgres psql -U postgres -lLa UI de Dokploy está caída porque el disco se llenó
Un disco lleno pone la base de datos Postgres de Dokploy en modo de recuperación y el panel deja de responder. Los backups que has ido acumulando en local, más las imágenes huérfanas, son los culpables habituales:
docker system prune -a
docker builder prune -a
docker image prune -a
Luego confirma que los contenedores están todos arriba:
docker ps # expect dokploy, dokploy-postgres, dokploy-traefikSi el servicio Dokploy está arriba pero no alcanza su base de datos (getaddrinfo ENOTFOUND dokploy-postgres en los logs), reinícialo:
docker service scale dokploy=0
docker service scale dokploy=1
La UI no vuelve tras una restauración
docker service logs dokploy --tail 200
docker service logs dokploy-postgres --tail 100
docker logs dokploy-traefik --tail 100
Los errores de Traefik suelen apuntar a un archivo de configuración bajo /etc/dokploy/traefik/dynamic/, que la restauración acaba de reemplazar. Una sola clave inválida (la documentación usa como ejemplo un passHostHeader ausente) tumba todo el enrutado. Arregla el archivo y luego docker restart dokploy-traefik.
Errores de cuota de R2 al pasar de 10 GB
- Revisa el uso actual en el panel de Cloudflare.
- Pon
keepLatestCounten cada entrada que no lo tenga. - Añade una regla de ciclo de vida para caducar objetos en prefijos viejos.
- Reduce la frecuencia donde los datos no justifiquen cada-6-horas.
- Si aún necesitas más, el nivel de pago cuesta unos 1,50 $ por 100 GB al mes, sin cargos de egress. Compra el almacenamiento en lugar de degradar el backup.
Preguntas frecuentes
¿Un backup del sistema Dokploy incluye los datos de mis aplicaciones?
No. El backup del sistema contiene la base de datos dokploy-postgres y /etc/dokploy: tu configuración de Dokploy, usuarios, destinos e historial de despliegues. Las bases de datos de las aplicaciones necesitan sus propias entradas de backup de base de datos, y los volúmenes necesitan backups de volúmenes. Trata los tres como tres trabajos separados y no descubrirás el hueco durante una restauración.
¿Puedo respaldar un bind mount como ../files/my-data?
No con Volume Backups. Dokploy solo respalda volúmenes nombrados de Docker. Si tu compose monta ../files/..., esos datos quedan fuera del sistema de backup por completo, sin aviso en la UI. Migra el servicio a un volumen nombrado y luego configura el backup. Ver el Paso 5 para la forma de la migración.
¿Qué pasa con los backups viejos cuando se fija la cantidad a conservar?
Dokploy poda los objetos del prefijo de ese backup para que solo queden los keepLatestCount más recientes. Es por entrada de backup, así que una base de datos de producción que conserva 7 y una de dev que conserva 1 pueden compartir un bucket sin pisarse. Los prefijos del bucket son la frontera, así que no apuntes dos entradas al mismo prefijo con retención distinta y luego te preguntes cuál ganó.
¿Los backups siguen corriendo si Dokploy o el servidor están caídos?
No. La programación la ejecuta el servicio Dokploy en tu host. Servidor apagado, Dokploy enfermo, disco lleno: no hay backup, ni alerta a menos que añadas una. Es exactamente por eso que el Paso 6 añade una comprobación externa de vejez con Uptime Kuma. Además, haz un backup manual antes de actualizar en lugar de fiarte de que el siguiente tick del cron te cubra.
¿Puedo restaurar un backup en un servidor distinto?
Sí, ese es el camino de migración. Restaura el backup del sistema en el host nuevo, luego actualiza la IP en Web Server → Server → Update IP, arregla el DNS, recrea los dominios Traefik.me que uses, actualiza los proveedores Git que usaran IPs en crudo y dale a Traefik unos minutos para emitir certificados. La lista completa está en el Paso 7.
¿El nivel gratuito de R2 basta para un stack pequeño?
Normalmente sí. Los archivos del sistema Dokploy son de decenas de MB, los volcados de bases de datos comprimen bien y un puñado de volúmenes pequeños caben cómodamente en 10 GB con una semana de retención. Vigila los backups de volúmenes si guardas contenido multimedia, porque de ahí vienen los gigabytes. Por encima del nivel gratuito pagas céntimos por gigabyte con egress gratis, así que es un problema barato de tener.
¿Debería usar también reglas de ciclo de vida de R2 además de la cantidad a conservar de Dokploy?
Sí, como red de seguridad. Dokploy poda por entrada de backup según keepLatestCount; una regla de ciclo de vida de R2 en el bucket atrapa lo que se quede atrás: una entrada de backup borrada, un prefijo que dejaste de usar, una poda fallida. Dos mecanismos de limpieza independientes no cuestan nada y evitan la sorpresa de disco/cuota.
Conclusión
Ahora tienes una cadena de backups que funciona para una máquina Dokploy autoalojada: un bucket en otro proveedor, un destino S3 probado, programaciones con retención integrada para la propia instancia de Dokploy, cada base de datos y cada volumen nombrado, más procedimientos de restauración y una comprobación externa que mantiene honesto a todo el conjunto.
Ideas clave
- Tres tipos de backup separados: sistema Dokploy, bases de datos, volúmenes. Ninguno cubre a los otros.
- Los backups de volúmenes necesitan volúmenes nombrados de Docker. Los bind mounts son invisibles para la función.
- Pon
keepLatestCounten cada entrada, y luego añade una regla de ciclo de vida de R2 como segunda red. - Guarda los backups en un proveedor distinto al de tu VPS, que es todo el punto de usar R2 aquí.
- Nada corre hasta que activas una programación, y el planificador vive dentro de Dokploy, así que alerta externamente sobre backups viejos.
- Prueba restauraciones en calendario, no el día que las necesitas. Una restauración mensual de base de datos y un simulacro trimestral de restauración del sistema bastan.
Siguientes pasos
- Activa la comprobación de vejez del Paso 6 y déjala correr una semana antes de fiarte de ella.
- Haz una restauración mensual de base de datos en una base de datos de pruebas y apunta cuánto tardó.
- Haz una restauración completa del sistema trimestral en un VPS desechable. Una máquina barata de 2 vCPU basta para el simulacro.
- Escribe el orden de restauración de tu stack (primero la config de Dokploy, luego bases de datos, luego volúmenes) y guárdalo donde puedas encontrarlo cuando tu panel esté caído.
Recursos relacionados
Si estás montando el resto del stack, estas son las guías que combinan con esta:
- Instala Dokploy en un VPS: el montaje base, endurecimiento y rutina de actualización
- Despliega una app Docker Compose en Dokploy: volúmenes nombrados, montajes y servicios
- Actualiza stacks de Docker Compose en Dokploy: la operación que hace que los backups importen
- Despliega TanStack Start en Dokploy: una app real con una base de datos real
- Varias bases de datos PostgreSQL en un solo servicio: cuando una instancia aloja varias apps
- Pluton: backups autoalojados con restic y rclone: una segunda ruta de backup independiente
- Zerobyte: interfaz gráfica de Restic para automatizar backups: si quieres retención y dedupe gestionados por ti
- Monta un bucket S3 como sistema de archivos: útil cuando necesitas inspeccionar los backups como archivos
- Monitoriza con Beszel y Uptime Kuma: la mitad de alertas de este montaje
- Coolify vs Dokploy vs Kamal 2: si aún estás eligiendo panel
Configura el backup, luego rompe algo a propósito y restaúralo. Esa es la única prueba que cuenta.