Despliega PGvector y PGAdmin en Docker y Olvídate de Pinecone
Despliega PGvector y PGAdmin con Docker Compose y ejecuta tu propia base de datos vectorial. Autoaloja embeddings, evita el mínimo de $50/mes de Pinecone y ahorra en grande.

Actualizado Publicado 25 min de lectura
PGvector convierte PostgreSQL en una base de datos vectorial autoalojada. Te permite almacenar, indexar y consultar embeddings directamente dentro de Postgres en lugar de pagar por un servicio gestionado aparte. PGAdmin te da una interfaz web para administrarla. Juntos en Docker, tienes un stack de base de datos vectorial funcionando en un VPS barato en menos de 10 minutos.
La guía original usaba la imagen Docker ankane/pgvector (abandonada desde 2023) y un formato de Docker Compose desactualizado. Esta actualización corrige todo eso: la imagen oficial pgvector/pgvector:pg17, la sintaxis actual de Compose, mejoras de seguridad y pasos de verificación que al original le faltaban.
Si has estado pagando por Pinecone u otra base de datos vectorial gestionada, esta es la guía que te permite cancelar esa factura.
Sobre el video de abajo
El video se grabó con una versión antigua del stack (imagen ankane/pgvector, Docker Compose v1). La guía escrita de abajo tiene los pasos completamente actualizados.
¿Qué es PGvector? PostgreSQL como base de datos vectorial
PGvector es una extensión de Postgres que añade búsqueda por similitud vectorial a cualquier base de datos PostgreSQL. Soporta búsqueda de vecinos más cercanos exacta y aproximada con indexación HNSW e IVFFlat, operadores de distancia para L2, coseno y producto interno, y hasta 16.000 dimensiones por vector (la indexación HNSW soporta hasta 2.000 en precisión completa, 4.000 con halfvec, 64.000 con bit).
Con más de 22.000 estrellas en GitHub, pgvector se ha convertido en la opción por defecto para equipos que quieren búsqueda vectorial sin ejecutar un servicio aparte. El argumento de «una base de datos para todo» es sólido: tus datos relacionales y tus embeddings viven en la misma instancia de Postgres. Misma estrategia de backups, mismos controles de acceso, mismo stack de monitorización. Sin facturación aparte, sin API keys aparte.
Casos de uso comunes:
- Pipelines RAG: almacena embeddings de OpenAI o de LLMs locales y recupera contexto relevante para aumentar las respuestas de IA.
- Búsqueda semántica: encuentra documentos, productos o tickets de soporte similares por distancia vectorial en lugar de coincidencia de palabras clave.
- Recomendaciones: empareja usuarios con elementos según la similitud de embeddings.
- Búsqueda de imágenes/audio: compara embeddings multimodales de CLIP o modelos similares.
Para mayor escala, la extensión pgvectorscale de TimescaleDB añade indexación StreamingDiskANN sobre pgvector. No es necesaria para la mayoría de los setups, pero ahí está cuando te quedes corto con el HNSW básico.
Soporte de versiones de PostgreSQL
pgvector 0.8.5 (julio de 2026) soporta PostgreSQL 13 y posteriores (incluido PG 18). El soporte para PostgreSQL 12 se eliminó en pgvector 0.8.0. Esta guía usa la imagen pgvector/pgvector:pg17, que incluye PostgreSQL 17 con pgvector 0.8.5.
¿Por qué dejar Pinecone? Precios actualizados y comparativa de costes
El enfoque de «dejar Pinecone» ya era relevante en 2024 cuando se publicó este artículo por primera vez. Desde entonces se ha reforzado. En octubre de 2025, Pinecone introdujo un mínimo de $50/mes en su plan Standard. Ese cambio eliminó de hecho el caso de uso para aficionados y puso a la comunidad de bases de datos vectoriales a buscar alternativas.
El mínimo de $50/mes de Pinecone vs pgvector autoalojado
Aquí van las cuentas de costes:
| Setup | Coste mensual | Qué obtienes |
|---|---|---|
| Pinecone Starter (gratis) | $0 | 2 GB de almacenamiento, 1M de unidades de lectura/mes, 5 índices, solo soporte comunitario |
| Pinecone Builder | $20/mes | Nivel para desarrollador individual con límites de uso |
| Pinecone Standard | $50/mes | Uso en producción, con precio por unidad encima: $8.25/M lecturas, $2.00/M escrituras |
| pgvector autoalojado en Hetzner CX22 | ~€5/mes | Consultas ilimitadas, índices ilimitados, tus datos en tu servidor |
Los precios de los VPS subieron en todos los proveedores en 2026 — si estás reconsiderando un servidor alquilado, mira qué cambió y cuándo gana un mini PC.
Un Hetzner CX22 (2 vCPU, 4 GB de RAM, 40 GB NVMe) por ~€5/mes o un plan KVM de Hostinger VPS maneja pgvector con miles de embeddings sin cargos por consulta. Sin límites de uso. Sin facturas sorpresa. También puedes mirar Vultr para opciones de datacenters globales.
El ahorro se acumula: el precio serverless de Pinecone añade $0.33/GB/mes de almacenamiento más unidades por lectura/escritura. Con tráfico moderado (10M de lecturas/mes), son $82.50 solo en cargos de lectura encima de la tarifa base. ¿pgvector en un VPS? Los mismos €5–15/mes fijos sin importar el volumen de consultas.
Desplegar en HetznerDependencia del proveedor, latencia y otros costes ocultos
Más allá del precio, está la realidad operativa:
- Latencia de red: cada consulta vectorial a Pinecone cruza internet. Una consulta a Postgres local llega a localhost. Para pipelines RAG que hacen decenas de búsquedas por petición, eso suma rápido.
- Gestión de API keys: Pinecone requiere API keys, atención a los rate limits y manejo de errores para caídas del servicio. pgvector es solo una conexión a Postgres.
- Soberanía de datos: tus embeddings (que a menudo codifican conocimiento empresarial sensible) permanecen en tu infraestructura. Sin acuerdos de procesamiento de datos con terceros.
- Riesgo de precios: Pinecone ya cambió sus precios una vez. Con lo autoalojado, tu coste es lo que cobre tu proveedor de VPS, y puedes cambiar de proveedor cuando quieras.
Si ya ejecutas Docker para tu stack de aplicaciones, también puedes autoalojar tu propia infraestructura con Dokploy o usar una plataforma como servicio autoalojada como Coolify. La cuestión es: tú controlas la factura.
Requisitos previos
Antes de empezar, necesitas:
- VPS Linux con soporte para Docker. Vale cualquier proveedor: Hetzner, Hostinger VPS, Vultr, DigitalOcean o tu propio hardware
- Docker Engine 24+ y Docker Compose v2+ instalados. Verifica con
docker compose version - Acceso básico a terminal/SSH
- (Opcional) Un dominio o subdominio para acceso remoto con Cloudflare Tunnel
- (Opcional) Dockge u otro gestor de contenedores para administrar los archivos compose más fácilmente
Sin Kubernetes, sin bases de datos externas, sin cuentas en la nube. Docker Compose se encarga de todo.
Si buscas una buena oferta de VPS, mira Hetzner para instancias baratas en la UE o Hostinger VPS para opciones económicas globales. Para más ideas de contenedores, consulta nuestra guía de contenedores Docker autoalojados para tu servidor casero.
Variables de entorno (archivo .env)
Crea un archivo .env junto a tu archivo compose. Estas credenciales configuran tanto Postgres como PGAdmin:
POSTGRES_USER=pguser
POSTGRES_PASSWORD=change-me-use-a-strong-password
POSTGRES_DB=vectors
[email protected]
PGADMIN_DEFAULT_PASSWORD=change-me-too
Sustituye las contraseñas de ejemplo por unas reales. Las variables POSTGRES_* configuran la base de datos; las variables PGADMIN_* establecen tu acceso a PGAdmin.
El archivo compose usa la sintaxis ${VAR:-default}, así que si falta una variable se usa un valor por defecto. Pero no confíes en los valores por defecto para las credenciales. Defínelas explícitamente.
Para más información sobre cómo maneja Docker las variables de entorno, consulta variables de entorno en Docker Compose.
No subas el .env al control de versiones
Añade .env a tu .gitignore. Para despliegues en producción, considera proteger tus credenciales de Docker Compose con Docker secrets o un vault.
Archivo Docker Compose para pgvector y PGAdmin
Este es el entregable principal. Copia esto en docker-compose.yml (o compose.yml, ambos funcionan):
docker-compose.yml completo
services:
  db:
    image: pgvector/pgvector:pg17
    container_name: pgvector_db
    restart: unless-stopped
    shm_size: '256mb'
    ports:
      - "127.0.0.1:5432:5432"
    environment:
      POSTGRES_DB: ${POSTGRES_DB:-vector}
      POSTGRES_USER: ${POSTGRES_USER:-user}
      POSTGRES_PASSWORD: ${POSTGRES_PASSWORD}
    volumes:
      - ./local_pgdata:/var/lib/postgresql/data
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U ${POSTGRES_USER:-user} -d ${POSTGRES_DB:-vector}"]
      interval: 5s
      timeout: 5s
      retries: 5
      start_period: 10s

  pgadmin:
    image: dpage/pgadmin4:latest
    container_name: pgadmin4
    restart: unless-stopped
    ports:
      - "5016:80"
    environment:
      PGADMIN_DEFAULT_EMAIL: ${PGADMIN_DEFAULT_EMAIL}
      PGADMIN_DEFAULT_PASSWORD: ${PGADMIN_DEFAULT_PASSWORD}
    user: "${UID:-5050}:${GID:-5050}"
    volumes:
      - ./pgadmin-data:/var/lib/pgadmin
    depends_on:
      db:
        condition: service_healthy
Qué cambió respecto a la versión anterior
Si migras desde el archivo compose del artículo anterior, aquí está cada cambio y el porqué:
| Cambio | Por qué |
|---|---|
ankane/pgvector → pgvector/pgvector:pg17 |
La imagen ankane/pgvector está abandonada (última actualización: octubre de 2023, pgvector 0.5.1). La imagen oficial se movió a la organización pgvector en Docker Hub con pgvector 0.6.0. |
Eliminado version: "3.8" |
El campo version está obsoleto en Compose v2+ y se ignora por completo. Los archivos compose modernos empiezan directamente con services:. |
Añadido shm_size: '256mb' |
Las compilaciones paralelas de índices HNSW (pgvector 0.6.0+) usan memoria compartida. El /dev/shm por defecto de Docker es de 64 MB, lo que provoca fallos durante compilaciones de índices grandes. |
Asociación de puertos 0.0.0.0:5432 → 127.0.0.1:5432 |
No expongas Postgres a internet. PGAdmin se conecta por la red interna de Docker de todas formas. |
Eliminado POSTGRES_HOST_AUTH_METHOD=trust |
Esto desactivaba por completo la autenticación por contraseña. Cualquiera que alcanzara el puerto 5432 podía conectarse sin credenciales. |
Añadido depends_on con condition: service_healthy |
PGAdmin ahora espera a que Postgres esté listo antes de arrancar. Se acabaron las condiciones de carrera en despliegues nuevos. |
Añadido start_period: 10s al healthcheck |
Evita falsos reportes de “unhealthy” durante la inicialización de Postgres. |
Eliminado hostname |
No es necesario con la red moderna de Docker. container_name es suficiente para la identificación. |
docker-compose (con guion) → docker compose (con espacio) |
Docker Compose v1 (docker-compose con guion) se eliminó en abril de 2025. El comando ahora es docker compose. |
Valores por defecto ${VAR:-default} |
El archivo compose no se rompe si falta una variable de entorno. Usa valores por defecto razonables. |
POSTGRES_HOST_AUTH_METHOD=trust era un riesgo de seguridad
El archivo compose antiguo incluía POSTGRES_HOST_AUTH_METHOD=trust, que desactivaba por completo la autenticación por contraseña. Cualquiera que pudiera alcanzar el puerto 5432 podía conectarse sin contraseña. El archivo actualizado lo elimina. Si migras desde el setup antiguo, asegúrate de que POSTGRES_PASSWORD esté definido en tu archivo .env y actualiza cualquier cadena de conexión que dependiera de la autenticación sin contraseña.
La imagen ankane/pgvector está abandonada
La imagen Docker ankane/pgvector no se actualiza desde octubre de 2023 (pgvector 0.5.1). La imagen oficial ahora es pgvector/pgvector en Docker Hub. Usa siempre la imagen de la organización oficial.
¿Por qué asociar Postgres a 127.0.0.1?
Por defecto, Docker mapea los puertos publicados a 0.0.0.0. Eso significa que cualquiera en internet puede alcanzar tu puerto de Postgres si no hay un firewall. Asociar a 127.0.0.1 significa que solo los procesos de la máquina anfitriona (y otros contenedores Docker en la misma red) pueden conectarse.
Esto está bien porque PGAdmin se conecta al servicio db por la red interna de Docker, no por el puerto del host. Si necesitas acceso remoto a Postgres desde otro servidor, usa un túnel SSH o una VPN. Nunca expongas el puerto 5432 directamente a internet.
Desplegar pgvector y PGAdmin con Docker Compose
Con el archivo compose y el .env listos, despliega:
# Descarga las imágenes más recientes
docker compose pull

# Inicia en segundo plano
docker compose up -d

# Verifica que ambos contenedores están en ejecución
docker compose ps

# Revisa los logs de Postgres en busca de errores
docker compose logs db

# Revisa los logs de PGAdmin
docker compose logs pgadmin
Aspecto de éxito: docker compose ps muestra pgvector_db y pgadmin4 como “Up”. El servicio db debería mostrar (healthy) en la columna de estado tras unos segundos.
Aspecto de fallo: si db muestra “unhealthy” o se reinicia constantemente, revisa docker compose logs db. Las causas comunes son que el puerto 5432 ya esté en uso en el host, o un volumen de datos de una instalación previa de Postgres con configuración incompatible.
Para más comandos de Docker y resolución de problemas, consulta comandos esenciales de Docker.
Si te interesa monitorizar recursos del servidor como CPU, memoria y espacio en disco, puedes consultar: Cómo monitorizar recursos del servidor y de Docker
Acceder a PGAdmin y conectar con pgvector
- Abre tu navegador en
http://your-vps-ip:5016. - Inicia sesión con el
PGADMIN_DEFAULT_EMAILy elPGADMIN_DEFAULT_PASSWORDde tu archivo.env. - En PGAdmin, haz clic derecho en Servers en el panel izquierdo → Register → Server.
- En la pestaña General, dale un nombre (por ejemplo, “pgvector”).
- En la pestaña Connection, completa:
- Host name/address:
pgvector_db(el nombre del contenedor, Docker lo resuelve por la red interna) - Port:
5432 - Username: el valor de
POSTGRES_USERde tu.env - Password: el valor de
POSTGRES_PASSWORDde tu.env
- Host name/address:
- Haz clic en Save. La base de datos debería aparecer en el panel de navegación de PGAdmin.
Verifica: abre una Query Tool (clic derecho en la base de datos → Query Tool) y ejecuta SELECT version(); para confirmar la versión de Postgres.
Layouts de workspace en PGAdmin 9.x
PGAdmin 9.x usa layouts de Workspace por defecto. Si prefieres la interfaz clásica, cámbiala desde el menú de usuario en la esquina superior derecha.
Después del despliegue: verifica pgvector y crea tu primer índice
El artículo original se detenía en el «despliegue». Eso no es suficiente. Necesitas confirmar que pgvector realmente funciona y entender cómo indexar tus datos para cargas de trabajo reales.
Verifica que la extensión pgvector funciona
Abre una Query Tool en PGAdmin (o ejecuta vía docker compose exec db psql -U pguser -d vectors) y ejecuta:
-- Activa la extensión (primera vez por base de datos)
CREATE EXTENSION IF NOT EXISTS vector;

-- Comprueba la versión
SELECT extversion FROM pg_extension WHERE extname = 'vector';
-- Debería devolver '0.8.5' o similar

-- Prueba una operación vectorial simple
SELECT '[1,2,3]'::vector <-> '[4,5,6]'::vector AS distance;
-- Debería devolver: 5.196152422706632
Si la consulta de versión devuelve un valor >= 0.8.2 y la consulta de distancia devuelve un número, pgvector está operativo.
Crea un índice HNSW para búsqueda por similitud rápida
Para cualquier caso de uso real, necesitas un índice. Sin uno, pgvector hace un escaneo secuencial en cada consulta. Bien para 100 filas, terrible para 100.000.
-- Crea una tabla con una columna vectorial
CREATE TABLE items (
    id bigserial PRIMARY KEY,
    content text,
    embedding vector(1536)  -- Dimensión de ada-002 de OpenAI
);

-- Índice HNSW (recomendado para la mayoría de casos)
CREATE INDEX ON items USING hnsw (embedding vector_cosine_ops);

-- Para producción en tablas grandes: crea el índice concurrentemente para no bloquear escrituras
CREATE INDEX CONCURRENTLY ON items USING hnsw (embedding vector_cosine_ops);

-- Aumenta maintenance_work_mem para compilaciones de índices más rápidas
SET maintenance_work_mem = '2GB';
HNSW vs IVFFlat: ¿qué índice deberías usar?
| HNSW | IVFFlat | |
|---|---|---|
| Rendimiento de consultas | Mejor | Menor |
| Velocidad de compilación | Más lenta (pero paralela desde 0.6.0) | Más rápida |
| Memoria durante la compilación | Mayor | Menor |
| Funciona en tabla vacía | Sí | No, necesita datos primero |
| Opción por defecto | Sí — usa este | Solo si el tiempo/memoria de compilación es el cuello de botella |
Recomendación por defecto: usa HNSW. Es la mejor opción para casi cualquier carga de trabajo. IVFFlat solo merece la pena considerarse con un dataset muy grande donde el tiempo de compilación del índice sea el cuello de botella y puedas tolerar una precisión de consulta ligeramente menor.
Compilaciones paralelas de HNSW en pgvector 0.6.0+
pgvector 0.6.0+ soporta compilaciones paralelas de índices HNSW, hasta 30 veces más rápidas que antes. El ajuste shm_size: '256mb' del archivo compose garantiza que esto funcione correctamente en Docker. Si aumentas maintenance_work_mem por encima de 256 MB, sube shm_size a la par.
¿Qué pasa con pgvectorscale y DiskANN?
La extensión pgvectorscale de TimescaleDB añade indexación StreamingDiskANN con Cuantización Binaria Estadística (SBQ) sobre pgvector. Para cargas de trabajo que necesitan mayor escala de la que ofrece pgvector nativo, vale la pena evaluarla.
CREATE EXTENSION IF NOT EXISTS vectorscale CASCADE;
CREATE INDEX ON items USING diskann (embedding vector_cosine_ops);
Los benchmarks publicados sugieren una latencia p95 28 veces menor y un throughput 16 veces mayor frente al índice s1 de Pinecone con un recall del 99 %, a un 75 % menos de coste autoalojado. No es necesario para la mayoría de los setups, pero es la vía de actualización cuando te quedes corto con el HNSW básico.
Configura Cloudflare Tunnel para acceso remoto seguro
En lugar de abrir el puerto de PGAdmin directamente a internet, puedes exponerlo a través de un Cloudflare Tunnel. Esto te da SSL, protección DDoS y políticas de Cloudflare Access — sin exponer la dirección IP de tu VPS.
- En el panel de Cloudflare, ve a Access → Tunnels.
- Selecciona tu túnel existente (o crea uno nuevo).
- Añade un hostname que mapee tu subdominio (por ejemplo,
pgadmin.yourdomain.com) al serviciohttp://localhost:5016. - Guarda y espera a que el túnel se conecte.
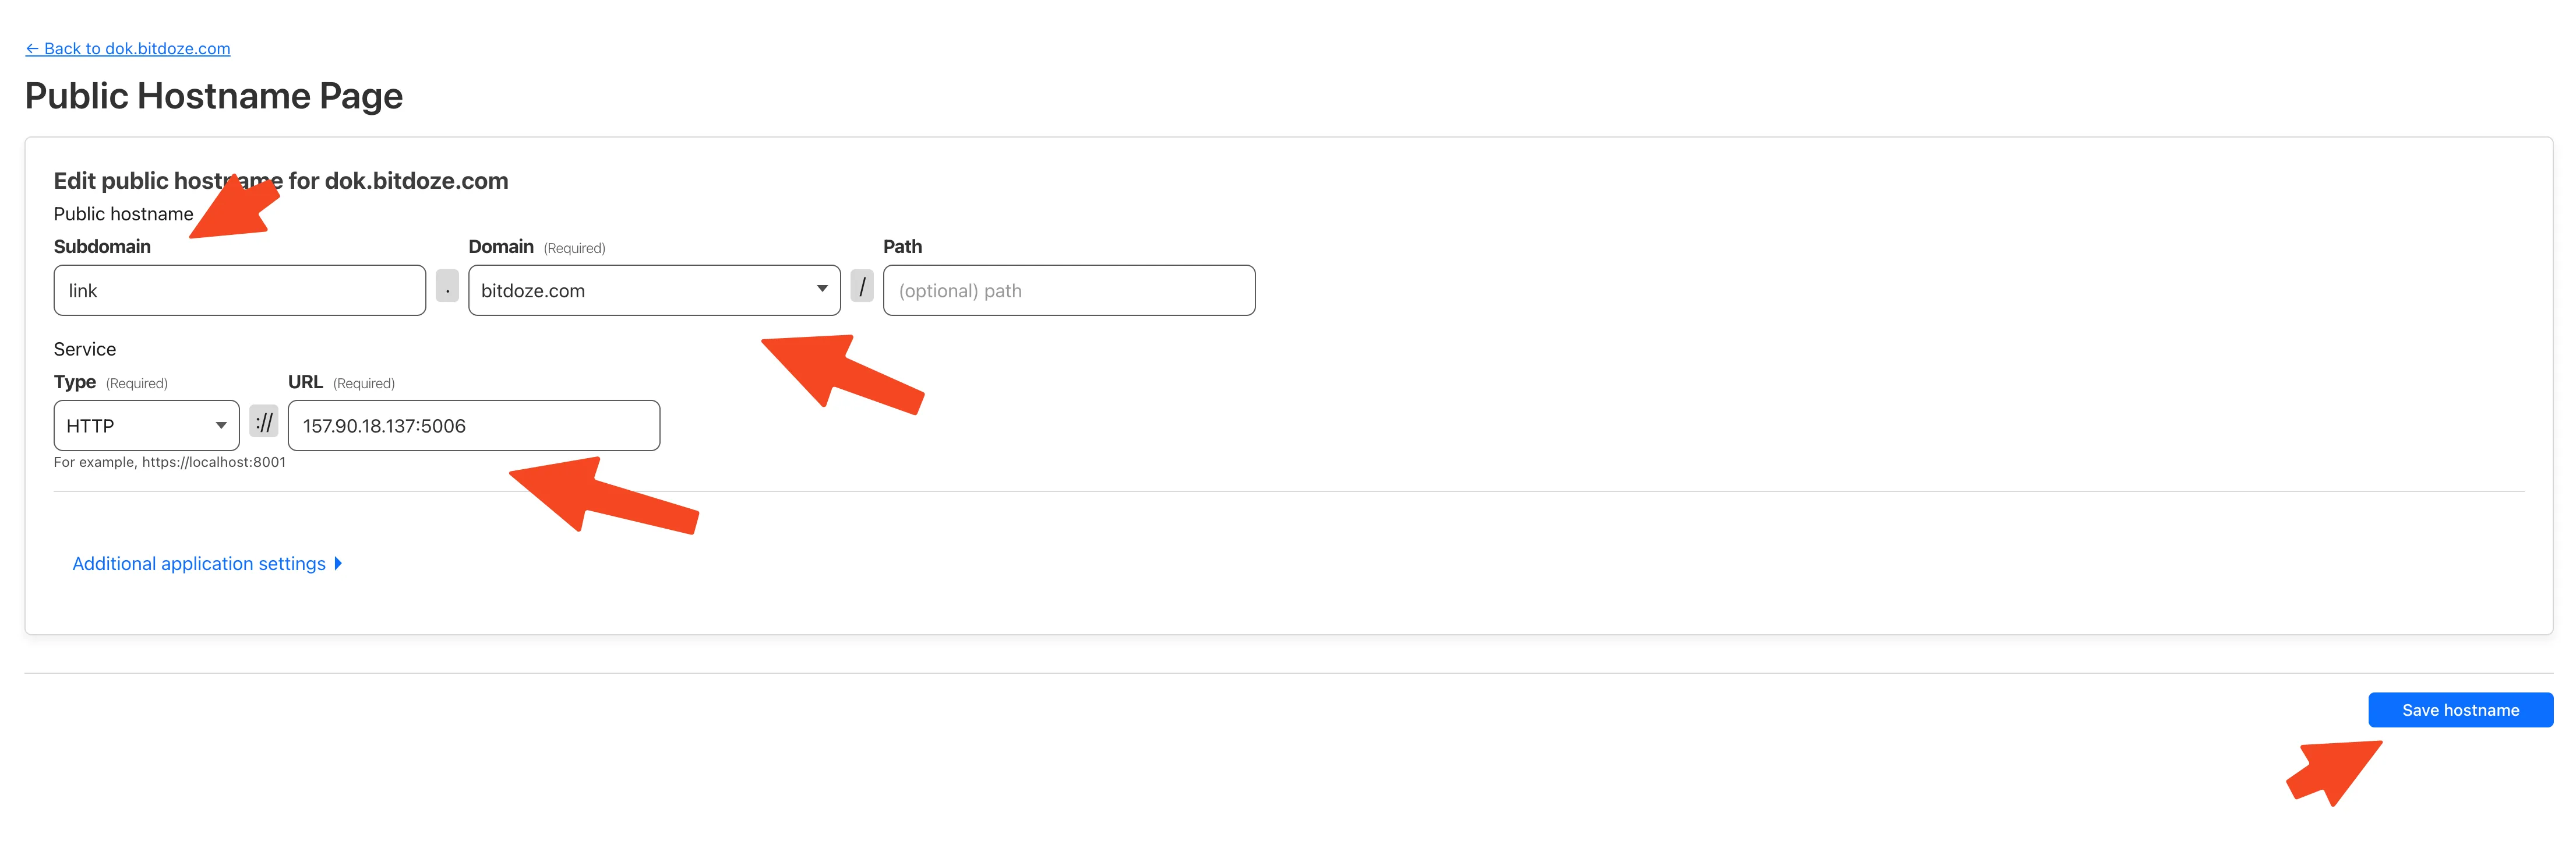
Una vez activo el túnel, accede a PGAdmin en https://pgadmin.yourdomain.com con protección completa de Cloudflare.
Proxies inversos alternativos
También puedes configurar Traefik como proxy inverso o usar CloudPanel como proxy inverso con Docker en lugar de Cloudflare Tunnel. Elige el que encaje en tu stack.
Mejores prácticas de seguridad para tu setup de pgvector en Docker
El archivo compose actualizado ya resuelve los mayores problemas de seguridad del artículo original. Aquí está el panorama completo:
Elimina POSTGRES_HOST_AUTH_METHOD=trust
Ya está hecho en el archivo compose actualizado. El archivo antiguo incluía este ajuste, que desactivaba por completo la autenticación por contraseña. Cualquiera que pudiera alcanzar el puerto 5432 podía conectarse sin credenciales. Si migras desde el setup antiguo, verifica que POSTGRES_PASSWORD esté definido y actualiza cualquier cadena de conexión.
Asocia Postgres a localhost
El archivo compose asocia 127.0.0.1:5432:5432 en lugar de 0.0.0.0:5432:5432. PGAdmin se conecta por la red interna de Docker (no por el puerto del host), así que esto solo afecta al acceso externo. Si necesitas alcanzar Postgres desde otro servidor, usa túneles SSH o una VPN.
Usa contraseñas fuertes y protege tu .env
No uses pass ni pgpass como contraseña de Postgres. Genera cadenas aleatorias:
# Genera una contraseña aleatoria
openssl rand -base64 32
Añade .env a .gitignore. Para producción, considera proteger tus credenciales de Docker Compose con Docker secrets o un vault.
Mantén pgvector actualizado
CVE-2026-3172: corrección de seguridad crítica
pgvector 0.8.0–0.8.1 tenía una vulnerabilidad de desbordamiento de búfer en el heap (CVE-2026-3172) en las compilaciones paralelas de índices HNSW. Se corrigió en 0.8.2. El tag pgvector/pgvector:pg17 incluye actualmente la 0.8.5, que es segura. Si estás ejecutando una versión anterior, actualiza inmediatamente:
docker compose pull && docker compose up -dComprueba periódicamente si hay actualizaciones. El tag pgvector/pgvector:pg17 sigue la última versión de pgvector para PostgreSQL 17. Un docker compose pull && docker compose up -d te trae el último parche.
Haz backup de tu base de datos vectorial
El artículo original no mencionaba los backups. Para una base de datos autoalojada, esto es crítico.
# Backup de una sola base de datos
docker compose exec db pg_dump -U pguser vectors > backup_$(date +%F).sql

# Backup del cluster completo (todas las bases de datos)
docker compose exec db pg_dumpall -U pguser > full_backup_$(date +%F).sql

# Restaurar desde backup
docker compose exec -T db psql -U pguser vectors < backup_2026-07-21.sql
Para backups automatizados, añade pg_dump a un cron job y sincroniza la salida con almacenamiento compatible con S3. El directorio del volumen ./local_pgdata también se puede respaldar directamente — pero detén primero el contenedor para una instantánea consistente, o usa pg_dump para un backup en caliente.
Nunca respaldes el directorio de datos en crudo mientras Postgres está en ejecución
Las copias a nivel de archivo de ./local_pgdata mientras Postgres está activo pueden producir instantáneas inconsistentes. Usa pg_dump para backups en caliente, o docker compose stop db antes de copiar el volumen.
Escalando más allá de lo básico: halfvec, pgvectorscale y más
Una vez que tengas el setup básico funcionando, pgvector tiene varias palancas para cuando tu carga de trabajo crezca:
Tipo halfvec (pgvector 0.7.0+) — almacena vectores a media precisión: 2 bytes por dimensión en lugar de 4. Los embeddings de 1536 dimensiones de OpenAI pasan de ~6 KB a ~3 KB cada uno. Reduce a la mitad los costes de almacenamiento y memoria.
Tipo sparsevec (pgvector 0.7.0+) — vectores dispersos para datos de alta dimensión donde la mayoría de los valores son cero. Útil para embeddings de búsqueda de texto que usan representaciones dispersas.
Cuantización binaria vía binary_quantize() — comprime vectores a 1 bit por dimensión. Ahorro masivo de almacenamiento a costa de algo de precisión en el recall. Buena para un filtrado inicial antes de un paso de reranking más preciso.
Ajuste de ef_search — parámetro de HNSW que cambia velocidad de consulta por precisión de recall. Valores más altos = mejor recall, consultas más lentas. El valor por defecto es 40; súbelo a 100+ para requisitos críticos de precisión.
Instalar pgvectorscale junto a pgvector
Para cargas de trabajo de mayor escala, pgvectorscale de TimescaleDB añade indexación StreamingDiskANN:
CREATE EXTENSION IF NOT EXISTS vectorscale CASCADE;
CREATE INDEX ON items USING diskann (embedding vector_cosine_ops);
Se instala junto a pgvector (el flag CASCADE maneja las dependencias). DiskANN está diseñado para datasets de decenas de millones de vectores donde el uso de memoria de HNSW se vuelve prohibitivo.
Conclusión
Ahora tienes una base de datos vectorial autoalojada ejecutando PostgreSQL 17 con pgvector 0.8.5, administrada mediante una interfaz web de PGAdmin — todo en Docker Compose. Coste total: lo que te cueste tu VPS (€5–15/mes en Hetzner o Hostinger VPS). Sin cargos por consulta, sin dependencia del proveedor, sin sorpresas en los precios.
Empieza con el setup básico. Verifica que la extensión funciona, crea un índice HNSW y ejecuta algunas consultas de similitud. Cuando te quedes corto con lo básico, recurre a halfvec o pgvectorscale.
Por cierto, pgvector es solo un reemplazo más. Qué puede reemplazar Postgres en 2026 cubre caché, búsqueda, colas y cron con el mismo enfoque de trade-offs.
Si estás construyendo tu stack autoalojado, explora más contenedores Docker autoalojados para tu servidor casero o echa un vistazo a los paneles de gestión de servidores autoalojados para administrar múltiples servicios.
Consigue un VPS y empieza