Sed Borrar Líneas: Técnicas Avanzadas y Ejemplos Prácticos
Domina el comando sed para borrar líneas: elimina líneas por número, patrón y rango, evita las trampas de GNU vs BSD y limpia archivos de log con seguridad. Ejemplos actualizados 2026.

Actualizado Publicado 39 min de lectura
El comando sed para borrar líneas (sed 'Nd') elimina líneas específicas de archivos de texto en segundos. Borra una línea por número, un rango de líneas, o cualquier línea que coincida con un patrón. Esta guía cubre cada técnica de borrado de líneas con sed, más los gotchas de GNU vs BSD sed y las trampas de la edición in-place que muerden en producción. Cada comando de abajo fue verificado en GNU sed 4.9.
GNU sed vs BSD sed, y versiones
Todos los ejemplos fueron verificados en GNU sed 4.9, la versión que traen Debian y Ubuntu stable actuales. GNU sed 4.10 (abril 2026) es la última release: arregla pánicos en líneas de más de 2GB y una condición de carrera de seguridad de --follow-symlinks -i. macOS trae BSD sed, que no tiene direcciones de paso ~ y una sintaxis de -i distinta:
- GNU sed:
sed -i.bak '...' file - BSD sed (macOS):
sed -i '.bak' '...' file(el argumento de sufijo de backup es obligatorio)
Corre sed --version primero. Si da error, estás en BSD sed. La sección de edición in-place de abajo muestra el enfoque portable con archivo temporal que funciona en todas partes.
¿Qué es sed y por qué usarlo para borrar líneas?
sed (Stream Editor) es una utilidad de línea de comandos para filtrar y transformar texto en sistemas tipo Unix. Encaja bien para borrar líneas porque procesa el texto línea a línea en vez de cargar archivos enteros en memoria.
Por qué se gana un hueco en tu toolkit:
- No interactivo: los cambios ocurren sin abrir un editor, que es lo que quieres en scripts, cron jobs y pipelines de CI
- Apunte flexible: números de línea (
5d), rangos (10,20d), patrones (/error/d) o expresiones regulares completas - Barato en recursos: memoria constante sin importar el tamaño del archivo, rápido incluso en logs de varios GB
- Componible: se lleva bien con pipes,
grep,awky redirecciones - En todas partes: disponible en prácticamente cualquier sistema tipo Unix
Esta guía es parte de una serie de sed en cuatro partes:
- Borrar líneas usando el comando
d(esta guía) - Insertar o añadir texto con los comandos
iya - Cambiar mayúsculas del texto para estandarización
- Buscar y reemplazar texto con coincidencia de patrones
Sintaxis básica de sed para borrar líneas
La estructura combina una dirección (qué líneas apuntar) con el comando de borrado (d).
sed 'ADDRESS d' filename- ADDRESS: especifica qué líneas borrar
- d: el comando de borrado
- filename: archivo objetivo (o stdin si se omite)
Métodos de direccionamiento
1. Números de línea:
sed '5d' file.txt          # Delete line 5
sed '1d' file.txt          # Delete first line
sed '$d' file.txt          # Delete last line
2. Rangos de líneas:
sed '2,5d' file.txt        # Delete lines 2-5
sed '10,$d' file.txt       # Delete from line 10 to end
sed '1,3d' file.txt        # Delete first 3 lines
3. Coincidencia de patrones:
sed '/error/d' file.txt    # Delete lines containing "error"
sed '/^#/d' file.txt       # Delete lines starting with #
sed '/^$/d' file.txt       # Delete empty lines
4. Expresiones regulares:
sed '/^[0-9]/d' file.txt   # Delete lines starting with digits
sed '/\.log$/d' file.txt   # Delete lines ending with .log
Opciones clave
| Opción | Función | Ejemplo |
|---|---|---|
-i |
Edita archivos in-place | GNU: sed -i '1d' file.txt / BSD: sed -i '' '1d' file.txt |
-i.bak |
Edita in-place con backup | GNU: sed -i.bak '1d' file.txt / BSD: sed -i '.bak' '1d' file.txt |
-n |
Suprime la salida por defecto | Se usa con el comando p |
Antes que nada, corre sed --version. En GNU sed imprime la versión (4.9 o 4.10 en sistemas actuales). En macOS falla con un error illegal option, lo que te dice que cada ejemplo solo-GNU de esta guía necesita la variante portable.
Flujo de ejecución
sed opera en un ciclo simple: lee una línea al pattern space, aplica comandos y saca el resultado. El comando d cortocircuita ese ciclo: la línea nunca llega a la salida y sed salta directo a la siguiente línea.
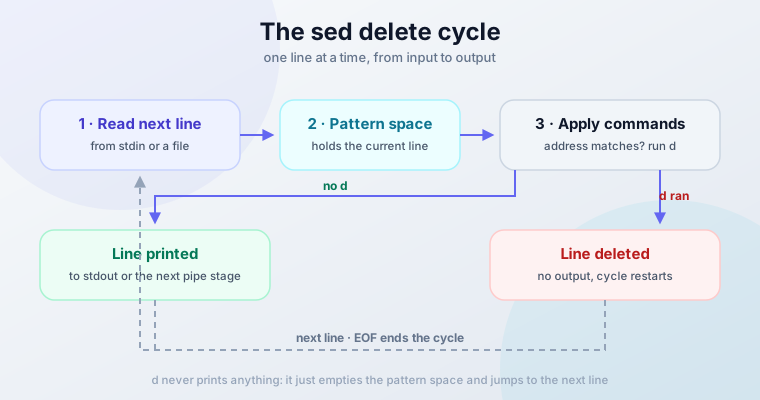
Como sed procesa una línea cada vez, el uso de memoria se mantiene constante sin importar lo grande que sea el archivo. Un log de varios GB recibe el mismo tratamiento que un config de 10 KB.
Verifica sobre la marcha: sin -i, sed imprime a stdout y no toca nada. Esa previsualización es tu primera comprobación de seguridad, y es gratis.
Borrando líneas específicas
sed apunta a líneas específicas a través de su sistema de direccionamiento.
Borrar por número de línea
sed '2d' filename          # Delete line 2
sed '1d' filename          # Delete first line
sed '$d' filename          # Delete last line
Múltiples líneas concretas:
sed '1d;3d;5d' filename    # Delete lines 1, 3, and 5
sed -e '2d' -e '5d' filename # Alternative syntax
Borrar rangos de líneas
sed '10,20d' filename      # Delete lines 10-20
sed '1,5d' filename        # Delete first 5 lines
sed '10,$d' filename       # Delete from line 10 to end
Ejemplos prácticos:
sed '1d' config.txt        # Remove header line
sed '$d' data.txt          # Remove footer/last line
sed '2,4d' log.txt         # Remove lines 2-4
Borrar las últimas N líneas
sed no tiene sintaxis $-2,$d, así que “borrar las últimas 3 líneas” necesita otra herramienta o un truco:
head -n -3 file.txt                 # GNU coreutils head (Linux)
tac file.txt | sed '1,3d' | tac     # Portable: works on macOS/BSD too
head -n -3 imprime todo menos las últimas 3 líneas, pero los conteos negativos son una extensión GNU. La receta con tac invierte el archivo, borra las (ahora) primeras 3 líneas y lo invierte de vuelta. Ambas imprimen a stdout, así que redirige a un archivo nuevo y compara antes de reemplazar el original.
Borrar por coincidencia de patrón
El borrado por patrón merece su propia sección: mira Borrado de líneas por patrón con expresiones regulares abajo para el tratamiento completo.
Seguridad y pruebas
Previsualiza los cambios primero:
sed '2d' file.txt             # Shows output without modifying file
sed '2d' file.txt > new.txt   # Save to new file
Edición in-place con backup:
# GNU sed (Linux)
sed -i.bak '2d' file.txt      # Creates file.txt.bak

# BSD sed (macOS)
sed -i '.bak' '2d' file.txt   # Creates file.txt.bak
La sección de in-place de abajo cubre los modos de fallo (-i es menos inocente de lo que parece).
Prueba con números de línea:
nl file.txt | sed '2d' # Show line numbers to verify targetingCasos de uso prácticos
- Limpieza de logs:
sed '/DEBUG/d' app.log. Si los logs viven en Docker, redirige los logs de Docker a un solo archivo primero, luego recorta las líneas DEBUG y de error con sed - Archivos de configuración:
sed '/^#/d' nginx.conf - Procesamiento de datos:
sed '1d' data.csv(quita el header del CSV) - Limpieza de código:
sed '/^\/\//d' script.js(quita comentarios JS)
Borrado de líneas por patrón con expresiones regulares
La coincidencia de patrones es donde sed se gana el sueldo: borra cualquier línea que coincida con un patrón, no solo líneas en una posición fija.
Coincidencia de patrones básica
sed '/error/d' filename       # Delete lines containing "error"
sed '/warning/d' logfile.txt  # Delete lines with "warning"
sed '/DEBUG/d' app.log        # Delete debug messages
La coincidencia es sensible a mayúsculas: /error/ no coincide con Error. Mira la sección de insensible a mayúsculas abajo para la forma portable y el atajo GNU.
Quitar líneas vacías (incluidos archivos CRLF)
La receta clásica:
sed '/^$/d' filename              # Delete empty lines
sed '/^[[:space:]]*$/d' filename  # Delete blank lines, including whitespace-only
Aquí está la trampa: si un archivo pasó por Windows, las líneas “vacías” a menudo contienen solo un carriage return (\r). sed '/^$/d' no las borra, porque la línea no está vacía, contiene \r. La versión con clase POSIX sí las atrapa:
sed '/^[[:space:]]*$/d' win-file.txt # CRLF-safe: \r is in the POSIX space classGNU sed también acepta sed '/^\r$/d' para exactamente el caso de solo \r, pero es una extensión GNU. Quédate con la clase [:space:], es portable.
Verifica con qué estás lidiando: cat -A file.txt | head muestra $ en los finales de línea y ^M$ en las líneas CRLF.
Coincidir solo palabras completas
Borrar cada línea que contiene err cuando querías error es una mala tarde. Los límites de palabra lo arreglan, pero la sintaxis difiere entre implementaciones:
GNU (Linux)
sed '/\berror\b/d' file.txt\b, \< y \> funcionan como extensiones GNU.
BSD (macOS)
sed '/[[:<:]]error[[:>:]]/d' file.txtBSD sed no conoce \b pero soporta [[:<:]] y [[:>:]] como corchetes de límite de palabra.
Portable en todas partes
sed -E '/(^|[^[:alnum:]_])error([^[:alnum:]_]|$)/d' file.txtEsto define “palabra” como [A-Za-z0-9_] usando solo constructos POSIX. Verboso, pero corre sin cambios en GNU, BSD y otras implementaciones de sed. Si solo te importan los límites por espacios en blanco, el más corto sed -E '/(^|[[:space:]])error([[:space:]]|$)/d' también funciona.
Borrado insensible a mayúsculas: /error/Id vs portable
sed '/[Ee]rror/d' file.txt   # Portable: matches "Error" or "error"
sed '/error/Id' file.txt     # GNU only: cleaner, handles all casing
El modificador I tras el patrón hace la coincidencia insensible a mayúsculas. GNU sed lo soporta; BSD sed no. En macOS, o extiendes la clase de corchetes (que se vuelve fea rápido para mayúsculas completas) o instalas GNU sed con brew install gnu-sed y usas gsed.
Clases de caracteres y anclas
sed '/[0-9]/d' filename       # Delete lines containing any digit
sed '/[A-Z]/d' filename       # Delete lines with uppercase letters
sed '/^error/d' filename      # Delete lines starting with "error"
sed '/error$/d' filename      # Delete lines ending with "error"
Cuantificadores:
sed '/[0-9]\{3\}/d' filename     # Delete lines with 3+ consecutive digits
sed '/^.\{80,\}/d' filename      # Delete lines longer than 80 chars
sed '/error.*critical/d' file    # "error" followed by "critical"
Patrones de comentarios
sed '/^#/d' config.txt            # Delete lines starting with #
sed '/^[[:space:]]*#/d' file.txt  # Delete comments with leading whitespace
sed '/^\/\//d' script.js          # Delete JavaScript comments
sed '/^\/\*/d' style.css          # Delete CSS comment starts
Patrones complejos
sed '/^[0-9]\{4\}-[0-9]\{2\}-[0-9]\{2\}/d' file.txt # Delete date lines (YYYY-MM-DD)Líneas con forma de email: usa -E y un + plano:
sed -E '/^[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+\.[a-zA-Z]{2,}/d' file.txtTambién lo verás escrito con \+ ([a-zA-Z0-9._%+-]\+@...). Eso es una extensión BRE de GNU; la forma con -E es la portable.
Negación: quedarse solo con las líneas coincidentes
El ! invierte la dirección, así que d borra todo lo que no coincide:
sed '/success/!d' filename    # Keep only lines with "success"
sed '/^#/!d' config.txt       # Keep only comment lines
sed '/error/!d' log.txt       # Keep only error lines
Para quedarte con varios niveles de log, usa regex extendida (portable) en vez de alternación BRE (solo GNU):
sed -E '/INFO|WARN|ERROR/!d' log.txt   # Portable: keep only these levels
sed '/INFO\|WARN\|ERROR/!d' log.txt    # [GNU only] BRE \| alternation
Expresiones regulares extendidas
-E cambia a ERE: nada de backslashes en +, ?, | o grupos. Es portable entre GNU y BSD; GNU también acepta el alias más viejo -r.
sed -E '/^[0-9]{3}-[0-9]{3}-[0-9]{4}$/d' file.txt    # Delete phone numbers
sed -E '/^(http|https):/d' urls.txt                   # Delete HTTP URLs
sed -E '/^[A-Z]{2,}/d' file.txt                       # Lines starting with 2+ caps
Ejemplos prácticos
Limpieza de archivos de log:
sed '/INFO/d' app.log         # Remove info messages
sed '/^\[.*DEBUG.*\]/d' log   # Remove debug entries
sed '/^$/d' access.log        # Remove empty lines
Archivos de configuración:
sed '/^#/d' nginx.conf        # Remove comments
sed '/^[[:space:]]*$/d' config.ini  # Remove blank lines
Procesamiento de datos: si tu fuente es un PDF, extrae texto de un PDF en la línea de comandos de Linux con pdftotext, luego pásalo por sed para quitar líneas vacías y de header antes de seguir procesando:
pdftotext report.pdf - | sed -e '/^$/d' -e '/^Page [0-9]/d' > report.txtSeguridad y pruebas
Previsualiza lo que se va a borrar:
grep 'pattern' filename | head    # See matching lines
sed -n '/pattern/p' filename      # Print matches without deleting
Comprueba los números de línea para contexto:
nl filename | sed '/pattern/d' | headErrores comunes a evitar:
- Olvidar escapar caracteres especiales:
/./dcoincide con cada línea no vacía,/\./dcoincide con puntos literales - Sensibilidad a mayúsculas:
sed '/Error/d'se pierdeerror. Usa[Ee]rrorde forma portable o/error/Ien GNU - Patrones demasiado amplios:
/log/dtambién matalogin,catalog,logger. Usa límites de palabra
Técnicas avanzadas de borrado de líneas
Más allá de coincidencias de una línea, sed maneja rangos, bloques multilínea y decisiones basadas en líneas vecinas.
Borrado por rangos de patrones
sed '/START/,/END/d' file.txt         # Delete from START to END markers
sed '/BEGIN/,/FINISH/d' config.txt    # Delete configuration blocks
sed '/<!--/,/-->/d' html.txt          # Delete HTML comments
sed '/ERROR/,10d' file.txt            # Delete from first ERROR to line 10
sed '5,/STOP/d' file.txt              # Delete from line 5 to first STOP after it
sed '/FOOTER/,$d' file.txt            # Delete from FOOTER to end
Los rangos se reabren, y los rangos sin cerrar corren hasta el final del archivo
Dos de estos son fáciles de liar. Ambos están documentados y verificados en GNU sed:
1. Cada coincidencia posterior del patrón de inicio reabre el rango. En un archivo con ERROR en las líneas 3 y 12, sed '/ERROR/,10d' borra las líneas 3-10 y luego la línea 12 por su cuenta. El manual es explícito: si la segunda dirección es un número menor o igual que la línea que coincide con la primera dirección, el rango coincide solo con esa única línea. Así que “borra el primer bloque ERROR hasta la línea 10” borra silenciosamente también líneas ERROR sueltas posteriores.
2. Un patrón de fin que nunca coincide borra hasta el EOF. El patrón de fin solo se comprueba después de que el rango se abre. Si STOP aparece antes de la línea 5, sed '5,/STOP/d' borra de la línea 5 al final del archivo. Lo mismo para sed '/<!--/,/-->/d' en un comentario HTML sin cerrar: verificado que elimina el resto del archivo.
Comprobación de sanidad antes de lanzarlo: corre el rango con p en vez de d y cuenta lo que se come:
sed -n '/ERROR/,10p' file.txt | nl | headBorrado de patrones multilínea
sed '/^$/,/^$/d' file.txt             # Delete empty-line blocks
sed '/^function/,/^}/d' script.js     # Delete JavaScript functions
sed '/^def /,/^$/d' script.py         # Delete Python function definitions
Más formas de direcciones GNU que vale la pena conocer
Tres formas de dirección que hacen el borrado quirúrgico más fácil. Todas son extensiones GNU:
| Dirección | Qué borra | Ejemplo verificado |
|---|---|---|
0,/re/d |
De la línea 1 a la primera re, incluida una coincidencia en la línea 1 |
printf 'A\nB\nEND\nC\n' | sed '0,/END/d' → C |
5,+2d |
La línea 5 más las 2 siguientes (5, 6, 7) | seq 8 | sed '5,+2d' → borra 5, 6, 7 |
6,~4d |
De la línea 6 al siguiente múltiplo de 4 (6, 7, 8) | ejemplo del manual |
La forma 0,/re/ importa: con 1,/END/d, una coincidencia en la línea 1 termina el rango en la segunda coincidencia en su lugar, que rara vez es lo que quieres al recortar un banner inicial.
Usando rangos de direcciones con pasos
Borrar cada línea n:
sed '1~2d' file.txt                   # Delete every odd line (1st, 3rd, 5th...) [GNU only]
sed '2~3d' file.txt                   # Delete every 3rd line starting from line 2 [GNU only]
sed '0~5d' file.txt                   # Delete every 5th line [GNU only]
first~step es una extensión GNU. En macOS falla con sed: 1: '0~5d': invalid command code ~. Para un borrado portable de cada línea n, usa awk: awk 'NR % 5 == 0 {next} {print}' file.txt.
Trabajando con hold space y pattern space
sed tiene dos buffers. El pattern space contiene la línea actual (o varias líneas si añades con N). El hold space es un buffer de repuesto al que puedes copiar desde y hacia con h, H, g, G y x. Para borrar, las técnicas multilínea importan cuando la decisión depende de líneas o bloques adyacentes.
El famoso one-liner de duplicados consecutivos:
sed '$!N; /^\(.*\)\n\1$/d' file.txt # Deletes duplicate pairs, NOT like uniqSabe qué hace esto antes de usarlo: junta cada línea con la siguiente, y cuando son idénticas borra ambas. Con la entrada a\na\n la salida es vacía; con a\na\na\nb\nc\nc\n obtienes a y b, porque la tercera a solitaria se empareja con la b y ambas se imprimen. Eso normalmente no es lo que la gente quiere de un “dedup”.
Para quitar duplicados de verdad, usa uniq (guarda una línea de cada serie) o uniq -u (guarda solo las líneas que nunca se repiten). Ordena primero si los duplicados pueden no ser adyacentes: sort file.txt | uniq.
Borrar una línea según la siguiente línea
Encontrarás este one-liner circulando por ahí:
sed '$!N; /error\n/d' file.txt # BROKEN: deletes nothing usefulNo hace lo que dice. /error\n/ solo coincide cuando la primera línea de un par unido termina en error, y entonces d quita ambas líneas de ese par. En un log realista (a1, ERROR, b1, c1), no borra nada. Verificado.
Aquí están los dos patrones que sí funcionan:
Borrar una línea que contiene ERROR más la línea siguiente:
sed '/ERROR/{N;d}' file.txtCuando una línea coincide con ERROR, N añade la línea siguiente al pattern space, y d borra ambas. Verificado: entrada a1, ERROR, b1, c1 → salida a1, c1.
Borrar una línea solo si la línea siguiente contiene ERROR (un lookahead de verdad). sed se pone feo aquí, y awk es honesto al respecto:
awk 'NR>1 && $0 !~ /ERROR/ {print prev} {prev=$0} END {print prev}' file.txtVerificado: entrada a1, ERROR, b1, c1, ERROR, d1 → salida ERROR, b1, ERROR, d1 (las líneas seguidas de ERROR desaparecen). awk guarda una línea de lookahead en prev y solo la imprime una vez sabe que la siguiente línea es segura.
Operaciones complejas multi-comando
sed -e '/^#/d' -e '/^$/d' -e '/DEBUG/d' file.txt    # Remove comments, empty lines, debug
sed -f delete_script.sed file.txt                    # Or keep the logic in a script
Donde delete_script.sed contiene:
/^#/d
/^$/d
/DEBUG/d
Ejemplos avanzados prácticos
Limpiar archivos de log:
sed -e '/DEBUG/d' -e '/^$/d' -e '/^\[.*\]$/d' app.logProcesar archivos de configuración:
sed -e '/^[[:space:]]*#/d' -e '/^[[:space:]]*$/d' nginx.confLimpieza de código:
sed -e '/^$/d' -e '/^[[:space:]]*\/\//d' -e '/console\.log/d' script.jsPrácticas avanzadas de seguridad
Prueba comandos complejos paso a paso:
sed '/^#/d' file.txt | head -20                                  # Step 1
sed -e '/^#/d' -e '/^$/d' file.txt | head -20                    # Step 2
sed -e '/^#/d' -e '/^$/d' -e '/DEBUG/d' file.txt | head -20      # Step 3
Usa archivos intermedios para operaciones por capas:
sed '/START/,/END/d' file.txt > temp1.txt
sed '/ERROR/d' temp1.txt > temp2.txt
sed '/^$/d' temp2.txt > final.txt
Backups fechados antes de corridas in-place arriesgadas:
cp original.txt original.txt.backup.$(date +%Y%m%d-%H%M%S)
sed -i.bak 'complex_deletion_commands' original.txt
¿Entrada no confiable? El --sandbox de GNU sed deshabilita los comandos e, r y w para que un archivo manipulado no pueda hacer que sed ejecute comandos o escriba archivos:
sed --sandbox '/DEBUG/d' untrusted.log # [GNU only]GNU vs BSD sed: chuleta de portabilidad
La mitad de los one-liners de sed en internet son solo-GNU, y fallan en macOS con errores confusos. Esta matriz mapea cada hueco a una alternativa portable:
| Característica | GNU sed (4.9 / 4.10) | BSD sed (macOS) | Alternativa portable |
|---|---|---|---|
-i in-place con backup |
sed -i.bak '1d' f |
sed -i '.bak' '1d' f (sufijo obligatorio) |
archivo temporal + mv |
Direcciones de paso first~step |
sí (1~2d) |
no: invalid command code ~ |
awk (NR % n) |
Alternación | en BRE |
sí (extensión GNU) | no | sed -E '/a|b/' (pipe ERE) |
\+ uno-o-más en BRE |
sí | no | -E y + plano |
Límites de palabra \b, \<, \> |
sí | no | truco de clase de corchetes o awk |
Límites [[:<:]], [[:>:]] |
no | sí | truco de clase de corchetes |
Modificador /I insensible a mayúsculas |
sí | no | clase de caracteres [Ee]rror |
Dirección 0,/re/ |
sí | no | 1,/re/ (termina en la 2ª coincidencia) o awk |
addr,+N, addr,~N |
sí | no | awk |
-z (entrada separada por NUL) |
sí | no | awk con RS="\0" |
--sandbox, --follow-symlinks, --debug |
sí | no | comprobaciones manuales previas |
$ con múltiples archivos de entrada |
última línea del último archivo (usa -s para por-archivo) |
última línea de cada archivo | prueba primero con una muestra de dos archivos |
--version |
imprime la versión | error: illegal option |
n/a |
Tres hábitos que mantienen los scripts de sed portables:
1. Lint con --posix. Correr sed --posix -f cleanup.sed file.txt hace que GNU sed 4.10+ avise sobre constructos con backslash que GNU acepta pero otros sed no. Forma barata de pillar sintaxis no portable antes de que tu script llegue a una máquina macOS.
2. Fija el locale para texto generado por máquina. Los rangos [A-Z] y [a-z] siguen la collation del locale, y en algunos locales caracteres inesperados caen dentro de un rango. Para logs y configs, prefija con LC_ALL=C:
LC_ALL=C sed '/^[A-Z]/d' app.logLa coincidencia por bytes es predecible, que es lo que quieres para borrado automatizado.
3. Comprueba la versión en CI. Añade sed --version || echo "BSD sed" a la salida de debug de tu pipeline. Las diferencias de comportamiento (especialmente -i y $ entre archivos) son mucho más fáciles de depurar cuando sabes qué sed corrió.
Un edge más: GNU sed preserva un newline final ausente solo mientras la última línea sobrevive. printf 'a\nb\nc' | sed '1d' saca b\nc sin newline final (verificado en 4.9). Borra esa última línea con $d en su lugar, y la nueva línea final obtiene un newline normal, así que printf 'a\nb\nc' | sed '$d' saca a\nb\n. Si tu pipeline hashea o compara la salida byte a byte entre plataformas, prueba en la versión de macOS que uses; se reporta ampliamente que BSD sed añade newlines donde GNU no.
Edición in-place con sed -i: gotchas que muerden en producción
-i parece un flag de conveniencia. Es una operación de reemplazo de archivo, e interactúa mal con hard links, symlinks y el flag -n.
Qué hace -i bajo el capó
GNU sed no edita el archivo. Escribe el resultado a un archivo temporal y lo renombra sobre tu original. El nombre de archivo se queda, pero el inodo cambia:
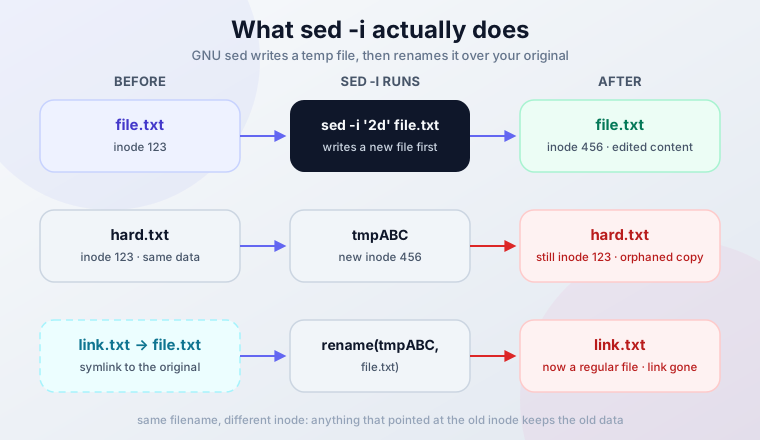
Los hard links se rompen silenciosamente. Comportamiento verificado:
ln orig.txt hard.txt
sed -i '1d' orig.txt
ls -li orig.txt hard.txt
# Both now show link count 1. hard.txt still has the OLD content.
Los symlinks se reemplazan por un archivo regular. Verificado:
ln -s real.conf link.conf
sed -i '1d' link.conf
# link.conf is now a regular file with edited content.
# real.conf is untouched. The symlink is gone.
El arreglo GNU es --follow-symlinks, que edita el destino in-place y preserva el link:
sed -i --follow-symlinks '1d' link.confVale saberlo: --follow-symlinks -i tenía una carrera time-of-check-to-time-of-use que permitía a un atacante cambiar el symlink entre la resolución y la escritura, arreglada en GNU sed 4.10. En máquinas multi-inquilino donde los usuarios pueden escribir en tus directorios temporales, es una razón más para saber qué versión de sed estás corriendo.
Numeración de líneas multi-archivo y $
GNU sed cuenta líneas de forma continua a través de todos los archivos de entrada a menos que pases -i o -s (in-place implica -s):
sed -n '2p' f1.txt f2.txt     # Prints line 2 OVERALL (from f1) only
sed -s -n '2p' f1.txt f2.txt  # Prints line 2 of EACH file
sed -s -i '$d' f1.txt f2.txt  # Deletes the last line of EACH file
Sin -s, $d solo toca la última línea del último archivo. BSD sed reinicia la numeración por archivo por defecto, así que el mismo comando significa cosas distintas en cada plataforma. Verifica con sed -s -n '$=' f1.txt f2.txt (imprime el conteo de líneas de cada archivo) antes de confiar en él.
sed -ni trunca tu archivo a 0 bytes
Este es el clásico bug de pérdida de datos en CI y Ansible:
sed -ni '/DEBUG/d' file.txt # file.txt is now 0 bytes-n suprime la salida. -i escribe de vuelta al archivo lo que no se imprimió. Nada se imprimió, así que el archivo queda vacío. Verificado.
Haz de wc -c file.txt un reflejo tras cualquier corrida con -i. Si ya le hiciste esto a un archivo con un .bak, restaura con mv file.txt.bak file.txt. ¿Sin .bak? Restaura desde tu sistema de backup, esto no es recuperable desde el archivo mismo.
Checklist previo para ediciones in-place
- Previsualiza sin
-iprimero:sed '2d' file.txt | head - Pasa siempre un sufijo de backup:
-i.bak, nunca un-ipelado en scripts - Comprueba
ls -licuando pueda haber hard links o symlinks de por medio - Corre
wc -c file.txttras la edición para confirmar que el archivo no quedó vacío - Guarda el
.bakhasta que le hayas hecho diff contra el resultado
La forma correcta en cada plataforma
GNU (Linux)
sed -i.bak '2d' file.txtCrea file.txt.bak junto al archivo editado.
BSD (macOS)
sed -i '.bak' '2d' file.txtEl sufijo es un argumento obligatorio en BSD sed. Déjalo fuera y sed -i '2d' file.txt trata 2d como el sufijo de backup y file.txt como el script, lo que falla con invalid command code f.
Portable en todas partes
sed '2d' file.txt > file.txt.new && mv file.txt.new file.txtSin -i en absoluto: funciona idéntico en GNU, BSD y todo lo demás, y es casi-atómico cuando el archivo temporal cae en el mismo filesystem. Esto es lo que uso en scripts que deben correr tanto en Linux como en macOS.
Verifica y revierte
diff file.txt.bak file.txt     # See exactly what was removed
mv file.txt.bak file.txt       # Roll back
El diff es el paso de verificación: debería mostrar solo las líneas que pretendías borrar, nada más. Para comprobar ediciones a lo largo de un árbol de configs, mira cómo comparar dos archivos o carpetas en la terminal. Mantén el hábito del backup fechado (cp file.txt file.txt.$(date +%Y%m%d-%H%M%S)) para cualquier cosa que no puedas permitirte perder.
Consideraciones de rendimiento
sed es rápido para un editor de streaming, pero el filtrado puro de líneas es el trabajo de grep, y la diferencia es amplia.
Borrando cada línea que contiene DEBUG de un archivo de ~5 millones de líneas / 69 MB, medido en una máquina Linux con GNU sed 4.9:
| Herramienta | Tiempo | Relativo |
|---|---|---|
grep -v DEBUG |
~4 ms | 1x |
sed '/DEBUG/d' |
~600 ms | ~150x más lento |
awk '/DEBUG/{next} {print}' |
~1.1 s | la más lenta |
Los números absolutos dependen de tu hardware y I/O. El orden no: grep -v fue aproximadamente dos órdenes de magnitud más rápido porque hace una sola cosa, mientras sed carga su motor de direccionamiento completo incluso cuando no lo usas.
La regla de decisión:
| Tarea | Usa |
|---|---|
| Quitar líneas que coinciden con un patrón, salida a stdout | grep -v 'pattern' |
| Borrar por número de línea, rango o múltiples direcciones; editar in-place | sed |
| Lógica consciente de campos, lookaheads, contadores por archivo | awk |
Archivos enormes de una sola línea
En GNU sed 4.9 y anteriores, las operaciones globales sobre líneas de entrada de más de 2GB (JSON minificado, stack traces de una línea) causan un panic y sed sale con código 4. Arreglado en GNU sed 4.10 (abril 2026). Si procesas tales archivos: comprueba sed --version, o usa grep -v/perl para el filtrado, que no tienen el límite.
Conclusión
sed borra líneas por número, rango, patrón o cualquier combinación, procesa archivos de cualquier tamaño con memoria constante, y encaja en cualquier parte desde el history de shell de un uso único hasta pipelines de CI. La diferencia entre una edición sed segura y un incidente de pérdida de datos suele ser un flag que falta.
Puntos clave:
- Empieza simple: los números de línea y patrones básicos cubren la mayoría de necesidades diarias
- Previsualiza sin
-iantes de cada edición in-place, y haz diff al.bakantes de borrarlo - Etiqueta todo lo específico de GNU (
~,\|,\b,/I,0,/re/) y compruebased --versionen cualquier máquina que el script no conozca - Nunca combines
-ncon-i. Esa es la trampa del archivo de 0 bytes - Para filtrado puro,
grep -vle gana a sed por órdenes de magnitud
Cuándo usar alternativas:
- grep -v: exclusión pura por patrón, la opción más rápida para filtrar
- awk: procesamiento por campos, lookaheads, conteo de líneas por archivo
- uniq / uniq -u: eliminación real de duplicados (el truco de sed borra ambas líneas de un par)
- Un editor de texto: borrado interactivo cuando necesitas confirmación visual
Domina el toolkit completo de sed
El resto de la serie de sed:
- Insertar o añadir texto con los comandos
iya - Cambiar mayúsculas del texto para estandarización
- Buscar y reemplazar texto con coincidencia de patrones
FAQ
¿Por qué mi archivo tiene 0 bytes después de sed?
Casi siempre sed -ni. El flag -n suprime la salida y -i escribe de vuelta solo lo que se imprimió, así que el archivo acaba vacío. Restaura desde el .bak si tienes uno (mv file.txt.bak file.txt), si no desde backups. Mira la sección de edición in-place para la lista completa de gotchas de -i y el hábito de correr wc -c tras las ediciones.
¿Funciona sed con JSON minificado de una línea?
Para líneas sueltas de tamaño normal, sí. Pero GNU sed 4.9 y anteriores hacen pánico (código de salida 4) en líneas de más de 2GB durante operaciones globales, y los archivos minificados pueden llegar ahí. GNU sed 4.10 (abril 2026) lo arregló. Para filtrar archivos de una línea, grep -v es a la vez seguro y ~150x más rápido de todos modos.
¿Cómo pruebo un borrado con sed de forma segura?
Tres pasos. Primero, corre el comando sin -i para que solo imprima a stdout. Segundo, pásalo por nl | head para comprobar que apuntas a las líneas correctas. Tercero, córrelo de verdad con -i.bak, luego diff file.txt.bak file.txt para confirmar que el diff muestra solo tus borrados pretendidos. Borra el .bak solo después de que ese diff se vea bien.
¿Importan el hold space y los trucos multilínea para borrar?
Para decisiones de líneas adyacentes, sí: sed '/ERROR/{N;d}' borra una línea más la siguiente, y el pattern space es lo que hace que eso funcione. El hold space solo importa cuando el estado debe sobrevivir entre líneas, que la mayoría de tareas de borrado no necesitan. Si un sed multilínea se vuelve más difícil de razonar que el problema, awk es la herramienta honesta.